字节笔记本
2026年10月24日 · 约 4 分钟读完
712 段对话,16MB:我把三年的 Claude 记录翻了一遍
把 claude.ai 的全量数据导出下载下来,用脚本统计了一遍:2023 年 7 月到 2026 年 6 月,712 段对话,16.7MB。这份档案最有意思的地方不是某段对话,而是它的形状:一次洪峰、一次断崖,和一个悄悄挪走的使用习惯。
先看数据
| 时间 | 对话数 |
|---|---|
| 2023 年(7-12 月) | 20 |
| 2024 年 9 月 | 133 |
| 2024 年 10 月 | 367 |
| 2024 年 11 月 | 159 |
| 2024 年 12 月 | 3 |
| 2025 全年 | 8 |
| 2026 上半年 | 5 |
三个时代一眼可分:2023 年是手动导出的 20 段早期试验,文件名还是“Claude对话_日期”;2024 年秋天是全部体量的 92%;2025 年之后,这份档案基本停止生长。
2024 年 10 月:一个月 367 段
那三个月(9-11 月)加起来 659 段,占全部的 92%。最长的几段对话也都落在这一带:一段 177KB 的“信息卡片组件”、一段 170KB 的“SwiftUI 应用拖拽文件”、一段 154KB 的“用 React 复刻微信商城布局”。
标题抽样能看出那阵子在干什么:微信小程序签到、Next.js 环境变量、私有 Docker 镜像仓库、UniApp 静态页、RLS 行级安全、bolt.new 预览 GitHub 仓库、SwiftUI 悬浮窗 UI……不是在聊天,是在造产品——前端、后端、部署、设计稿,全堆给了 Claude。这批导出也从这时起换成了 Claude 自动生成的英文标题。
三年里,问的东西变了
对全部标题做关键词统计,Top 10 长这样:
| 关键词 | 出现次数 |
|---|---|
| Next.js | 33 |
| WeChat / 小程序 | 35 |
| API | 28 |
| Vue / React | 各 24 |
| RAG | 16 |
| prompt | 16 |
| English / 英语 | 15 |
| UniApp | 12 |
| Docker | 20 |
| Cloudflare | 18 |
2023 年那 20 段是另一个画风:最早的一段(2023-07-11)里我一个字没打,直接丢了个 PDF 附件进去,拿 Claude 当文档阅读器用;还有一段是在分析“中国白酒行业的新秩序与新机会”。三年前把 AI 当资料分析员,三年后让它写组件、配环境、接管终端。
断崖:2025 年之后只剩 13 段
2025 全年 8 段、2026 上半年 5 段。不是不用了,是搬走了:工作流进了终端之后,对话发生在 Claude Code 里,不再沉淀在 claude.ai 的云端存档。档案里唯一的新痕迹很诚实——2026 年 2 月那段对话的标题,是一句 curl https://ai.bytenote.net/v...,我在自己的 API 上做测试。
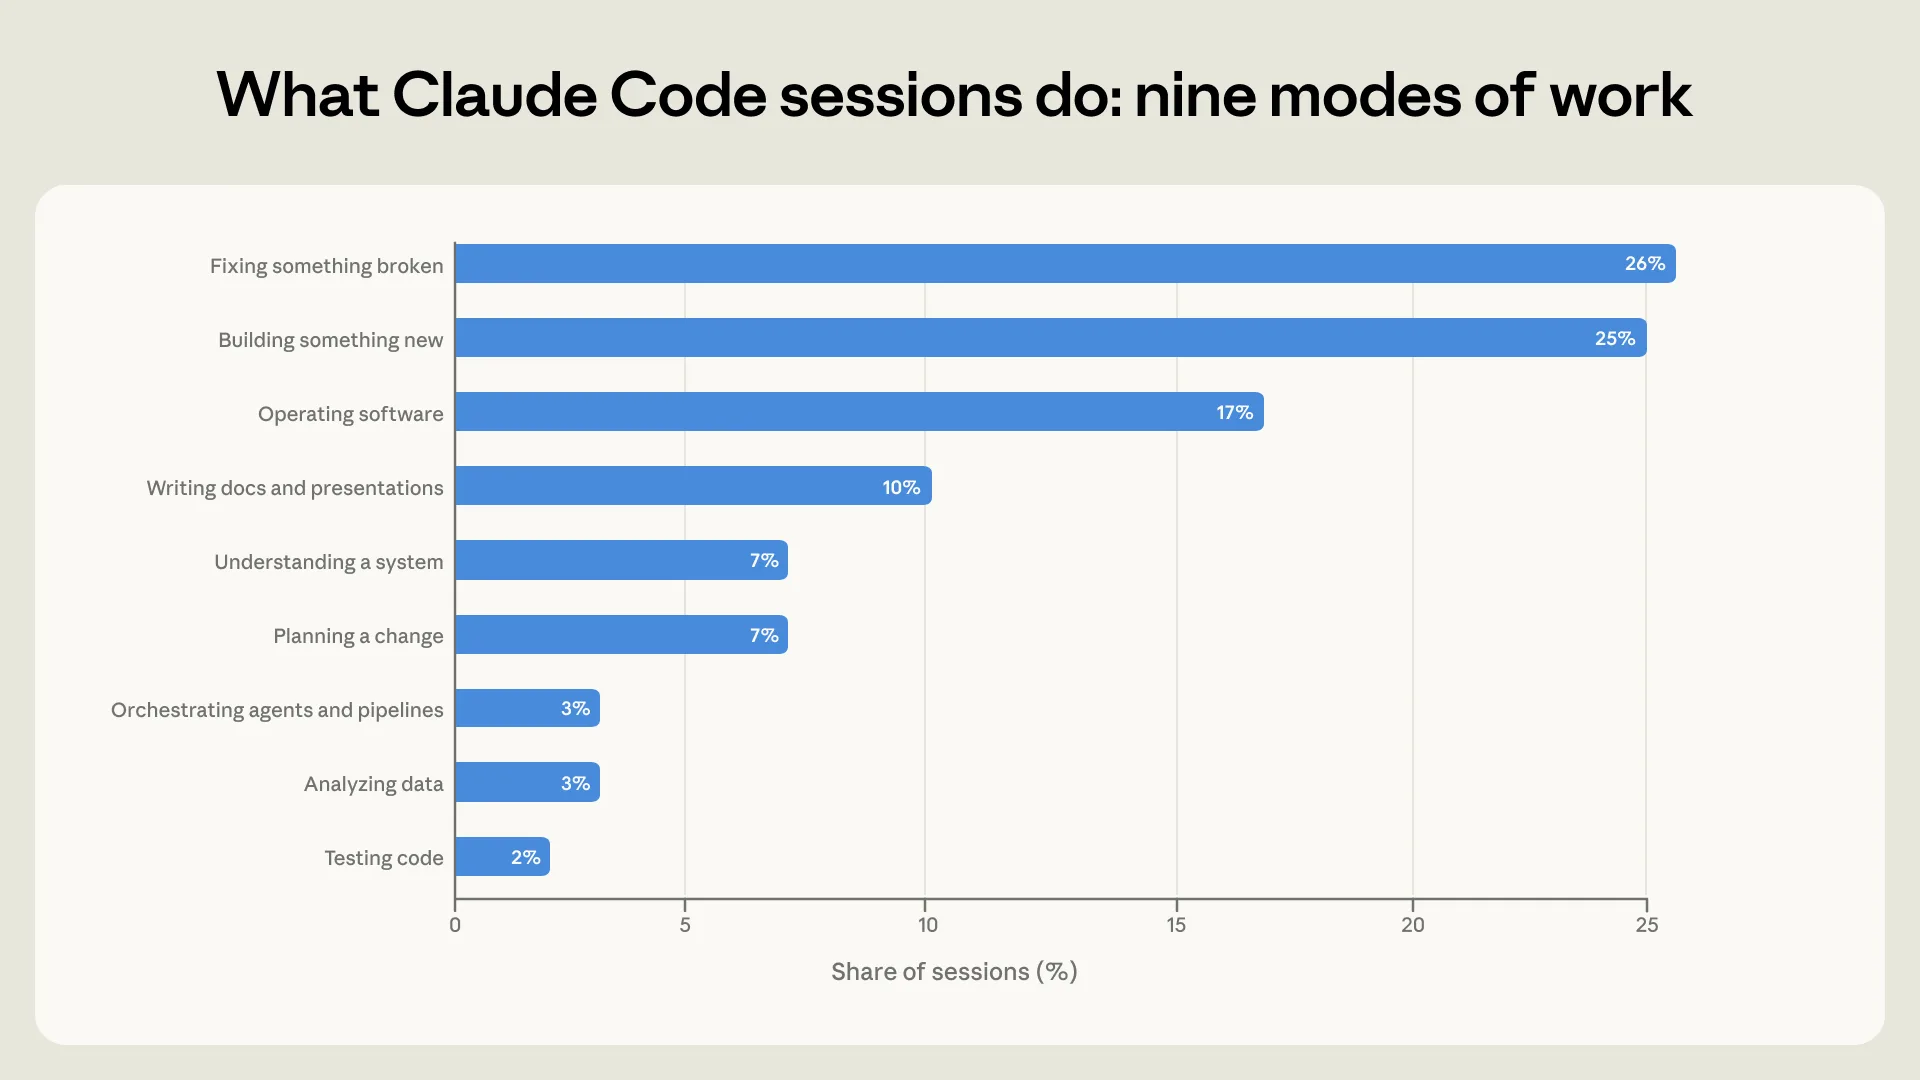
这和 Anthropic 那份 40 万会话研究的结论能对上:使用正从“修修补补”转向端到端的 agent 任务(那篇研究的解读在这里)。区别只是,别人的增长曲线在报告里,我的断崖在导出文件里。
想整理自己存档的
claude.ai 的 Settings 里有 Export data,全量导出是个 zip,对话都在里面。统计方法一句话:按文件名切日期、取每个文件的首行标题、做关键词计数,百来行脚本的事。真正的收获是那份形状——你的 AI 使用记录,就是你这几年的个人史,什么时候开始造东西、什么时候把工作搬进终端,档案不会说谎。
数据来自本人 claude.ai 全量导出(2026-10-24 统计),统计口径:文件名日期 + 各文件首行标题关键词计数。