
字
字节笔记本
2026年10月4日 · 约 3 分钟读完
写一次 CUDA 内核,也能顺手跑在昇腾上
API中转
¥120
高性能内核开发一直是硬核技能:同一份 GEMM 或注意力算子,CUDA 写一遍、ROCm 再写一遍,换张国产卡又得重来。北大团队的 TileLang 一直在推进另一条路:用一门 Python 风格的领域专用语言写一次,编译到多张卡上跑。仓库 tile-ai/tilelang,8.3k stars,编译器基于 TVM 构建,定位是流畅开发 GPU、CPU、NPU 内核(GEMM、反量化 GEMM、FlashAttention、LinearAttention 都在示例射程内)。
项目简介
TileLang 的写法是瓦片级的抽象:T.copy 搬数据,T.gemm 做矩阵乘,T.Pipelined 管流水线,T.Parallel 管并行,共享内存与寄存器片段的分配显式可控。编译器侧配齐了自动调参、warp 特化、TMA 支持与瓦片调度器;调试工具有 Pass 可视化与 IR 下放轨迹,写崩了能看到是哪一步变形。LSP 也已开源,编辑器里能补全。
核心能力
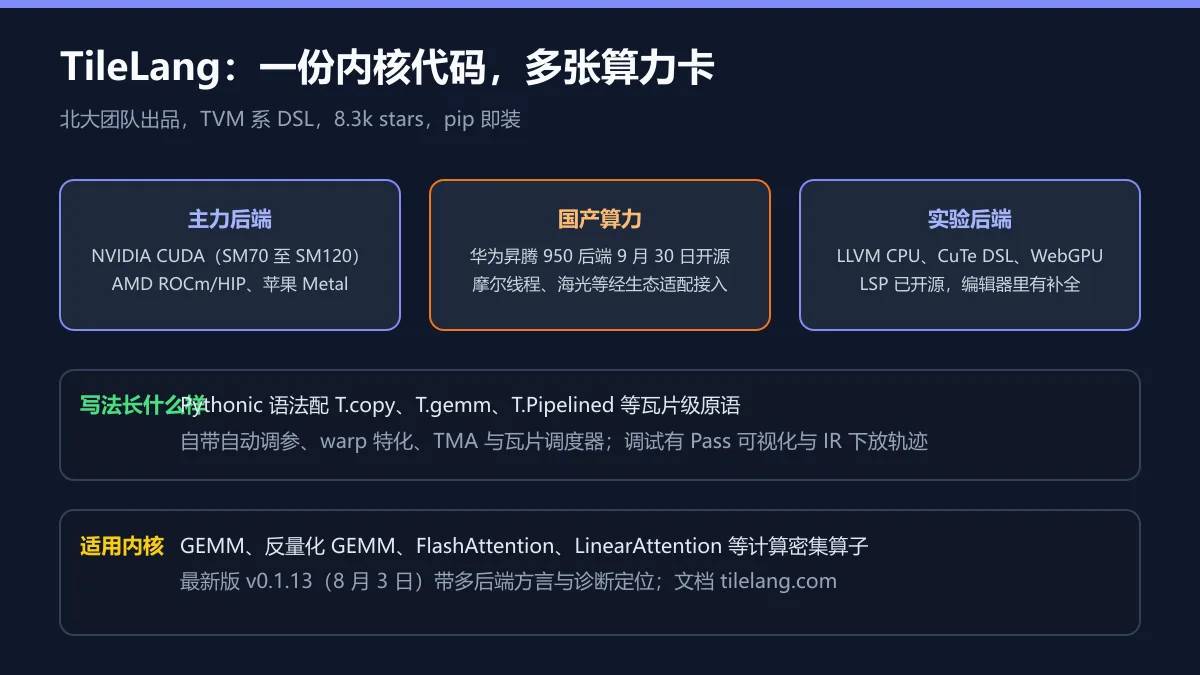
- 后端矩阵:主力覆盖 NVIDIA CUDA(SM70 至 SM120)与 AMD ROCm/HIP,苹果 Metal 在支持列表;实验性后端含 LLVM CPU、CuTe DSL 与 WebGPU。
- 国产算力接入:华为昇腾 950 后端 9 月 30 日刚开源,摩尔线程 MUSA、海光、MetaX 等通过生态适配器接入。一份代码跨中外多张加速卡,这在当前的开源内核 DSL 里覆盖面少见。
- 版本节奏:最新版本 v0.1.13(8 月 3 日)带多后端方言与诊断定位,文档站 tilelang.com,社区在 Discord。
快速上手
bash
pip install tilelang一段 FP16 矩阵乘加 ReLU 的内核长这样:
python
@tilelang.jit
def matmul_relu(A, B, block_M=128, block_N=128, block_K=32):
    M, N, K = T.const("M, N, K")
    A: T.Tensor((M, K), T.float16)
    with T.Kernel(T.ceildiv(N, block_N), T.ceildiv(M, block_M), threads=128) as (bx, by):
        for k in T.Pipelined(T.ceildiv(K, block_K), num_stages=3):
            T.copy(A[by * block_M, k * block_K], A_shared)
            T.gemm(A_shared, B_shared, C_local)
适合谁用
要给自研算子做多卡适配的推理引擎团队是第一受众,昇腾后端刚开源,国产算力上做内核迁移的同学可以直接上手对照。做 ML 系统研究的学生与工程师,这门 DSL 的瓦片抽象本身就是 Triton 之外的另一条技术路线,读源码加写示例的收货都不小。
相关文章
分享: