字节笔记本
2026年11月5日 · 约 2 分钟读完
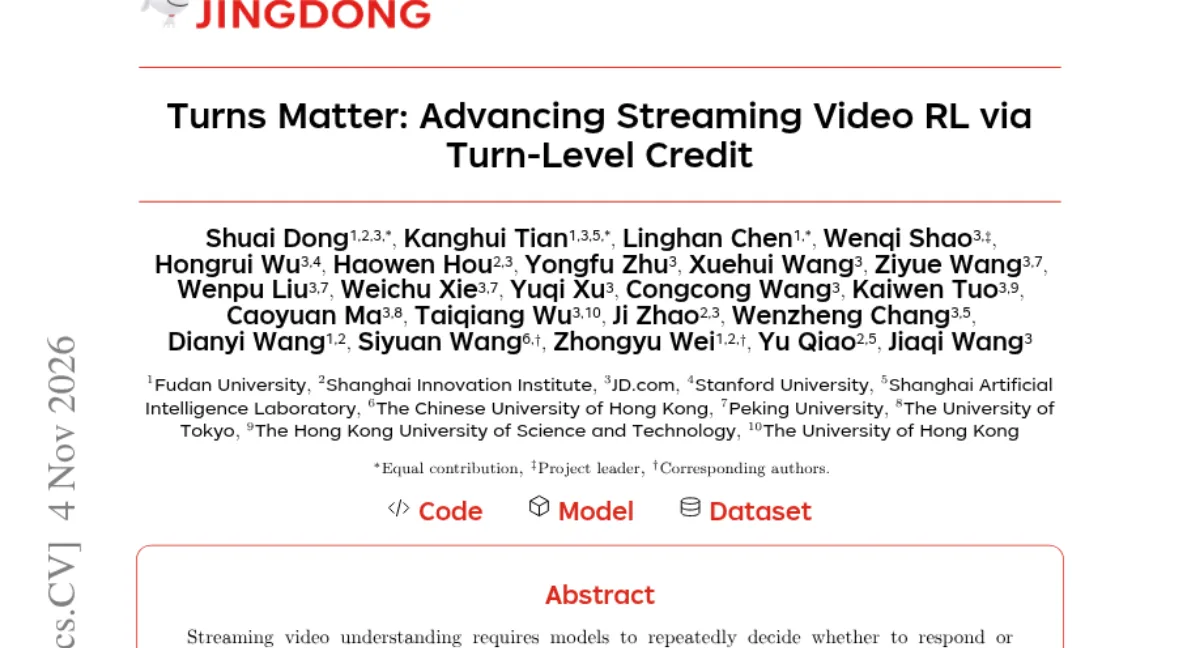
流式视频 RL 的奖励怎么记账?TurnWise 说按回合算
流式视频 RL 有个一直没被认真对待的记账问题:一条轨迹打一个总分,然后把这个优势广播给轨迹里的每一次「说话或闭嘴」决策。TurnWise(arXiv 2611.06728,复旦、上海人工智能实验室、京东、斯坦福等多机构合作)指出这里的粒度错配:好轨迹里可以有烂回合,烂轨迹里也可以有好回合,早期成功之后的冗余回复会白白继承正优势,早期失败之后的有用补充反而被负优势压制。
它的记账方法叫静音补全前缀评分:保留前 t 个动作,把剩余动作全部替换成静音,用同一个评分器再打一次分,两者之差就是这个时点的剩余回报,由此构建组相对的轮次级优势。整个过程不需要 critic 网络,也不需要额外 rollout。第二个修正针对长度偏置:token 级聚合会让长回复权重大、把简短的「等待」决策压死,TurnWise 改为先轮内平均、再跨轮平均,每个决策的权重一律为一除以轮数。再配一个 α 热身,前 10% 的更新步从共享优势线性过渡到全轮次修正。
实验用 Qwen2.5-VL-3B 和 Qwen3-VL-4B 做骨干,先 SFT 十万样本再用约四千个流式实例做 GRPO。成绩按论文口径:Qwen3-VL-4B 在 ProactiveVQA、OVO-Timing、StreamingBench 三项上分别提升 6.26、1.92、2.38 分;信用重分配的分析最有说服力,59.83% 拿到正全局优势的重复回复被轮级信用判为负优势,21.20% 的决策直接改变了优势符号;两项设计合用后重复率从 15.53 降到 5.98。
对做流式多模态 agent 的团队,这篇的价值不只在分数:它把「轨迹级奖励在多轮场景下必然粗糙」这个隐性问题摆上了台面,而修复手段的工程成本出奇地低,一次额外评分加一个聚合顺序调整。代码与数据已开源。