字节笔记本
2026年11月5日 · 约 2 分钟读完
音频造假取证只带一份权重:VeriSpoof 的 EER 压到 1.79%
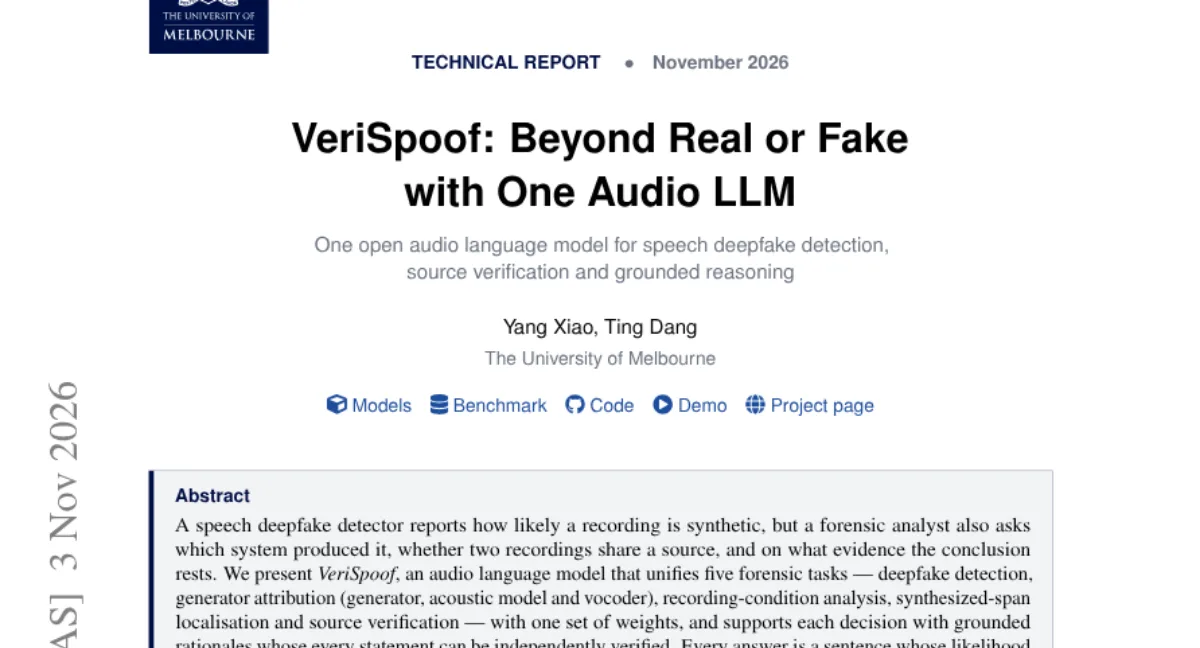
深度伪造语音的取证工具,现状是一堆「一题一模型」:测真伪一个、溯源一个、比录音条件再一个,解释还常是蒸馏来的自由文本,没人验证过决策是否真的依赖它。墨尔本大学的 VeriSpoof(arXiv 2611.04634)把所有取证问题统一成一件事:答案评分。候选答案写成完整句子,取正负答案的对数似然之差当分数,不需要任何专用输出头。
架构省得克制:冻结的 Qwen3-ASR 编码器加 DoRA 适配、音频 tokenizer(16 个话语 token 加 52 个 0.16 秒帧 token)、MiniCPM5-2B 加 LoRA,共 2.85B 参数,实际只训练 29.7M,约百分之一。三阶段训练走感知对齐、取证问题微调、有据理由微调,最后一阶段混入两成反事实样本,逼决策真正跟随所陈述的定位。理由按固定字段书写,每条陈述都有独立于模型的校验器兜底:波形测量、增强日志、标注跨度、生成器元数据。
覆盖面是它敢叫「一站式」的底气:真伪检测、来源归属(生成器、声学模型、vocoder 分开答)、录音条件(噪声、混响、编解码器、后处理)、部分伪造定位、成对同源验证,连「属性相同但系统不同」的 REVERSAL 难例都收了。成绩按论文口径:Speech-DF-Arena 十四个测试集上,Plus 版平均 EER 1.79%、池化 2.14%,是最佳开源权重系统(次优开源为 5.66% 与 9.52%);在更新的 SpoofRadar 榜上池化 EER 4.04%,低于已发布榜单所有开源系统。最刺眼的一组对照是通用音频 LLM 的零样本成绩:真假判断只有 52.1% 到 64.7%,同源与录音条件问题接近随机。
部署账也算得亲民:Base 版约 14 个 GPU 小时(单张 48GB 卡),推理只要 6 到 7 GiB 显存,8GB 卡就能跑。两个模型、vLLM 推理代码、在线 demo 加 VeriSpoof-Bench(54 个子集、17.7 万项)全部放出。对做语音产品风控的团队,这套「统一评分加有据理由」的框架,比再训一个二分类器值得研究得多。