
字
字节笔记本
2026年11月6日 · 约 2 分钟读完
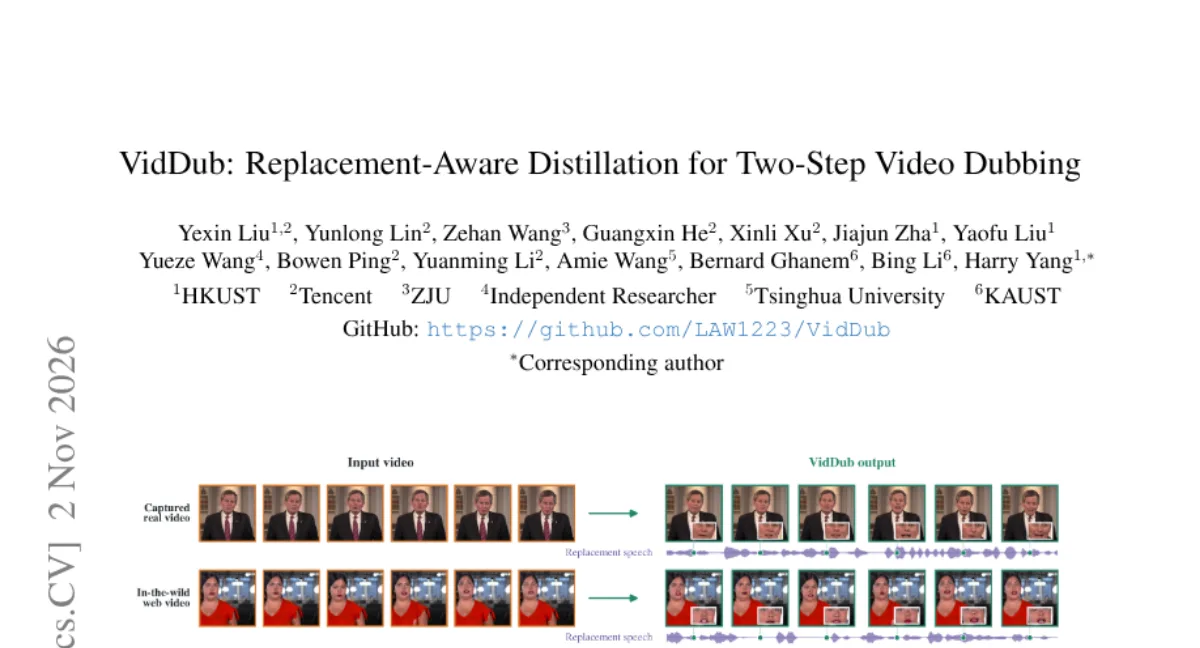
换语言配音口型对上了:VidDub 两步完成视频配音
API中转
¥120
视频配音(dubbing)有个藏在损失函数里的坑:现有模型多用同音频自重建训练,可配音的本质是「换人说话」,一旦驱动音频被替换,源视频里原说话人的嘴部就成了与新语音冲突的训练目标,出来的片子嘴型对不上、脸也在抖。VidDub(arXiv 2611.03404)把这个问题点破并给出了替换感知的解法。
核心是替换感知的跨音频监督:配对的同音频样本照常走全帧重建损失;非配对的替换音频样本则在嘴部区域屏蔽 flow-matching、像素与感知三类重建损失,改用音视同步损失监督嘴部,非嘴部区域和背景照常重建。口型听新语音的,脸和背景忠于原片,冲突就此化解。架构上基于 Wan-1.3B 加 VACE 条件、287M 的 Whisper 音频适配器,保留双向时序注意力适配离线配音;教师 48 步压缩到学生 2 步,再用 DMD2 分布匹配蒸馏找回视觉质量;长视频用 81 帧重叠滑窗,窗口步进 64 帧。
数字按论文口径:屏蔽冲突的源嘴部重建损失让跨音频 Sync-C 提升 0.833;全上下文注意力对比因果版本,81 帧窗口处理速度 11.3 对 9.4 FPS,峰值内存降 37%(13.77 对 21.96 GiB),六项独立唇读评测全部获胜;LRS3 视觉语音识别上 VidDub 的词错误率最低;15 人盲评 150 次试验,优于 Lip Forcing 与 LatentSync,与教师基本持平。团队还放出 85,435 条精选训练片段和 VidDub-Bench(256 个说话人、中英各 128)。
对做出海内容、本地化视频的团队,两步生成的速度加替换感知的口型,正好卡在「能批量用」的门槛上。数据与基准已开源,中文配音场景直接对口。
相关文章

分享: