字节笔记本
2026年10月6日 · 约 25 分钟读完
如何写出让 AI Agent 稳定执行的 Skill
Matt Pocock 的 mattpocock/skills 仓库 4 个月冲到 152K star,152K 人盯着他的 SKILL.md 源码学怎么写 Agent 指令。
但他自己最看重的那篇 Skill,不是 /grill-me,也不是 /tdd,而是 /writing-great-skills:一篇教你怎么写 Skill 的 Skill。它是一个元技能,讲的是「如何控制一个随机系统输出确定性」的设计哲学。
读完他的源码和几十个 Skill 的版本历史,这篇文章把其中最核心的思想和能直接拿回去用的方法论拆出来。
素材来源:mattpocock/skills 仓库中的
writing-great-skills,2026 年 7 月整理
先搞清楚一件事:Skill 到底是什么
Skill 不是提示词,不是「请你做一个 XX」那种自然语言对话。
Skill 是一个结构化的 Markdown 文件,放在 .claude/skills/ 目录里(Cursor 对应 .cursor/skills/,Codex 对应 AGENTS.md),Agent 读取它之后按照里面定义的步骤执行工作流。
它和普通提示词的核心区别:
| 普通提示词 | Skill | |
|---|---|---|
| 形态 | 一段对话里说一次的话 | 持久化的 Markdown 文件 |
| 触发 | 每次手动粘贴 | Agent 自动识别场景触发 |
| 结构 | 自由格式 | 有 frontmatter、分步骤、有分支 |
| 生命周期 | 用完即弃 | 跟着代码库版本管理 |
| 组合性 | 无法组合 | 多个 Skill 可以串联调用 |
一个 Skill 长什么样?这是 Matt Pocock 最短的 Skill 之一:/grill-me,全文 7 行:
---
name: grill-me
description: Interview me relentlessly about every aspect of this plan.
---

Interview me relentlessly about every aspect of this plan until we reach
a shared understanding. Walk down each branch of the design tree,
resolving dependencies between decisions one-by-one. For each question,
provide your recommended answer.

Ask the questions one at a time.

If a question can be answered by exploring the codebase, explore the
codebase instead.
7 行。但就是这 7 行,能让 Agent 在动手前问你 20、50 甚至 100 个问题。用极少文本撬动大行为变化,这就是 Skill 的设计目标。
/writing-great-skills 的核心:6 个概念
Matt 在 writing-great-skills 里定义了一套词汇表来描述 Skill 设计。挑最重要的 6 个,每个都说清楚是什么、怎么用、有什么坑。
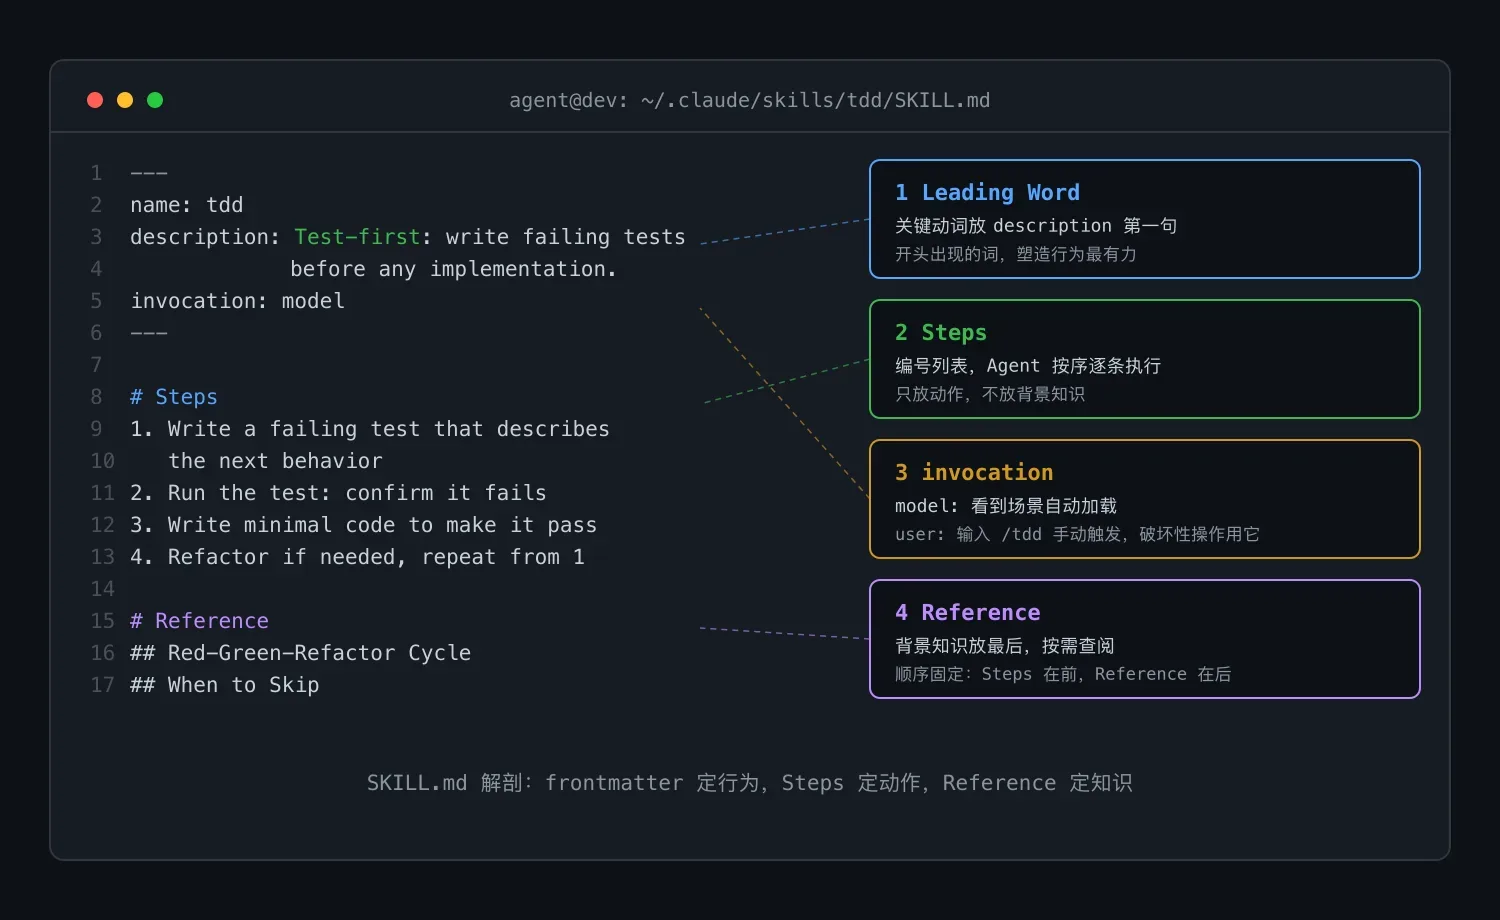
1. Leading Word(引导词)
定义:Skill 开头的第一个关键概念词,它决定了 Agent 对这个 Skill 的行为预期。
这是整套方法论里最精妙的设计。Matt 发现,大模型在处理指令时,前面出现的词对行为的塑造力远大于后面出现的词。把最关键的动词或概念放在第一句、第一个词,Agent 的行为锚定就稳了。
实际操作:
# 弱写法
description: When you are working on code, try to think about testing
# Agent 可能忽略 "testing",因为 "code" 出现在前面

# 强写法
description: Test-first: write failing tests before any implementation
# "Test-first" 直接锚定行为我自己的用法:每写一个 Skill,先问自己一句话:「如果这个 Skill 只能留一个词,留哪个?」那个词就是 leading word,把它放到 description 的最开头。
2. 信息层级:Steps 与 Reference
Matt 把 Skill 内容分成两种类型:
- Steps(步骤):按顺序执行的指令,Agent 会一步步走完。用编号列表。
- Reference(参考):背景知识、术语定义、规则集。Agent 需要时查阅,不需要时跳过。用折叠区块或放在 Skill 末尾。
为什么这很重要:如果把所有信息都混成步骤,Agent 会逐条执行,包括那些本来只是「参考信息」的内容,浪费时间甚至产生错误行为。如果把步骤混进参考信息里,Agent 可能跳过关键步骤。
具体写法:
---
name: tdd
description: Test-first: write a failing test, make it pass, refactor.
---

# Steps

1. Write a failing test that describes the next behavior
2. Run the test: confirm it fails for the right reason
3. Write the minimal code to make it pass
4. Run the test: confirm it passes
5. Refactor if needed
6. Repeat from step 1

# Reference

## Red-Green-Refactor Cycle

The TDD cycle: Red (failing test), Green (minimal passing code), Refactor (improve without changing behavior).

## When to Skip

Exploratory coding, spike solutions, and prototype work can skip TDD.
The user will explicitly say "skip TDD" when appropriate.
步骤是给 Agent 执行的,参考是给 Agent 查阅的。分层清晰,Agent 才不会乱。
3. 触发设计:Model-invoked 与 User-invoked
Matt 把 Skill 分成两类:
User-invoked(用户触发):只有用户输入 /skill-name 时才执行。
---
name: grill-me
description: Interview me relentlessly about every aspect of this plan.
---
# frontmatter 里没有触发关键词
# 只有用户主动输入 /grill-me 才会加载Model-invoked(模型触发):Agent 根据当前上下文自动判断是否需要加载。
---
name: tdd
description: Test-first: write failing tests before any implementation.
invocation: model
---
# Agent 看到你在写代码,会自动加载这个 Skill设计原则:破坏性操作、需要用户确认的操作、改变工作流方向的操作,用 user-invoked。日常编码规范、自动检查类操作,用 model-invoked。
我踩过的坑:我曾经把一个「重构建议」的 Skill 设成了 model-invoked,结果每次写代码 Agent 都停下来给我重构建议,烦不胜烦。改成 user-invoked 之后,只有主动输入 /refactor-suggest 它才出来。
4. 拆分原则:When to Split
Matt 给了两条拆分规则:
规则 1:按触发方式拆。如果一个 Skill 的一部分应该 model-invoked,另一部分应该 user-invoked,拆成两个。
规则 2:按执行顺序拆。如果一个 Skill 有多个独立阶段,每个阶段可能单独使用,拆成多个。
Matt 自己的例子:他曾经有一个大 Skill 叫 grill-with-docs,既做需求追问,又写文档。后来拆成了 /grill-me(只追问)和 /grill-with-docs(追问加文档沉淀),因为有时候你只想追问,不想改文件。
5. 修剪:Pruning(删减冗余)
这是 Matt 最被低估的设计原则。他有一句原话:
"If you remove an instruction and nothing changes, it was sediment."
翻译:如果你删掉一条指令,Agent 的行为没有任何变化,那这条指令就是沉积物,应该删掉。
沉积物的三个来源:
- 和 Agent 的默认行为重复:Agent 本来就会做的事,你写出来也没用
- 和其他 Skill 重复:多个 Skill 说同一件事,删到只留一处
- 过时的规则:项目演化后不再适用的旧规则
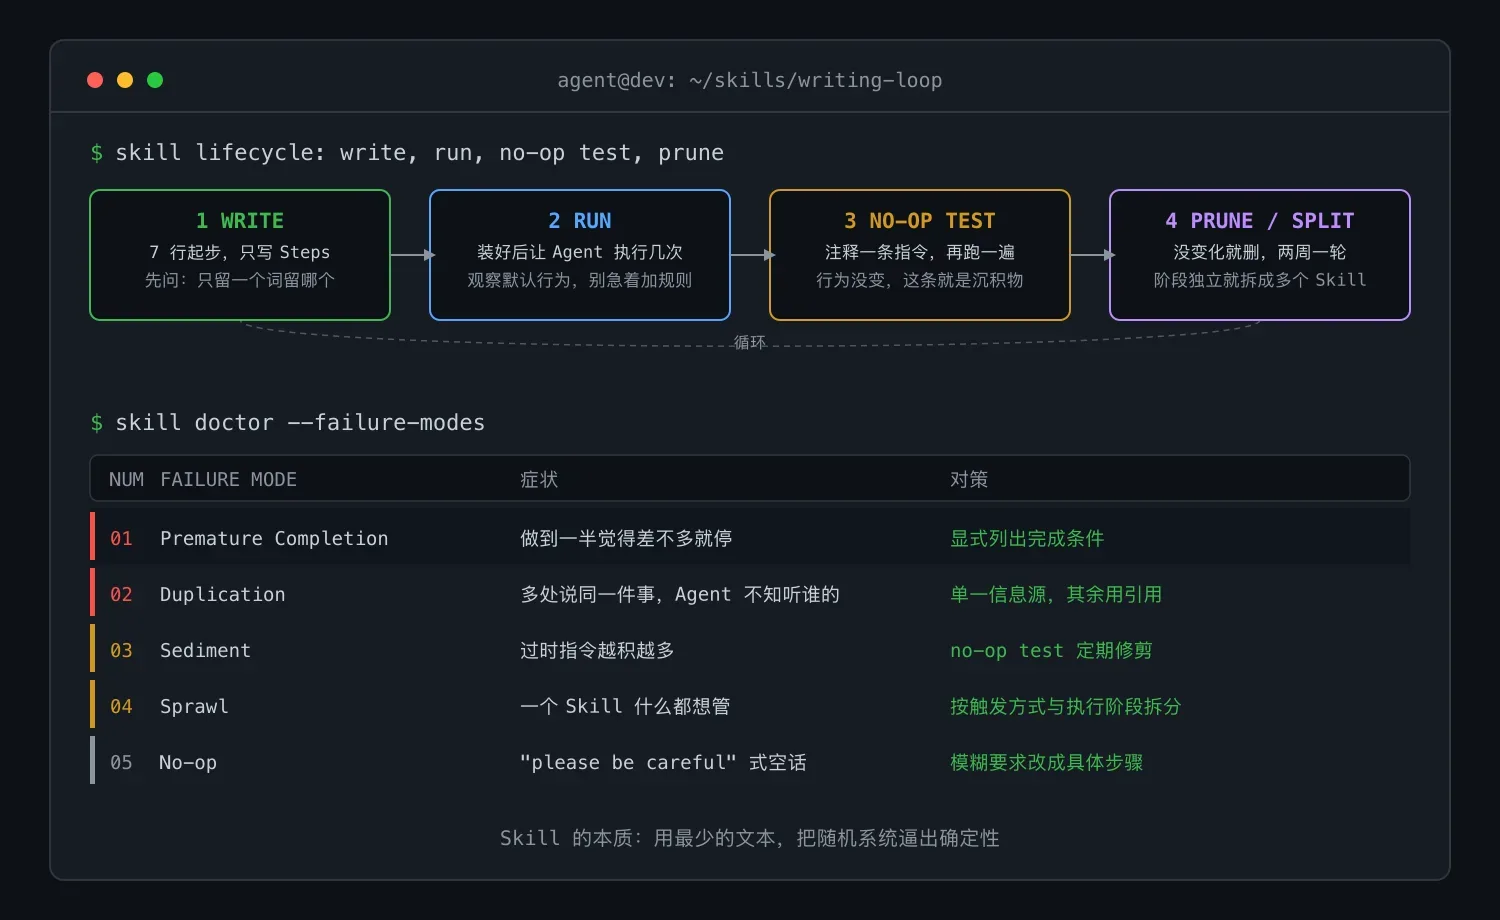
实操方法:No-op Test(空操作测试)。Matt 的做法非常工程化:把一条指令注释掉,观察 Agent 行为是否变化。没变化,删掉;变化了,保留。
我自己的节奏:每两周跑一次 no-op test,对着自己的 Skill 列表逐条注释,一轮下来通常能砍掉 10% 到 15% 的冗余内容。
6. 五个失败模式
Matt 在 GLOSSARY.md 里定义了 5 个 Skill 失败模式,按严重程度排序:
① 过早完成(Premature Completion),最致命。
Agent 做到一半觉得「差不多了」就停了。比如你让它写一个完整的 CRUD,它写完 Create 就结束了。
解法:在 Skill 里用显式的完成条件。不要写 "implement the feature",写 "implement the feature AND confirm by listing: 1) Create works, 2) Read works, 3) Update works, 4) Delete works"。
② 重复(Duplication)。
多个 Skill 说同一件事,或者 Skill 和项目的 CLAUDE.md/AGENTS.md 说同一件事。Agent 不知道听谁的。
解法:单一信息源原则。一个知识点只在一个地方定义,其他地方用引用("see SKILL-X for details")。
③ 沉积(Sediment)。
随时间积累的无用指令。越积越多,Skill 越来越长,Agent 越来越难抓住重点。
解法:定期 pruning,用 no-op test 清理。
④ 蔓延(Sprawl)。
一个 Skill 试图做太多事,越长越长,最后变成一个「万能 Skill」。什么都做了,什么都不精。
解法:When to Split,按触发方式和执行顺序拆。
⑤ 空转(No-op)。
写了一大段指令,Agent 看了等于没看。最典型的例子:写着 "please be careful",Agent 根本不知道 "careful" 在这个上下文里意味着什么。
解法:把模糊的要求替换成具体的步骤。不说 "be careful about edge cases",说 "before submitting, list 3 edge cases and how you handled each"。
拿回去就能用的 Skill 写作模板
根据上述方法论,整理一个直接可用的模板。
模板:一个完整 Skill
---
name: [skill-name]
description: [Leading Word]: [一句话说明这个 Skill 做什么].
invocation: [model / 留空表示 user-invoked]
---

# [Leading Word]

[一段话解释为什么需要这个 Skill,触发条件是什么]

# Steps

1. [第一步:明确的动作动词开头]
2. [第二步]
3. [第三步]
...
N. [最后一步:显式的完成条件]

# Reference

## 适用场景

- 场景 A
- 场景 B

## 不适用场景

- 场景 X(什么时候跳过)

## 相关 Skill

- `[other-skill]`: [关系说明]
模板:一个最小 Skill(7 行足够)
---
name: [skill-name]
description: [Leading Word]: [一句话].
---

[核心指令,一段话,3-5 句]

如果可以,先探索代码库,再提问。
一次只问一个问题。
每个问题附带你的建议答案。
一个真实案例:/code-review-checklist
用这套方法论写一个每天 PR review 都能用的 Skill:
---
name: code-review-checklist
description: Review-first: systematic code review against architecture and edge cases.
invocation: model
---

# Review-First

When reviewing a pull request or code changes, execute this checklist.

# Steps

1. Read the PR description: identify the stated intent
2. Explore the changed files: understand what actually changed
3. Check alignment: does the code match the stated intent?
4. Check edge cases: list 3 scenarios the author might have missed
5. Check tests: is there test coverage for the critical path?
6. Check naming: do variable/function names match the domain language in CONTEXT.md?
7. Write the review: lead with approval/concern, then list findings

# Reference

## Review Format

- [Approved item]
- [Concern: explain why]
- [Suggestion: optional improvement]

## When to Skip

- Trivial changes (typo fixes, formatting)
- Changes to test files only
- When the user says "quick review"
这个 Skill 用了两个月,每次 review 都按这 7 步走,不会漏掉关键的检查点。而且因为用了 model-invoked,每次打开 PR 它自动加载,不需要手动触发。
Matt 的 4 条铁律
有个人翻完了 Matt 几十个 Skill 的完整 Git 提交历史,总结出他写 Skill 时守着的 4 条铁律。有些地方他自己也违反过,然后又改了回来。
铁律 1:Leading Word 必须在最前面
Matt 曾经在一个 Skill 里把 leading word 放到了第二段。结果是 Agent 的行为变得不稳定:有时候触发,有时候不触发。后来他把 leading word 提到 description 的第一个词,问题消失。
你的操作:写完 Skill 的 description 后,检查第一个词是不是这个 Skill 的核心行为。如果不是,重写。
铁律 2:一个触发词只对应一个分支
不要让一个 Skill 在不同场景下做不同的事。如果场景 A 和场景 B 的行为差异很大,拆成两个 Skill。
Matt 的教训:他曾经有一个 Skill 同时处理「创建新文件」和「修改已有文件」两个分支。Agent 经常搞混,在应该创建文件时去修改已有文件。后来拆成 /create-file 和 /modify-file,问题消失。
铁律 3:删废话不手软
Matt 的提交历史里最常见的一种 commit 是:删掉自己之前写的冗余指令。有时候是删一句,有时候是删一整段。
他说了一句很务实的话:"Every instruction you add is a bet that the model won't do the right thing by default. If you're wrong, the instruction is noise."
翻译:你加的每一条指令都是一次赌注:赌模型默认不会做正确的事。如果你赌错了,这条指令就是噪音。
你的操作:每次想加一条指令之前,先测试不加的时候模型会怎么做。如果模型已经做对了,不要加。
铁律 4:先写 Steps,再写 Reference
Matt 的 Skill 源码结构永远是:Steps 在前,Reference 在后。
原因是 Agent 的注意力分配:先出现的信息权重更高。Steps 是必须执行的,放前面;Reference 是按需查阅的,放后面。
如何开始写你自己的 Skill:实操步骤
如果从来没有写过 Skill,按这个顺序来:
Step 1:安装 Matt 的 Skills 作为参考
npx skills@latest add mattpocock/skills选择感兴趣的几个 Skill 安装,然后去 .claude/skills/ 目录下读它们的源码。读源码比读任何教程都快。
Step 2:从痛点出发,写第一个 Skill
问自己:「我每天和 AI 对话时,有哪些话我至少重复了 10 次?」
这些重复说的话就是你的第一个 Skill。比如你每天都说「先写测试再写代码」「不要跳过 PR review」「把大任务拆成小任务」,这些都可以变成 Skill。
Step 3:用最小格式写出来
先用 7 行格式写出来。不要追求完美,不要写 Reference 部分,只要 Steps。
Step 4:用 No-op Test 验证
把 Skill 安装好,让 Agent 执行几次。然后把其中一条指令注释掉,看行为是否变化。没变化,删掉。逐条测试,直到每条指令都对行为有实际影响。
Step 5:两周后回来 Pruning
两周后重新读一遍你的 Skill。你会发现自己当时写的一些东西已经不需要了(因为 Agent 的默认行为可能变了,或者项目结构变了)。删掉它们。
Skill 生态的现状:不只是 Matt 一个人在搞
Matt 的 mattpocock/skills 仓库是目前最火的 Skill 库,但它不是唯一的选择。
- ZCode Skills:ZCode 自带 Skill 市场,内置 200+ 个 Skill,涵盖代码审查、文档生成、PRD 撰写、部署等多种场景。可以直接用,也可以基于它们的模板写自己的。
- Cursor Rules:Cursor 的
.cursor/rules/也是一种 Skill 格式,只是用 YAML 而不是 Markdown。 - Codex AGENTS.md:OpenAI Codex 用
AGENTS.md作为 Skill 入口,格式更自由。
Matt 的方法论不绑定任何工具。无论你用 Claude Code、Cursor、Codex 还是 ZCode,writing-great-skills 里的 6 个核心概念(leading word、信息层级、触发设计、拆分原则、修剪、失败模式)都是通用的。
最值得记住的一句话
Matt 在演讲里引用了 5 本 20 年以上的老书:《软件设计哲学》《程序员修炼之道》《设计的设计》《领域驱动设计》《测试驱动开发》。然后他说了一句话:
"Go on Amazon, get it."
这是整场演讲的彩蛋。他的意思是:所有的 AI 编程方法论,底座都是那 5 本书里讲了 20 年的工程基本功。Skill 不是新发明,它是把老基本功翻译成了 LLM 能执行的形式。
如果今天只从这篇文章里记住一件事,记住这个:Skill 的本质,是用最少的文本,把随机系统逼出确定性。 你不需要写很长,你需要写得很准。Leading word 放前面,Steps 和 Reference 分清楚,定期 Pruning,避免五个失败模式。做到这四点,你的 Skill 就不会差。