字节笔记本
2026年10月6日 · 约 14 分钟读完
Agentic 编程实战课 10:代码能跑,不等于结果对
本文来自本站的 Agentic 编程实战课系列,这一篇讲每个用 AI 干活的人都躲不开的问题:验证闭环。
Anthropic 的报告里有一句很扎心的话:Agent 会自信地犯错。代码能跑,不等于结果正确。这篇文章教你搭一个验证闭环,让你在 30 秒内判断 Agent 的产出对不对,而不是花 2 小时排查 bug。对非职业程序员来说,这也是你专业知识最直接的变现点。
一个让你后背发凉的事实
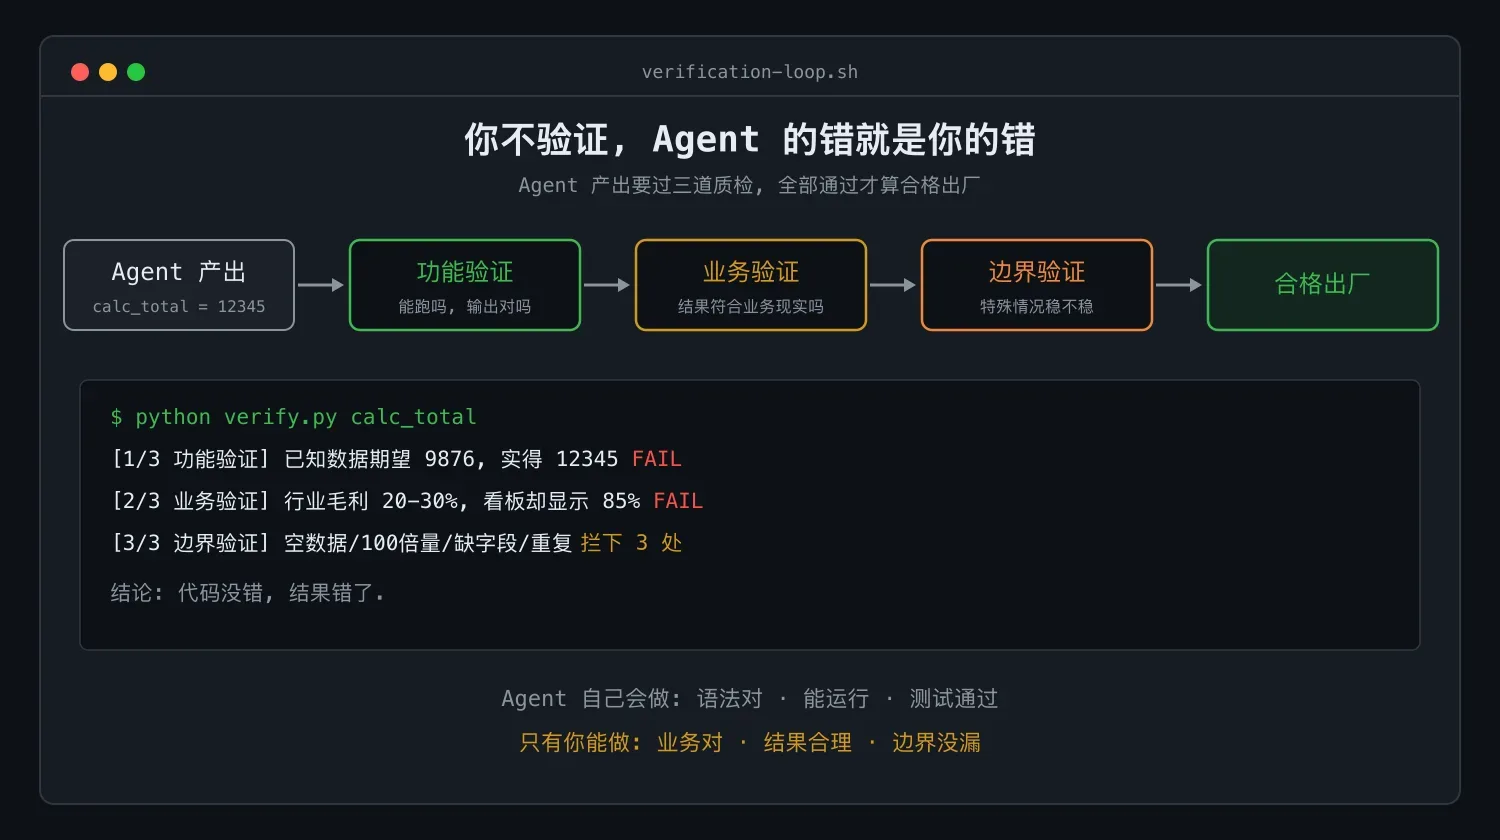
代码运行成功,不等于结果正确
来看一个真实例子。一位学员让 Agent 做销售汇总:
# Agent 写的代码
def calc_total(sales):
    return sum(sales)

# 运行:无报错
# 结果:12345
看起来完美。但这位学员没注意到:
- 没排除退款订单(负数)
- 没排除测试数据
- 货币单位混了,人民币和美元混在一起算
真实正确的答案是 9876,不是 12345。代码没错,结果错了。
一句话总结:Agent 的代码层验证(能不能跑)它自己会做;你的业务层验证(对不对)只有你能做。
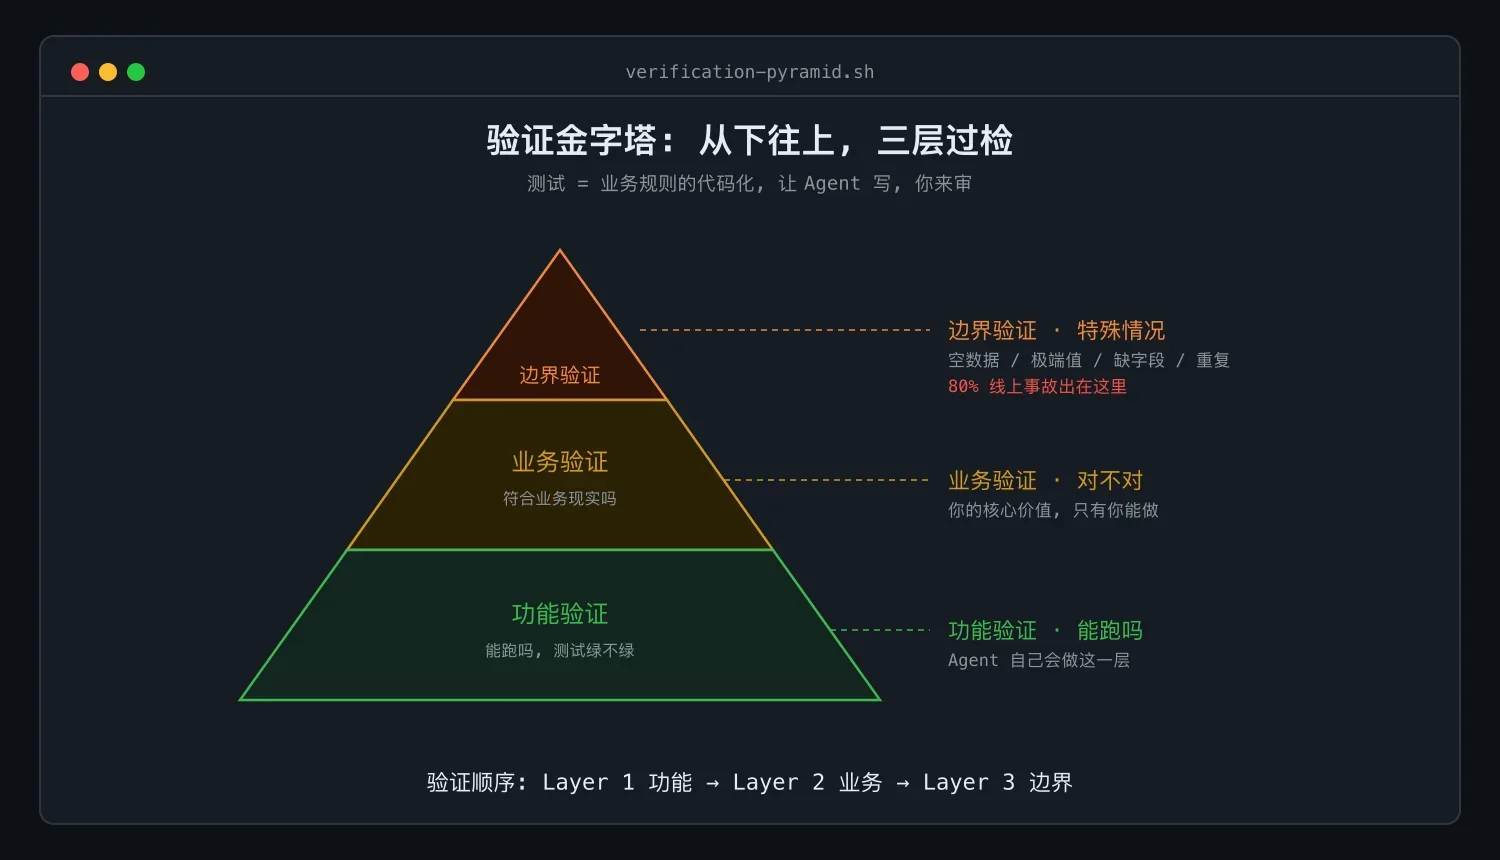
验证闭环的三层模型
记住这个三层金字塔,从下往上验证:
第一层:功能验证(最基础)
问:它能跑吗?输入给定的数据,输出对吗?
方法:用一组已知答案的数据测试。
assert 函数(已知输入) == 已知输出第二层:业务验证(你最值钱的部分)
问:结果符合业务现实吗?
方法:用你的专业知识心算一遍,对比一下。
例子:销售看板显示"本月毛利率 85%"
你的业务直觉:这个行业毛利率正常在 20-30%,85% 不可能
结论:业务验证失败,必有 bug
第三层:边界验证(最容易翻车)
问:特殊情况它会怎么样?
方法:故意喂刁钻的输入。
| 边界情况 | 测试输入 |
|---|---|
| 空数据 | [] |
| 极端值 | 100 倍正常数据 |
| 异常类型 | 字符串传成数字 |
| 缺失字段 | 删掉一个字段 |
| 重复 | 同一条数据出现 2 次 |
80% 的线上事故都来自边界情况。Agent 写主流程很顺,但边界它想不到,只有你知道你的业务里有哪些边界。
把验证变成代码:测试驱动
很多新手怕写测试,但测试就是把你的业务规格用代码写出来,而且 Agent 能帮你写。
一个具体例子
假设 Agent 给你写了个佣金计算函数:
def calc_commission(sales):
    if sales < 10000:
        return 0
    elif sales < 50000:
        return sales * 0.03
    else:
        return sales * 0.05 + 1000
怎么验证?写一组测试,让 Agent 帮你写:
# test_commission.py
def test_calc_commission():
    # 第一层:基本功能
    assert calc_commission(5000) == 0           # 不到门槛
    assert calc_commission(20000) == 600        # 3% 档
    assert calc_commission(100000) == 6000      # 5% 加 1000

    # 第三层:边界
    assert calc_commission(0) == 0              # 零销售
    assert calc_commission(9999) == 0           # 临界点之下
    assert calc_commission(10000) == 300        # 临界点,注意
    assert calc_commission(49999) == 1499.97    # 临界点
    assert calc_commission(50000) == 3500       # 跨档
跑一下:
python -m pytest test_commission.py
# 全绿,即全部通过
看,测试就是业务规则的代码化。你不用会写代码,只要会列规则,列完规则让 Agent 写测试。
案例:一次差点上线的事故
一位做会计的学员要做财务报表自动化:每月自动算各门店毛利,发给老板。
Agent 交付的代码
def calc_store_profit(orders):
    revenue = sum(o['amount'] for o in orders)
    cost = sum(o['cost'] for o in orders)
    return revenue - cost
测试通过,她准备上线。上线前,按三层模型把验证做了一遍。
第一层:功能验证
assert calc_store_profit([{amount:100, cost:60}]) == 40
# 通过
第二层:业务验证
她是会计,问了自己三个问题:
- 退款的负数订单处理了吗?没处理。
- 成本里包含退货成本了吗?没扣。
- 汇率换算做了吗?没有,而她手里管着跨境店。
她心算一家店的真实毛利是 12000,Agent 算出来是 15800,差了 3800。
第三层:边界验证
- 一家店本月全是退款怎么显示?代码会输出负数,没有任何提示。
- 成本字段缺失怎么处理?会直接报错,没有优雅处理。
修复后的规格
她把这些业务知识补进规格,让 Agent 重写:
def calc_store_profit(orders):
    # 业务规则:amount 为负 = 退款,单独统计
    valid = [o for o in orders if o.get('amount', 0) > 0]
    refunds = [o for o in orders if o.get('amount', 0) < 0]

    revenue = sum(o['amount'] for o in valid)
    refund_amount = abs(sum(o['amount'] for o in refunds))

    # 业务规则:成本包含退货物流
    cost = sum(o.get('cost', 0) for o in orders)
    refund_cost = sum(o.get('refund_cost', 0) for o in refunds)

    # 业务规则:跨境店按月均汇率换算
    currency = orders[0].get('currency', 'CNY')
    if currency != 'CNY':
        rate = get_monthly_avg_rate(...)
        revenue /= rate
        cost /= rate

    net_profit = revenue - cost - refund_amount - refund_cost
    return net_profit
关键在于:上面这些业务规则,只有懂会计的人知道,Agent 永远不会自己想到。如果那份错误的报表发给了老板,就是一次实打实的事故。业务验证拦下来的,就是上线前最有价值的一刀。这就是专业知识带来的持久回报:一份差点出错的报表被拦下来,错误没有走出你的机器。
四个验证工作流
工作流一:测试驱动,提前写测试
复杂业务逻辑,先写测试再写代码:
- 你列出业务规则
- 让 Agent 把规则翻译成测试代码
- 让 Agent 实现函数
- 跑测试,红了改代码,绿了通过
这就是经典的 TDD(Test-Driven Development,测试驱动开发),源自 Kent Beck 的同名著作。
工作流二:抽样验证,适合数据类项目
数据项目没法穷举测试,用抽样:
- 准备 5 到 10 组已知答案的小数据
- 跑 Agent 的代码
- 对比答案
- 重点验证极端值、缺失值、重复值
工作流三:日志审计,适合流程类项目
让 Agent 在代码里加日志:
import logging
logging.info(f"读取 {len(orders)} 条订单")
logging.info(f"过滤退款后剩 {len(valid)} 条")
logging.info(f"总营收 {revenue}")
跑一遍看日志,检查每一步的数字是否合理。
工作流四:人工核对,对外交付的最后一关
任何对外交付的东西,最后一关必须人工核对:
- 报表:抽 3 行手算
- API:用 Postman 调一次,看返回
- 网页:手动点 5 个核心流程
铁律:不要让 Agent 帮你验证你自己应该验证的东西。Agent 自己写的代码让它自己测,等于让它给自己打分。
一份验证清单模板
每次 Agent 交付一个完整的实现任务,过一遍这个清单:
# 验证清单

## 第一层:功能验证
- [ ] 用 1 组已知数据测试,输出对吗
- [ ] 跑现有测试,全绿吗

## 第二层:业务验证
- [ ] 用我的专业心算对比,结果合理吗
- [ ] 关键指标(金额/数量/百分比)在正常区间吗

## 第三层:边界验证
- [ ] 空数据、零值、负值会怎样
- [ ] 缺失字段会怎样
- [ ] 极端值(10 倍、100 倍)会怎样

## 收尾
- [ ] 我能用 1 句话说清这个任务做完了吗
- [ ] commit 一下,留个存档点
验证失败时:纠偏的三个动作
发现 Agent 做错了,不要慌,按这个顺序来。
动作一:先复现
让 Agent 写一个会失败的测试来复现问题:
> 这个函数在输入 ___ 时输出了 ___,
  请写一个测试证明这个 bug,先跑红,再修。
复现等于治病前先确诊。不写测试直接改,容易按下葫芦浮起瓢。
动作二:补规格
bug 的根因往往是规格没说清楚。把这次发现的边界补进规格(比如 CLAUDE.md 或 RFC):
## 业务规则补充
- 退款订单(amount<0)必须单独统计,不能直接相加
- 跨境订单按月均汇率换算
动作三:回归测试
修完 bug 后,跑全部测试,确保没引入新问题:
python -m pytest
# 全绿:修复成功,没搞坏其他地方
修 bug 时最常见的悲剧是修了 A、搞坏了 B,全量测试就是你的保险。
动手练习
练习一(必做):从你拆解到执行粒度的任务清单里挑一个,给它写 3 到 5 个测试用例,让 Agent 帮你写、你来审,至少包含 2 个边界情况。
练习二(必做):找一个你已经做完的小项目,比如番茄钟、书单管理这类练手应用,按上面的验证清单过一遍。你多半会发现至少 1 个之前没注意到的问题。
练习三(思考):下面这个验证策略有什么问题?"Agent 写完后,我让它自己测一下,它说测试通过了,我就上线了。"参考答案:这是运动员兼任裁判,Agent 测自己的代码会偏向乐观。业务层验证必须人来做,尤其涉及金额、健康、安全的场景。
练习四(推荐):在你的 CLAUDE.md 里加一节业务红线,列出 3 条绝对不能错的事。例如:
## 业务红线
- 任何金额计算必须精确到分(用 Decimal 类型)
- 医疗数据必须脱敏后才能写入日志
- 客户身份证号绝对不能出现在错误信息里
要点回顾
- 代码能跑,不等于结果正确。Agent 自信地犯错是常态。
- 验证分三层:功能(能跑)、业务(合理)、边界(特殊情况)。
- 业务验证是你的核心价值,只有你能判断结果合不合理。
- 测试是业务规则的代码化,让 Agent 帮你写。
- 四个验证工作流:TDD、抽样、日志、人工核对。
- 纠偏三动作:复现、补规格、回归测试。
- 不要让 Agent 替你做业务验证。
验证能拦住大部分错误,但 Agent 还会走偏:你要它做 A,它交付了 B。发现走偏之后怎么诊断、怎么拉回正轨、什么时候该重启而不是修,是另一个同样重要的话题,后续单独展开。
引用与来源:Agent 会自信地犯错,出自 Anthropic 的报告;TDD(测试驱动开发)源自 Kent Beck 的《Test-Driven Development》。