字节笔记本
2026年10月6日 · 约 24 分钟读完
Agentic 编程课第 14 章:科研数据分析流水线
本文是 Agentic 编程实战系列的一篇实战章,场景换成科研与数据分析:用 AI 编程助手,把一条每周都在重复的分析流程,改造成从原始数据到报告的自动化流水线。会用到 pandas、numpy、matplotlib、scipy 这套数据科学常用库,但你不需要预先会其中任何一个:Agent 负责写代码,你负责提供领域知识。
一个真实的重复劳动场景
设想一位生物信息学方向的博士生,他每周要做的事:
- 拿到一批基因表达数据(CSV 矩阵,几千个基因乘几十个样本)
- 跑差异表达分析(DESeq2 或 limma)
- 画火山图、热图
- 整理 Top 差异基因
- 写成报告
流程是固定的,但每次都要查文档、调参数、画图,一份数据要花一到两天。
他的"持久回报"在哪里?他懂而 Agent 不懂的关键业务知识包括:
- 哪种统计方法适合当前数据,用 DESeq2 还是 limma
- 显著性阈值取 padj < 0.05 还是 padj < 0.01
- log2FC 阈值取大于 1 还是大于 2
- 要不要做 LFC shrinkage
- 哪些基因是已知的管家基因,应该剔除
非科研读者别慌:这套流程换成用户行为分析、销售归因、A/B 测试完全通用,重点是流程套路,不是具体领域。
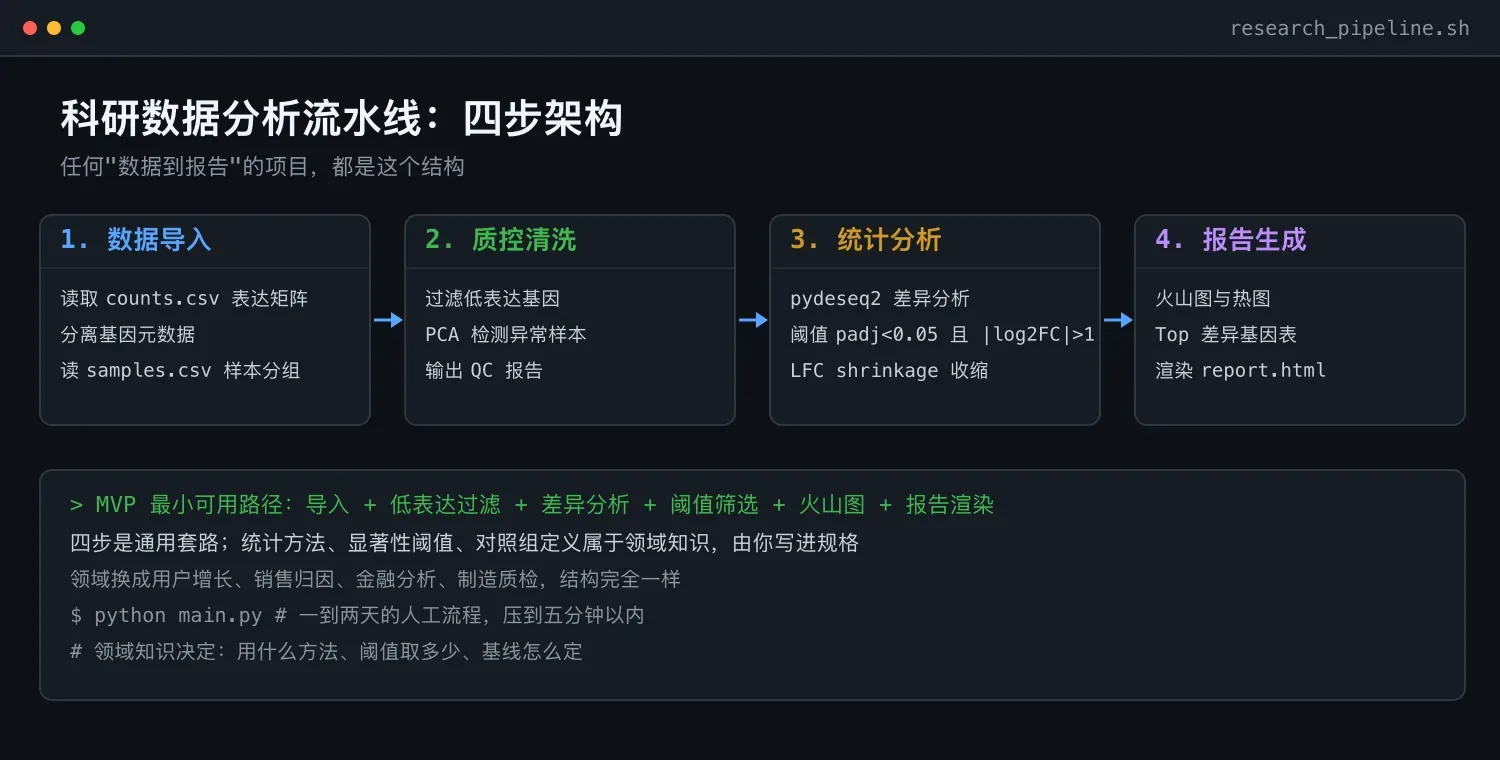
数据分析流水线的通用四步
任何"数据到报告"的项目,结构都是同一个:数据导入、质控清洗、统计分析、报告生成。读原始数据,过滤异常,跑分析方法,画图加写表。
规格写完之后做任务分解:把流水线拆成四个模块,每个模块再拆二到四个可以独立验证的小任务。以本文案例为例,任务清单如下:
# 任务清单

## 模块 1:导入
- 1.1 load_counts() - 读表达矩阵
- 1.2 load_samples() - 读样本分组

## 模块 2:质控
- 2.1 filter_low_expression() - 过滤低表达
- 2.2 run_pca() - PCA 检测异常样本
- 2.3 qc_summary() - 生成 QC 报告

## 模块 3:分析
- 3.1 run_deseq2() - 跑 DESeq2
- 3.2 apply_thresholds() - 应用阈值筛差异基因
- 3.3 lfc_shrinkage() - log2FC 收缩

## 模块 4:报告
- 4.1 plot_volcano() - 火山图
- 4.2 top_genes_table() - Top 基因表
- 4.3 render_report() - 整合到 HTML

## MVP
1.1 + 1.2 + 2.1 + 3.1 + 3.2 + 4.1 + 4.3 就能出最小报告。
写项目规格:把判断权留在自己手里
用一个简化但真实的案例:基因差异表达分析(DEG)。下面是写给 Agent 的规格:
# 差异表达分析流水线规格

## R - 背景
我是生物信息学研究员。有一批 RNA-seq 数据,
需要做"对照组 vs 处理组"的差异表达分析(DEG)。

输入:counts.csv
- 行 = 基因(gene_id, gene_name)
- 列 = 样本(control_1/2/3, treatment_1/2/3)
- 值 = read counts

输出:完整的 HTML 报告

## F - 功能

### 步骤 1:数据导入
- 读 counts.csv
- 分离 metadata(基因名)和 counts 矩阵
- 读 samples.csv(样本分组信息)

### 步骤 2:质控(QC)
- 过滤低表达基因(所有样本总和 < 10 的剔除)
- 检测异常样本(用 PCA 看聚类)
- 输出 QC 报告

### 步骤 3:差异分析
- 用 pydeseq2(Python 实现的 DESeq2)
- 设计公式:~ condition
- 显著性阈值:padj < 0.05 AND |log2FC| > 1(我的判断)
- 做 LFC shrinkage(apeglm 方法)

### 步骤 4:报告
- 火山图(volcano plot)
- Top 20 上调 / 下调基因表
- 已知管家基因列表对照(housekeeping_genes.txt)
- 全部输出到 report.html

## C - 验收标准
- 用示例数据跑通全流程
- 火山图能看出明显的上下调分布
- Top 基因里有几个我认识的真实差异基因
- 全程 < 5 分钟跑完
注意规格里标注"我的判断"的那一行:显著性阈值是业务决定,不是 Agent 决定。把它写死在规格里,后面每一步的产出才有统一口径。
两个关键任务的实现
限于篇幅,只演示最关键的两个任务:差异分析和火山图。
任务一:差异分析(业务关键)
清空上下文后,给 Agent 的任务描述:
> 任务:实现 src/analysis.py 的 run_deseq2() 函数

需求:
1. 输入:counts_df(基因 × 样本),samples_df(含 condition 列)
2. 用 pydeseq2 包做差异分析
3. 设计公式:~ condition
4. 返回 DataFrame:gene_id / gene_name / baseMean / log2FC / lfcSE / pvalue / padj

业务约束(我的领域知识):
- control 组样本:control_1, control_2, control_3
- treatment 组样本:treatment_1, treatment_2, treatment_3
- log2FC 方向:treatment 相对 control(treatment 升高为正)

写 tests/test_analysis.py,至少包含:
- 跑通流程
- 检查返回 DataFrame 列名
- 已知的一个上调基因 log2FC > 0
- 已知的一个下调基因 log2FC < 0

先告诉我需要 pip install 什么,再实现。
Agent 会告诉你装 pydeseq2(pip install pydeseq2),并实现函数:
# src/analysis.py
from pydeseq2.dds import DeseqDataSet
from pydeseq2.default_inference import DefaultInference
from pydeseq2.ds import DeseqStats
import pandas as pd

def run_deseq2(counts_df, samples_df):
    # 业务规则:保证样本顺序对齐
    samples_df = samples_df.loc[counts_df.columns]

    inference = DefaultInference(n_cpus=8)
    dds = DeseqDataSet(
        counts=counts_df,
        metadata=samples_df,
        design="~ condition",
        refit_cooks=True,
        inference=inference,
    )
    dds.deseq2()

    stats = DeseqStats(dds, inference=inference)
    stats.summary()

    result = stats.results_df.copy()
    result = result.reset_index().rename(columns={
        'log2FoldChange': 'log2FC',
        'pvalue': 'pvalue',
        'padj': 'padj'
    })
    return result
代码写完只是半成品,业务验证才是你的核心价值。让 Agent 汇报结果:
> 跑 run_deseq2,告诉我:
- 总基因数
- padj < 0.05 的有几个
- log2FC > 1 的有几个
- log2FC < -1 的有几个
- Top 5 上调基因名
- Top 5 下调基因名
研究者的专业核对:
- 总基因数在 1.5 万左右,符合人 RNA-seq 的正常规模
- 显著差异基因通常在 500 到 3000 个之间
- Top 上调里有几个他预期能看到的著名基因,这是最关键的一条
如果 Top 上调里没有一个认识的基因,几乎可以肯定分析出错了,最常见的原因是样本标签搞反了。
任务二:火山图
> 任务:实现 src/plotting.py 的 plot_volcano() 函数

需求:
- 输入:差异分析结果 DataFrame(gene_id / gene_name / log2FC / padj)
- 输出:matplotlib Figure 对象
- 要求:
  - X 轴:log2FC,范围 [-5, 5]
  - Y 轴:-log10(padj),范围 [0, 50]
  - 颜色规则(业务判断):
    - 红色:padj < 0.05 AND log2FC > 1(显著上调)
    - 蓝色:padj < 0.05 AND log2FC < -1(显著下调)
    - 灰色:其他
  - 在显著基因上标注 gene_name(避免重叠,用 adjustText 库)
  - 标题:"Volcano Plot: Treatment vs Control"
  - 阈值线:log2FC = ±1(虚线)、padj = 0.05(虚线)

返回 Figure,不要保存(保存由调用方负责)。
Agent 的实现:
# src/plotting.py
import matplotlib.pyplot as plt
import numpy as np
from adjustText import adjust_text

def plot_volcano(deg_df):
    df = deg_df.copy()
    df['neg_log_padj'] = -np.log10(df['padj'].clip(lower=1e-50))

    # 业务规则:颜色分类
    df['color'] = 'gray'
    df.loc[(df['padj'] < 0.05) & (df['log2FC'] > 1), 'color'] = 'red'
    df.loc[(df['padj'] < 0.05) & (df['log2FC'] < -1), 'color'] = 'blue'

    fig, ax = plt.subplots(figsize=(10, 8))
    ax.scatter(df['log2FC'], df['neg_log_padj'],
               c=df['color'], s=10, alpha=0.6)

    # 阈值线
    ax.axvline(x=1, color='gray', linestyle='--', alpha=0.5)
    ax.axvline(x=-1, color='gray', linestyle='--', alpha=0.5)
    ax.axhline(y=-np.log10(0.05), color='gray', linestyle='--', alpha=0.5)

    # 标注 Top 基因
    sig = df[(df['padj'] < 0.05) & (df['log2FC'].abs() > 1)]
    top = sig.reindex(sig['padj'].abs().sort_values().head(15).index)
    texts = []
    for _, row in top.iterrows():
        texts.append(ax.text(row['log2FC'], row['neg_log_padj'],
                             row['gene_name'], fontsize=8))
    adjust_text(texts, ax=ax)

    ax.set_xlabel('log2 Fold Change')
    ax.set_ylabel('-log10(padj)')
    ax.set_title('Volcano Plot: Treatment vs Control')
    ax.set_xlim(-5, 5)
    return fig
整合与运行
main.py 把所有模块串起来:
# main.py
from pathlib import Path
from src.loader import load_counts, load_samples
from src.qc import filter_low_expression, run_pca
from src.analysis import run_deseq2, apply_thresholds, lfc_shrinkage
from src.plotting import plot_volcano, plot_heatmap
from src.report import render_report

def main():
    print("加载数据...")
    counts, gene_meta = load_counts('data/counts.csv')
    samples = load_samples('data/samples.csv')

    print("质控...")
    counts_filtered = filter_low_expression(counts, min_total=10)
    pca_fig = run_pca(counts_filtered, samples)

    print("差异分析...")
    deg = run_deseq2(counts_filtered, samples)
    deg = lfc_shrinkage(deg)

    print("生成报告...")
    volcano_fig = plot_volcano(deg)
    heatmap_fig = plot_heatmap(deg, counts_filtered)

    sig_deg = apply_thresholds(deg, padj=0.05, log2fc=1)

    render_report(
        pca_fig=pca_fig,
        volcano_fig=volcano_fig,
        heatmap_fig=heatmap_fig,
        sig_deg=sig_deg,
        output_path='output/report.html'
    )

    print(f"完成,显著差异基因:{len(sig_deg)} 个")
    print("报告:output/report.html")

if __name__ == '__main__':
    main()
跑一遍:
python main.py输出:
加载数据...
质控...
差异分析...
生成报告...
完成,显著差异基因:1247 个
报告:output/report.html
打开 output/report.html,一份论文级别的报告就生成了:原本一到两天的人工流程,压到五分钟以内。
换个领域,结构完全一样
把基因换成你领域的分析对象,流水线照样成立:
| 领域 | 输入 | 分析方法 | 输出 |
|---|---|---|---|
| 生物信息 | RNA-seq | DESeq2 | 火山图 |
| 用户增长 | 用户行为日志 | A/B 测试 | 转化漏斗 |
| 销售归因 | 多渠道销售 | Shapley value | 归因报告 |
| 金融分析 | 股票行情 | 时间序列 | 收益归因 |
| 制造质量 | 传感器数据 | SPC 控制图 | 异常预警 |
核心套路永远是:导入、质控、分析、报告。
领域知识清单:数据、分析、报告三层
不管做什么分析,下面这些都属于你的业务知识,Agent 不会替你知道:
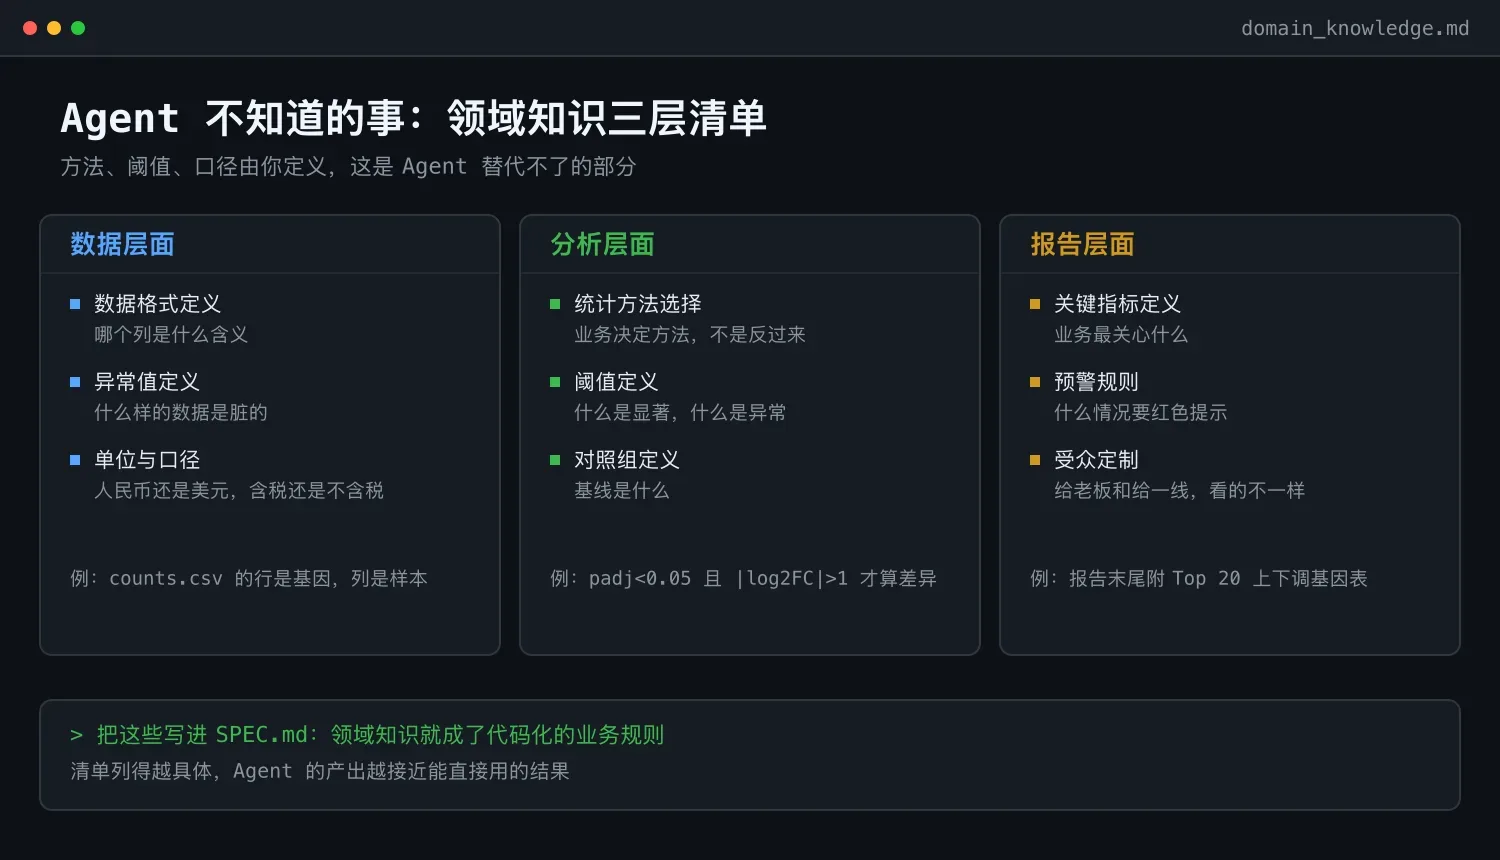
- 数据层面:数据格式定义(哪个列是什么含义)、异常值定义(什么样的数据是脏的)、单位与口径(人民币还是美元,含税还是不含税)
- 分析层面:选什么统计方法(业务决定方法)、阈值定义(什么是显著、什么是异常)、对照组定义(基线是什么)
- 报告层面:关键指标定义(业务最关心什么)、预警规则(什么情况要红色提示)、受众定制(给老板和给一线,看的不一样)
把这些写进 SPEC.md,你的领域知识就成了代码化的业务规则,Agent 每一步都有据可依。
让流水线可复现
科研最重要的原则之一:别人能复现你的结果。
**用 environment.yml 锁定环境。**让 Agent 帮你生成:
> 看看当前 pip 环境的所有包版本,生成 requirements.txt,
  再生成一个 environment.yml(conda 用)。
  注释说明每个包的用途。
**用 Snakemake 或 Nextflow 管理 DAG。**复杂流水线(超过 10 步),让 Agent 重构:
> 把 main.py 改造成 Snakemake 工作流,
  每个步骤是一个 rule,明确输入输出。
  生成 Snakefile。
**数据版本控制用 DVC。**数据经常变的话:
pip install dvc
dvc init
dvc add data/counts.csv
git add counts.csv.dvc .gitignore
git commit -m "数据版本控制初始化"
每次数据更新:
dvc add data/counts.csv
git commit -am "更新到 v2 数据"
requirements、Snakemake、DVC 三件套齐了,任何人在任何机器上都能重跑出同一份报告。
常见坑与排错
**坑 1:内存爆炸(基因乘样本太多)。**让 Agent 改用稀疏矩阵或分块处理:
> counts_df 太大,内存不够。
  改用 scipy.sparse.csr_matrix 存储,
  或者按基因分块处理。
**坑 2:DESeq2 跑得巨慢。**业务上可能要减少假阳性,那就预过滤更狠:
# 业务判断:低于 10 个 read 的根本不该分析
counts_filtered = counts[counts.sum(axis=1) >= 10]
**坑 3:样本名对不上。**最常见的低级错误,让 Agent 加严格校验:
# 业务规则:counts 列名必须和 samples 索引完全一致
assert set(counts.columns) == set(samples.index), "样本名不匹配"
**坑 4:中文报告乱码。**matplotlib 的中文字体问题:
plt.rcParams['font.sans-serif'] = ['Arial Unicode MS']  # Mac
# plt.rcParams['font.sans-serif'] = ['Microsoft YaHei']  # Windows
plt.rcParams['axes.unicode_minus'] = False
性能优化经验
- 小数据先试:用 100 个基因先跑通流程,再上完整 1.5 万
- 缓存中间结果:DESeq2 跑一次五分钟,存下来下次直接读
- 可视化大数据:超过 10 万点的散点图用 datashader 代替 matplotlib
这些都是经验性的业务知识:Agent 知道有这些工具,但只有你知道什么场景该用。
练习
练习 1(必做):完整跟着做一遍差异表达分析流水线,先用 Agent 生成的假数据跑通。
练习 2(推荐):把套路用在你自己的领域。做销售的换成 A/B 测试报告,分析两个版本转化率差异;做产品的换成用户留存分析,画留存曲线加同期群分析;做质量的换成 SPC 控制图,监控生产参数。
练习 3(进阶):加一个自动结论生成,让 Agent 跑完分析后,用 LLM 把数字翻译成一段中文结论,附在报告末尾。
练习 4(思考):对照上文的领域知识清单,你的领域能列出多少条?列得越多,你越值钱。
要点回顾
- 科研数据分析流水线一共四步:导入、质控、分析、报告。
- 统计方法、阈值、对照是领域知识,Agent 不知道。
- 业务验证看三点:总基因数、显著基因数量级、Top 基因里有几个你认识的。最后一点最关键,一个都不认识,多半是样本标签反了。
- 流水线通用,套到任何"数据到报告"的领域都行。
- 可复现性靠 requirements、Snakemake、DVC 三件套。
- 领域知识清单分数据、分析、报告三层,是你的护城河。
参考
- pydeseq2 文档:https://pydeseq2.readthedocs.io
- matplotlib:https://matplotlib.org
- Snakemake:https://snakemake.readthedocs.io
- 案例为教学简化版,真实 RNA-seq 流程更复杂