字节笔记本
2026年10月6日 · 约 10 分钟读完
Agentic Coding 15:内容创作者的自动化工厂
本文是「Agentic Coding」系列的又一篇实战:这一系列的方法论始终是同一条,把你的领域知识写成规格,让 Agent 替你写完所有代码。这一篇面向自媒体、视频博主、播客主这类内容创作者,目标是搭一座自动化内容工厂:从一段原始视频出发,自动产出字幕、切片、封面和多平台文案,而 Agent 负责写工厂里的全部代码。
创作者的重复劳动:每周 15 小时花在哪
设想一位每周更新一期 30 分钟讲解视频的知识博主。拍完之后,她每周还要投入大约 15 小时做后期:2 小时剪辑,3 小时做字幕,2 小时做封面,4 小时给不同平台写文案,4 小时把内容分发到 B 站、抖音、YouTube、小红书和播客五个渠道。这些活没有一件需要灵感,却件件都在耗时间。
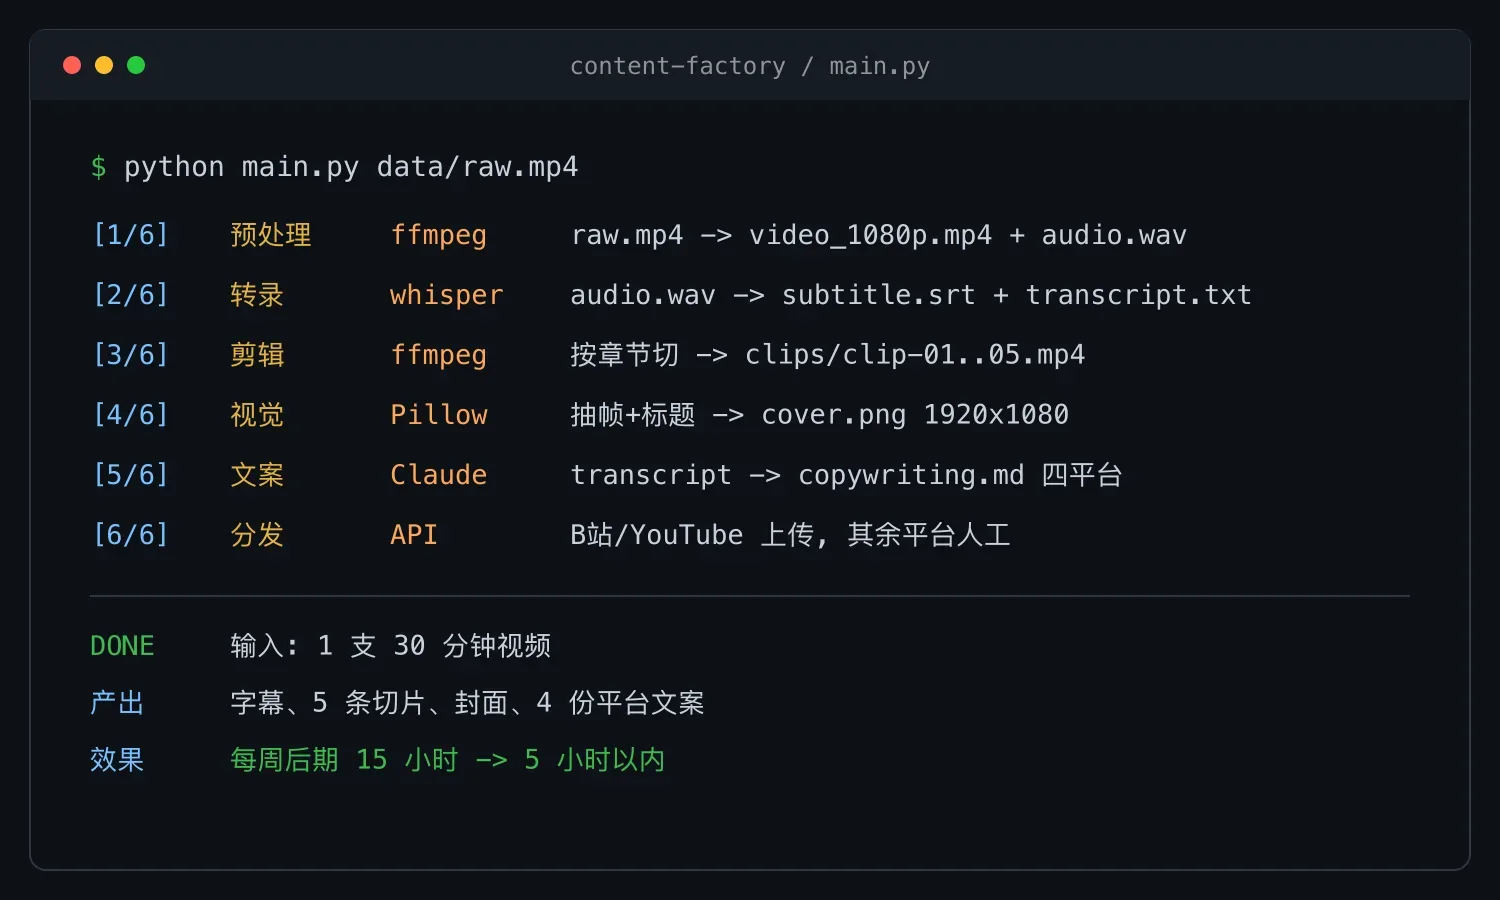
工厂的目标很直接:输入 raw.mp4,输出一套平台适配的内容包,把每周 15 小时的后期压到 5 小时以内。
动手之前,先想清楚 Agent 不知道什么,这决定了创作者在这条流水线里的位置:
- 哪些片段是值得剪成短视频的高光时刻;
- 不同平台的标题风格,B 站吃长尾词,抖音要钩子,小红书要种草感;
- 封面配色要符合个人 IP;
- 章节切分点按内容逻辑走,而不是按时间均分。
Agent 能批量生成 100 个标题,但只有创作者本人知道哪一个符合自己的人设。这就是领域知识带来的杠杆。
六个模块组成流水线
内容工厂拆成六个模块:预处理用 ffmpeg 把素材转码成 1080p 标准格式并提取音轨;转录用本地 whisper 模型生成 SRT 字幕和纯文本;剪辑按章节把长视频切成 3 到 5 条 1 到 3 分钟的短片,开头加黑场和标题字幕;视觉模块生成 1920x1080 封面图和 GIF 预览;文案模块产出各平台文案;分发模块用官方 API 上传,没有开放 API 的平台提示人工处理。
核心设计思想只有一句话:模块之间用文件传递。每个模块独立可测,坏了一起单独修;audio.wav、subtitle.srt、transcript.txt 这些中间产物都是明文文件,随时可以人工检查。
先写规格,再让 Agent 写代码
动手之前,先把项目规格写成三段:R 是背景,交代输入输出;F 是功能,逐模块列需求,业务规则单独标出;C 是验收标准,给出可检验的数字。规格里的业务规则长这样:原视频超过 1080p 就降采样以省存储;每条切片开头加 1 秒黑场和标题字幕;封面主色用人设色;四份平台文案必须各有差异,不许复制粘贴。验收标准长这样:字幕准确率超过 95%,用前 2 分钟人工核对;切片无破碎句子;总耗时小于 20 分钟。
把模糊的偏好写成可执行约束,是写规格的关键。「标题要好一点」没法执行,「抖音版标题不超过 20 字,前 5 字必须有冲突或悬念」Agent 就能照办。
转录:whisper 加一份业务词库
转录模块的任务提示词写明:输入 audio.wav,用 openai-whisper 的本地 medium 模型,中文识别质量好且不太慢;输出 SRT 字幕和纯文本;跑完汇报转录字数和用时。Agent 几十行就能交付:
# src/transcribe.py
import whisper
from datetime import timedelta

def transcribe(audio_path, model_size="medium"):
    model = whisper.load_model(model_size)
    result = model.transcribe(audio_path, language='zh')
    with open('output/subtitle.srt', 'w', encoding='utf-8') as f:
        for i, seg in enumerate(result['segments'], 1):
            start = str(timedelta(seconds=int(seg['start'])))
            end = str(timedelta(seconds=int(seg['end'])))
            f.write(f"{i}\n{start} --> {end}\n{seg['text'].strip()}\n\n")
    return result['text']
真正的价值在业务验证。博主核对前 2 分钟字幕,发现「AI Agent」被识别成了「爱 爱金特」,自己的口头禅也经常丢字。解法不是换模型,而是给 whisper 加业务词库,用 initial_prompt 引导模型识别专业术语:
result = model.transcribe(
    audio_path,
    language='zh',
    initial_prompt="以下是专业术语:AI Agent、LLM、GPT、Claude、提示词、智能体、token、上下文"
)
一行参数,术语识别立刻正确。通用工具加业务词库,这是内容流水线里反复出现的模式。
封面:抽帧、蒙层与人设水印
封面模块的规则全部来自博主的经验:在视频 25% 时间点抽帧,那里通常是内容核心;叠加暗色蒙层保证文字可读;标题超过 12 字自动换行;右下角压上固定的账号水印。Agent 用 ffprobe 读时长、ffmpeg 抽帧、Pillow 合成,一次就能写对。唯一的坑是中文字体路径因系统而异,最稳的方案是项目里自带一份开源的思源黑体,跨平台不再报错。
文案:领域知识最密集的一环
多平台文案是最能体现领域知识的地方,四份文案各有各的规矩:B 站版标题 12 到 20 字、含关键词、不标题党,简介第一行必须是钩子,还要从字幕自动提取章节时间戳;抖音版标题不超过 20 字且前 5 字要有冲突或悬念,正文 50 到 80 字、结尾留问句;小红书版走种草风格;YouTube 英文版先翻译再做 SEO 优化。「前 5 字必须有冲突」这类规则,Agent 永远不会自己想到,全靠创作者写进任务提示词。
实现层面反而简单:读入 transcript.txt 和字幕时间轴,调一次 Claude API(示例里用的是 claude-sonnet-4-5),让它按模板把四份文案写进 copywriting.md。
验证的三个维度与人工红线
内容项目的验收和代码项目不同,要看创意质量,分三个维度:准确度,字幕有没有错别字、术语对不对;吸引力,标题有没有点击欲、文案有没有平台特色;一致性,符不符合人设,配色和文风统不统一。
人工核对清单同样具体:字幕前 2 分钟逐字核对人名、术语和数字;每个标题问一遍自己「我会点吗」;封面发到手机上看小屏效果,不是在电脑上看;文案和自己往期的内容对比,避免重复套路。红线只有一条:错别字和事实错误会直接砸招牌,Agent 写的文案必须人工过一遍再发。
人设手册:把风格写成配置
创作者最重要的领域资产是人设,而人设可以代码化。写一份人设手册,贴进所有与文案相关的提示词:
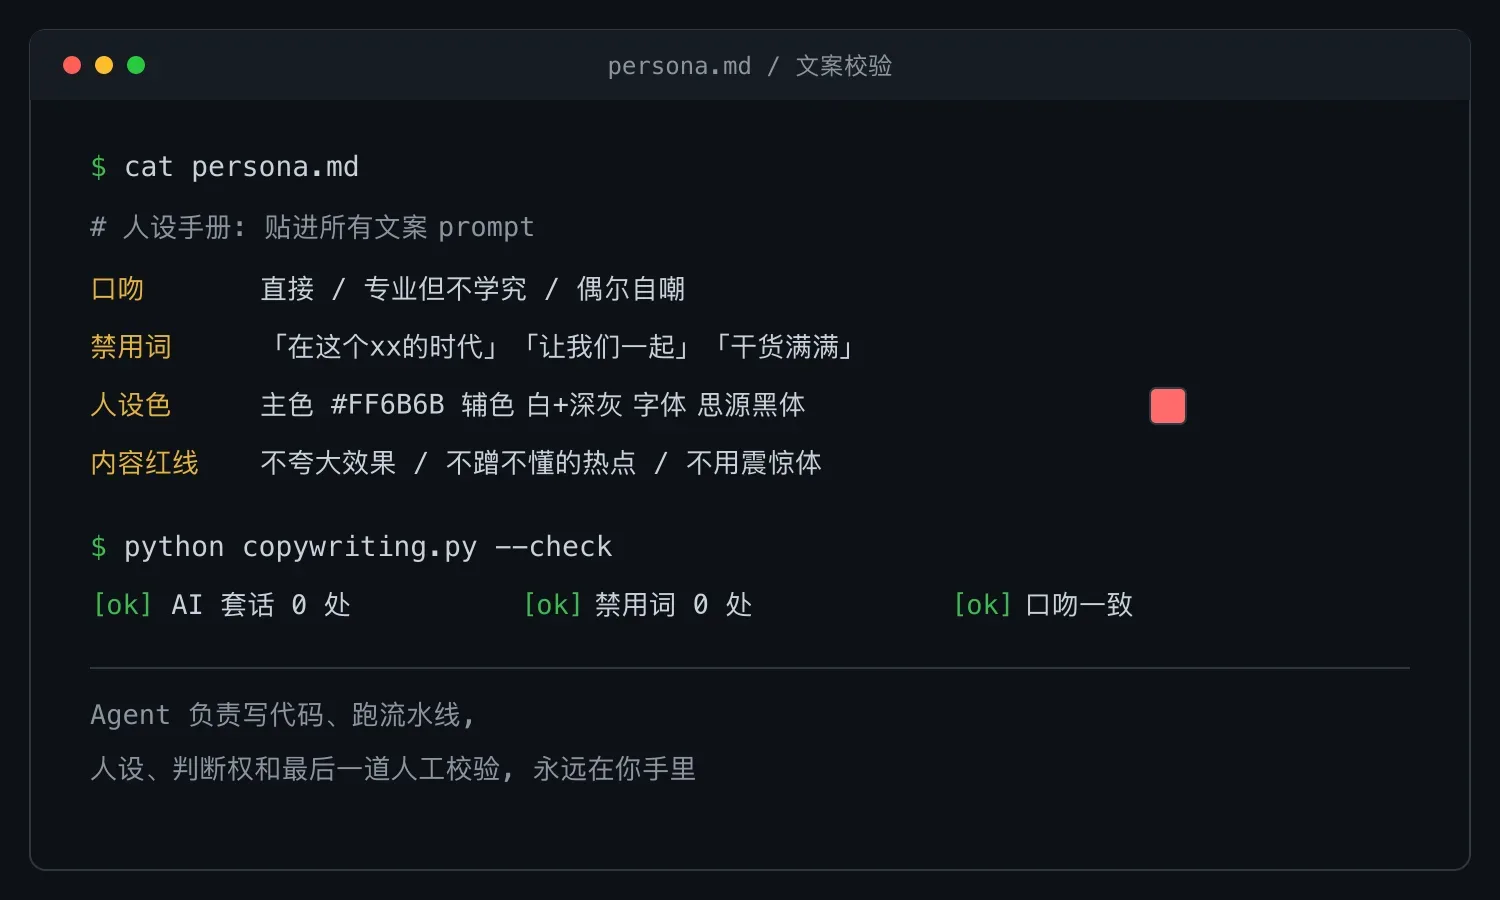
手册里写清楚口吻,直接、专业但不学究、偶尔自嘲;禁用词,「在这个 xx 的时代」「让我们一起」「干货满满」这类 AI 套话;人设色,主色 #FF6B6B,辅色白色加深灰,字体思源黑体;以及内容红线,不夸大效果、不蹭不懂的热点、不用震惊体。把这份手册喂给 Agent,它生成的文案立刻「像你写的」。这是人设的代码化,也是内容创作者真正的护城河。
常见坑与解法
- whisper 太慢:坚持用 medium 不上 large,中文场景 medium 够用;追求速度换 faster-whisper 的加速版。
- 长视频字幕时间轴漂移:每 10 分钟切一段分开转录,再拼接结果。
- ffmpeg 没安装:Mac 用 brew install ffmpeg,Windows 去 ffmpeg.org 下载并加入 PATH。
- 中文字体找不到:项目里带开源思源黑体,别依赖系统字体路径。
- 文案 AI 味重:把「在这个快节奏的时代」「让我们一起」等套话列进禁用清单,并在提示词里声明自己的口吻。
进阶玩法
跑通主流程之后还有四个扩展方向:写一个批量脚本,给 50 期历史视频补齐文案;每期生成 5 个标题候选发动态投票,用真实数据做 A/B 测试;让 Agent 从转录稿里挑出 5 句 30 字以内、单独成立也有传播力的金句,生成金句海报;用 YouTube Data API 拉回过去 30 天的点击率和完播率,分析哪类标题和封面效果更好,再把结论写回人设手册。
要点回顾
- 内容工厂是一条六模块流水线:预处理、转录、剪辑、视觉、文案、分发,模块之间用文件传递。
- 人设、口吻、平台风格、专业词库这些业务知识,Agent 不会自己有,必须写进规格和提示词。
- 内容项目验证看三个维度:准确度、吸引力、一致性。
- 错别字和事实错误等于招牌事故,Agent 产出的文案必须人工把关。
- 人设手册代码化,是内容创作者的护城河。
参考链接:
- whisper:https://github.com/openai/whisper
- faster-whisper:https://github.com/SYSTRAN/faster-whisper
- Pillow:https://python-pillow.org
- ffmpeg:https://ffmpeg.org