字节笔记本
2026年10月6日 · 约 28 分钟读完
AI 工作流专栏 02:LLM 到 MCP 五大概念
本文是 AI 工作流专栏的第 2 篇。你看任何一篇 AI 技术文章、任何一个招聘 JD,都绕不开五个词:LLM、Prompt、RAG、Agent、MCP。它们是 AI 工作流工程师的"工作语言"。本篇用一个统一的类比把这五个概念串起来,让你过目不忘,再也不被术语唬住。
本篇你将学到:
- 五大核心概念的统一直观类比
- 每个概念的小白定义、专业定义、代码示例与常见误区
- 五者之间的关系(谁包含谁、谁依赖谁)
- 一张全景图把整个 AI 工作流串起来
一、先记住这一个类比,五大概念全通
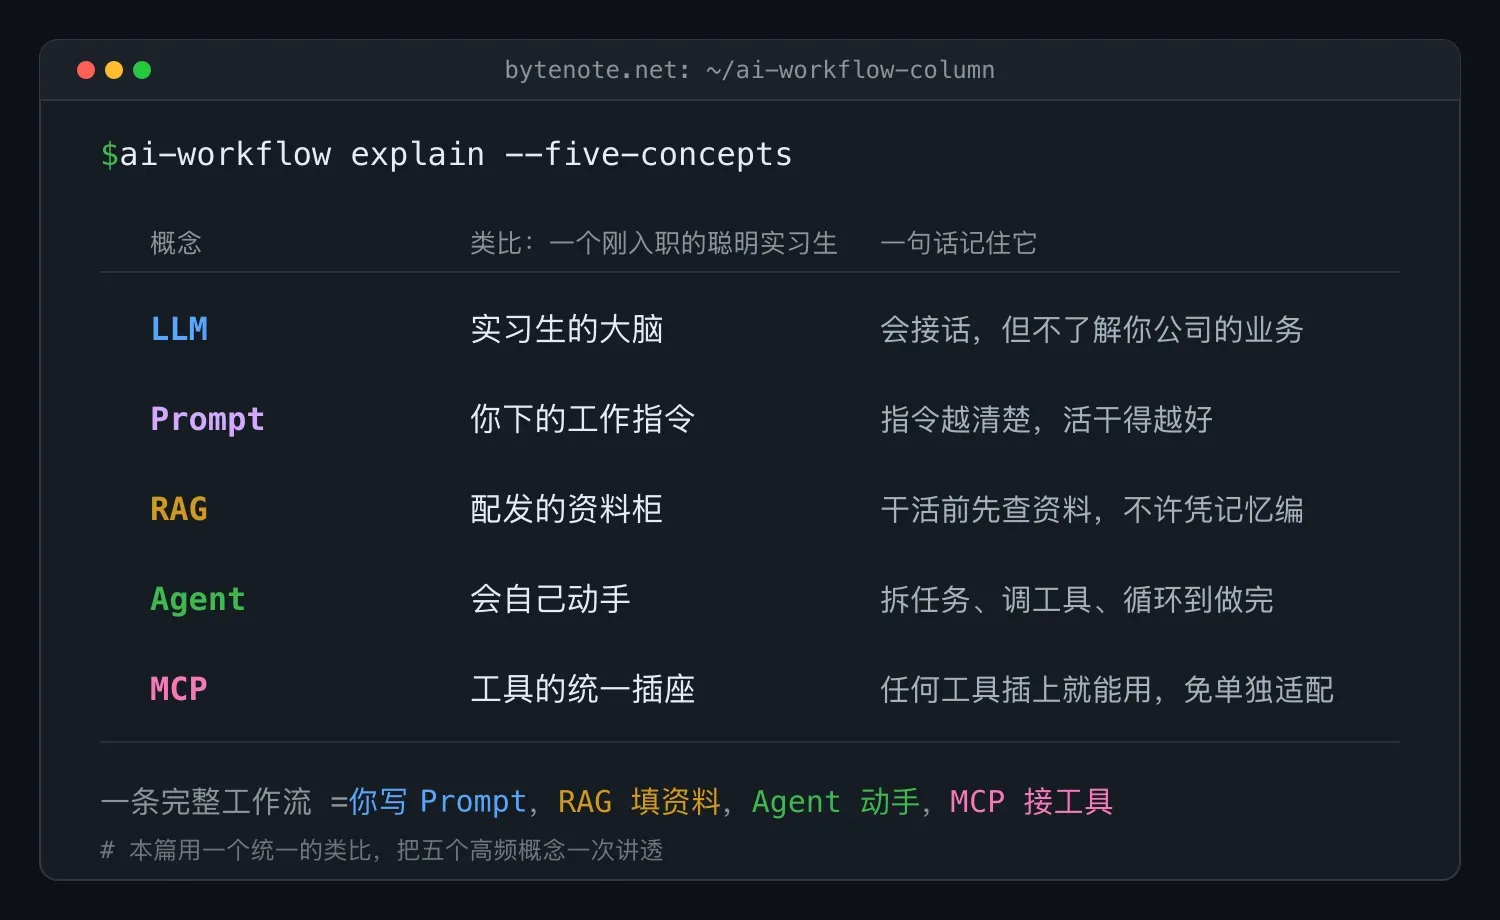
把 AI 工作流系统想象成"一个刚入职的聪明实习生":
| 概念 | 类比 | 一句话 |
|---|---|---|
| LLM | 实习生本人的"大脑" | 他天生聪明,但什么都不懂,需要你教 |
| Prompt | 你给他下的"工作指令" | 指令越清楚,他干得越好 |
| RAG | 你给他配的"参考资料柜" | 干活前先让他查资料,别凭记忆瞎编 |
| Agent | 他能"自己拆任务、用工具"的能力 | 你说"帮我订机票",他自己去查航班、比价、下单 |
| MCP | 公司统一的"工具插座标准" | 不管什么工具,插上就能用,不用每个单独接 |
记住这张表,接下来逐个深入。
二、概念 1:LLM(大语言模型),AI 的"大脑"
2.1 小白定义
LLM 就是一个读过整个互联网、能根据上文"接话"的超级大脑。你给它一段话,它预测"下一个最可能出现的字是什么",一个字一个字接下去,就组成了回答。
2.2 专业定义
LLM(Large Language Model,大语言模型)是一种基于 Transformer 架构的神经网络,通过"预测下一个 token"的方式生成文本。它先在海量文本上做无监督预训练(学语言规律),再用指令微调(学听人话)和 RLHF(学讨人喜欢)变成可用助手。
主流 LLM 一览(2025 至 2026):
| 厂商 | 模型 | 特点 | API 价格(输入/输出,每百万 token) |
|---|---|---|---|
| OpenAI | GPT-4o / GPT-4.1 | 综合最强,生态最好 | $2.5 / $10 |
| Anthropic | Claude 4 / Claude 3.5 | 长文本、写代码强 | $3 / $15 |
| Gemini 2.5 Pro | 多模态、长上下文 | $1.25 / $5 | |
| 深度求索 | DeepSeek V3 / R1 | 国产之光,便宜,推理强 | ¥1 / ¥2(缓存命中 ¥0.1) |
| 阿里 | Qwen 3 | 开源生态好,中文强 | ¥0.5 至 ¥2 |
| 智谱 | GLM-4 | 国产合规友好 | ¥1 至 ¥5 |
2.3 关键子概念:Token
Token 是 LLM 处理和计费的最小单位。它不是字,也不是词,而是介于两者之间的"片段"。
英文: "Hello world"   ->  ["Hello", " world"]           -> 2 tokens
中文: "你好世界"      ->  ["你", "好", "世", "界"]        -> 4 tokens(约)
长词: "unbelievable" ->  ["un", "bel", "ieve", "able"]  -> 4 tokens
经验估算:
- 1 个中文字约等于 1.2 到 2 个 token(取决于分词器)
- 1 个英文单词约等于 1 到 1.5 个 token
- 粗略感受一下量级:按主流定价,1 万元人民币大约能处理 1 亿到 10 亿 token,具体看用哪家模型
2.4 代码示例(Python)
# 用 OpenAI 的 tiktoken 库看一句话有多少 token
import tiktoken

enc = tiktoken.encoding_for_model("gpt-4o")
text = "我爱学习 AI 工作流,争取半年后拿远程 offer"
tokens = enc.encode(text)
print(f"文本:{text}")
print(f"Token 数:{len(tokens)}")
print(f"Token 列表:{tokens}")
print(f"解码回原文:{enc.decode(tokens)}")
输出大概是:
文本:我爱学习 AI 工作流,争取半年后拿远程 offer
Token 数:12
2.5 常见误区
- "LLM 是一个数据库,你问它什么它都知道":错。它只是"会接话",并没有存储事实,所以会编造(幻觉)。
- "模型越大越准":不一定。GPT-4 比 GPT-3.5 强,但在你的小业务上,一个微调过的小模型可能更准更便宜。
- "LLM 会一直记得上下文":错。每个模型有上下文窗口(如 GPT-4o 是 128k token),超了就"忘记"前面。
三、概念 2:Prompt(提示词),你给 AI 的"工作指令"
3.1 小白定义
Prompt 就是你跟 LLM 说的话。同样一个 LLM,Prompt 不同,效果天差地别。
举个例子,同一个 GPT-4o:
| Prompt | 回答质量 |
|---|---|
| "写个文案" | 一段泛泛而谈的废话 |
| "你是一个 10 年经验的小红书运营,请为一款主打'敏感肌可用'的防晒霜写 3 条种草文案,每条 100 字以内,要带话题标签,语气像闺蜜推荐" | 三条精准可用的高质量文案 |
差别就在于指令的精确度。
3.2 专业定义
Prompt Engineering(提示词工程)是指通过设计、优化输入给 LLM 的文本,引导它产生符合预期的输出。它是一种"用自然语言编程"的技能。
一个工业级 Prompt 通常包含 5 个部分:
① 角色设定(Role):你是一个资深 XX 专家
② 任务描述(Task):请完成 XX 工作
③ 上下文(Context):背景信息是 XX
④ 输出格式(Format):请用 JSON 输出,字段包含 XX
⑤ 约束与示例(Rules):不要 XX;参考示例 XX
3.3 代码示例:差 Prompt 与好 Prompt
from openai import OpenAI
import os

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

# 差 Prompt
bad_prompt = "写个产品介绍"

# 好 Prompt
good_prompt = """你是一个有 10 年经验的 3C 数码文案专家。

【任务】请为下面这款产品写一段电商详情页开头文案。

【产品信息】
- 名称:极光 Pro 无线鼠标
- 卖点:4000Hz 回报率、75g 超轻量化、磁吸充电、续航 120 小时
- 目标人群:电竞玩家和设计师

【输出要求】
1. 字数 150-200 字
2. 用"痛点 + 解决方案 + 数据支撑"结构
3. 语气专业但不枯燥,像数码博主测评
4. 不要用"颠覆""革命性"等夸张词

【参考示例】
"普通鼠标拖泥带水?极光 Pro 用 75g 极轻机身 + 4000Hz 回报率,让你每一次拉枪都快人一步……"
"""

def call(prompt):
    r = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
    )
    return r.choices[0].message.content

print("=== 差 Prompt 输出 ===")
print(call(bad_prompt))
print("\n=== 好 Prompt 输出 ===")
print(call(good_prompt))
跑一下就能直观感受差距。Prompt 工程还有不少进阶技巧(CoT、Few-shot、Self-Consistency),值得单独深挖,本篇不展开。
3.4 常见误区
- "Prompt 越长越好":错。无关信息会分散注意力,让输出变差。精准大于冗长。
- "Prompt 写一次就能用一辈子":错。换模型、换业务场景都要重新调。
- "Prompt 工程师是个独立岗位":现在已经基本不是了。Prompt 是 AI 工作流工程师的基本功,不是单独的岗位。
四、概念 3:RAG(检索增强生成),给 AI 配个"资料柜"
4.1 小白定义
RAG 的思路:干活前先查资料,别凭记忆瞎编。
LLM 的"记忆"(训练数据)是静态的、公共的、有限的。它不知道:
- 你公司的内部文档
- 今年的最新政策
- 客户的私人订单
如果你直接问它"我们公司的退款政策是什么",它会编一个听起来很像真的假答案(这就是"幻觉")。
RAG 的做法是:先从你的资料库里检索出相关内容,再把内容塞进 Prompt,让 LLM 基于这些内容回答。这样它就有据可依了。
4.2 专业定义
RAG(Retrieval-Augmented Generation,检索增强生成)是一种将信息检索与大模型生成结合的架构:用户提问,先检索相关文档,再将文档作为上下文喂给 LLM,最后由 LLM 生成有据可依的回答。
它解决了 LLM 的三大痛点:
| LLM 的痛点 | RAG 的解法 |
|---|---|
| 知识过时(训练数据截止某天) | 实时检索最新文档 |
| 不知道私有数据 | 把私有数据做成向量库 |
| 幻觉(编造事实) | 让它"基于文档回答",并可溯源 |
4.3 RAG 的五步流水线
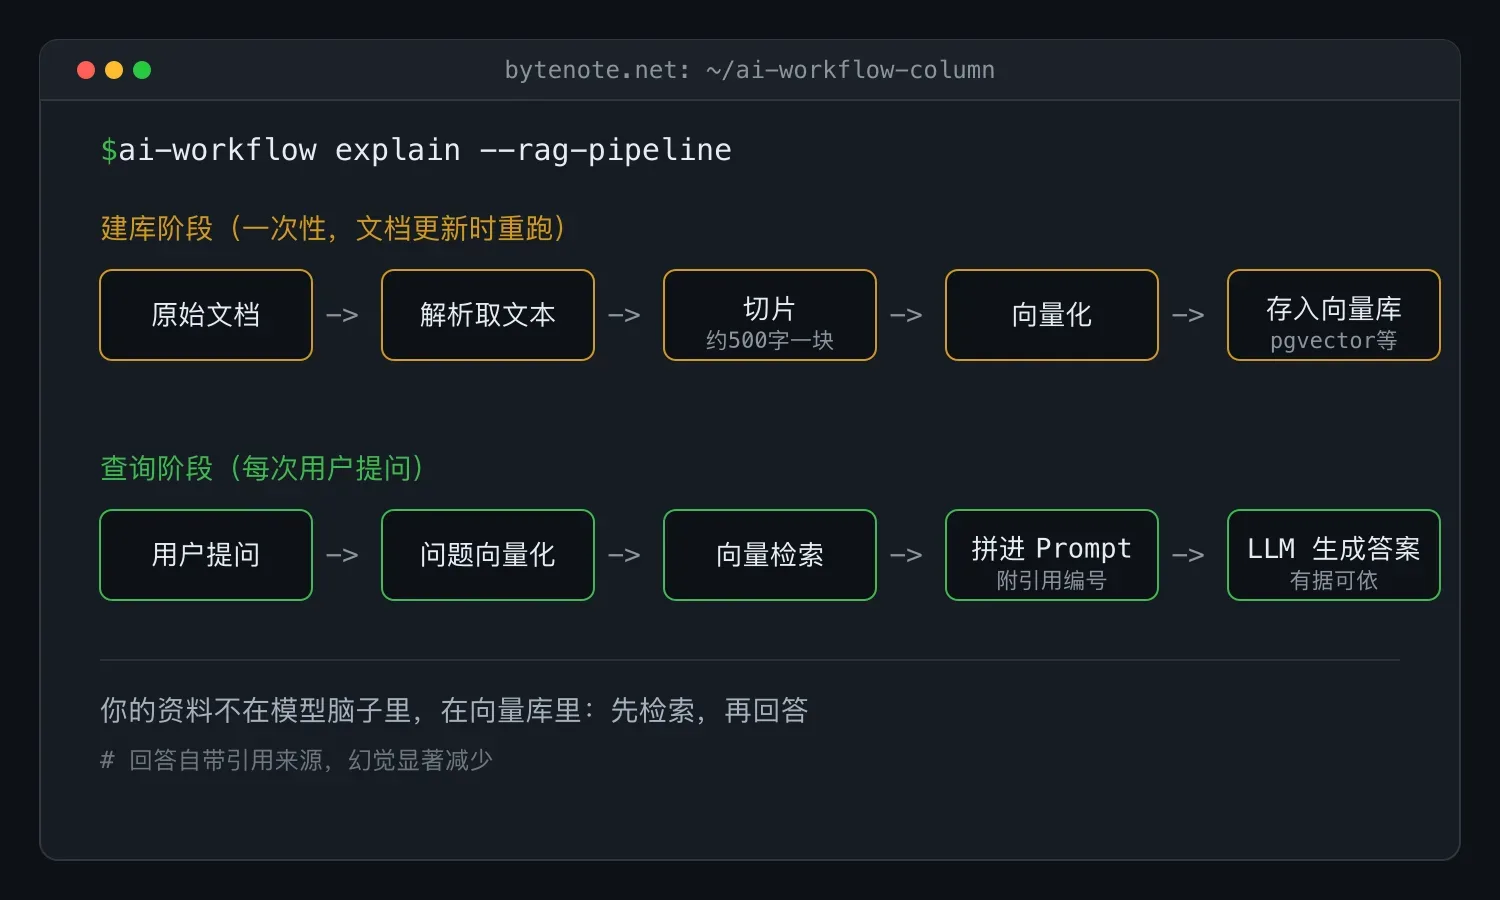
建库阶段(一次性,文档更新时重跑):
原始文档(PDF/Word/网页/数据库)
   ↓ ① 解析(提取纯文本)
   ↓ ② 切片(切成 500 字一段的 chunk)
   ↓ ③ Embedding(每段转成 1536 维向量)
   ↓ ④ 存入向量数据库(pgvector / Pinecone / Qdrant)
查询阶段(每次用户提问):
用户提问 "退款政策是什么?"
   ↓ 问题 Embedding(问题也转成向量)
   ↓ ⑤ 向量检索(找出最相似的 5 段文档)
   ↓ 拼 Prompt(问题 + 检索到的文档)
   ↓ LLM 生成("根据文档,退款政策是……")
   ↓ 返回用户(附来源引用)
4.4 代码示例:最小 RAG(Python)
from openai import OpenAI
import os

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

# 假设这是我们检索到的相关文档片段
retrieved_docs = [
    "7 天无理由退货:商品签收后 7 天内,未拆封未使用可申请全额退款。",
    "生鲜食品、贴身衣物、定制商品不支持 7 天无理由退货。",
    "退款到账时间:原路退回,支付宝/微信 1-3 工作日,银行卡 3-7 工作日。"
]

question = "我买的内衣能退吗?"

# 关键:把检索到的文档塞进 Prompt
prompt = f"""请根据【参考资料】回答用户问题。如果资料里没有答案,请说"资料中未提及",不要编造。

【参考资料】
{chr(10).join(f'[{i+1}] {d}' for i, d in enumerate(retrieved_docs))}

【用户问题】
{question}

【回答要求】
1. 只基于参考资料作答
2. 在句末标注引用编号,例如 [2]
3. 资料不足时明确说明
"""

r = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": prompt}],
)
print(r.choices[0].message.content)
# 输出:内衣属于贴身衣物,根据参考资料[2],不支持 7 天无理由退货。
AI 不再瞎编,而是有据可依地回答,这就是 RAG 的威力。从向量库选型到检索调优,完整的 RAG 系统还有不少工程细节,本篇只负责把原理讲通。
4.5 常见误区
- "RAG 就是搜索":错。搜索只返回文档,RAG 是"检索 + 生成",会给出总结性回答。
- "有了 RAG 就不会幻觉了":错。RAG 降低幻觉,但不能消除。如果检索回来的文档本身不对、或者 LLM 误解了文档,照样会出错,所以生产环境还要配护栏和人工审核。
- "微调能替代 RAG":大多数情况下不能。微调适合"调语气/风格",RAG 适合"补知识"。两者经常一起用。
五、概念 4:Agent(智能体),会自己干活的 AI
5.1 小白定义
Agent:你给它一个目标,它自己拆任务、调工具、循环思考,直到完成。
举个对比例子:
- 普通 LLM 调用:"帮我查下北京今天天气",AI 直接回答(但它其实不知道,会编)。
- RAG:"帮我查下北京今天天气",检索天气文档再回答(但文档可能不是今天的)。
- Agent:"帮我查下北京今天天气",AI 想"我需要调天气 API",调用 get_weather("北京"),拿到真实数据后回答:"北京今天 28 度,晴"。
Agent 的核心是"会主动用工具"和"会多步思考"。
5.2 专业定义
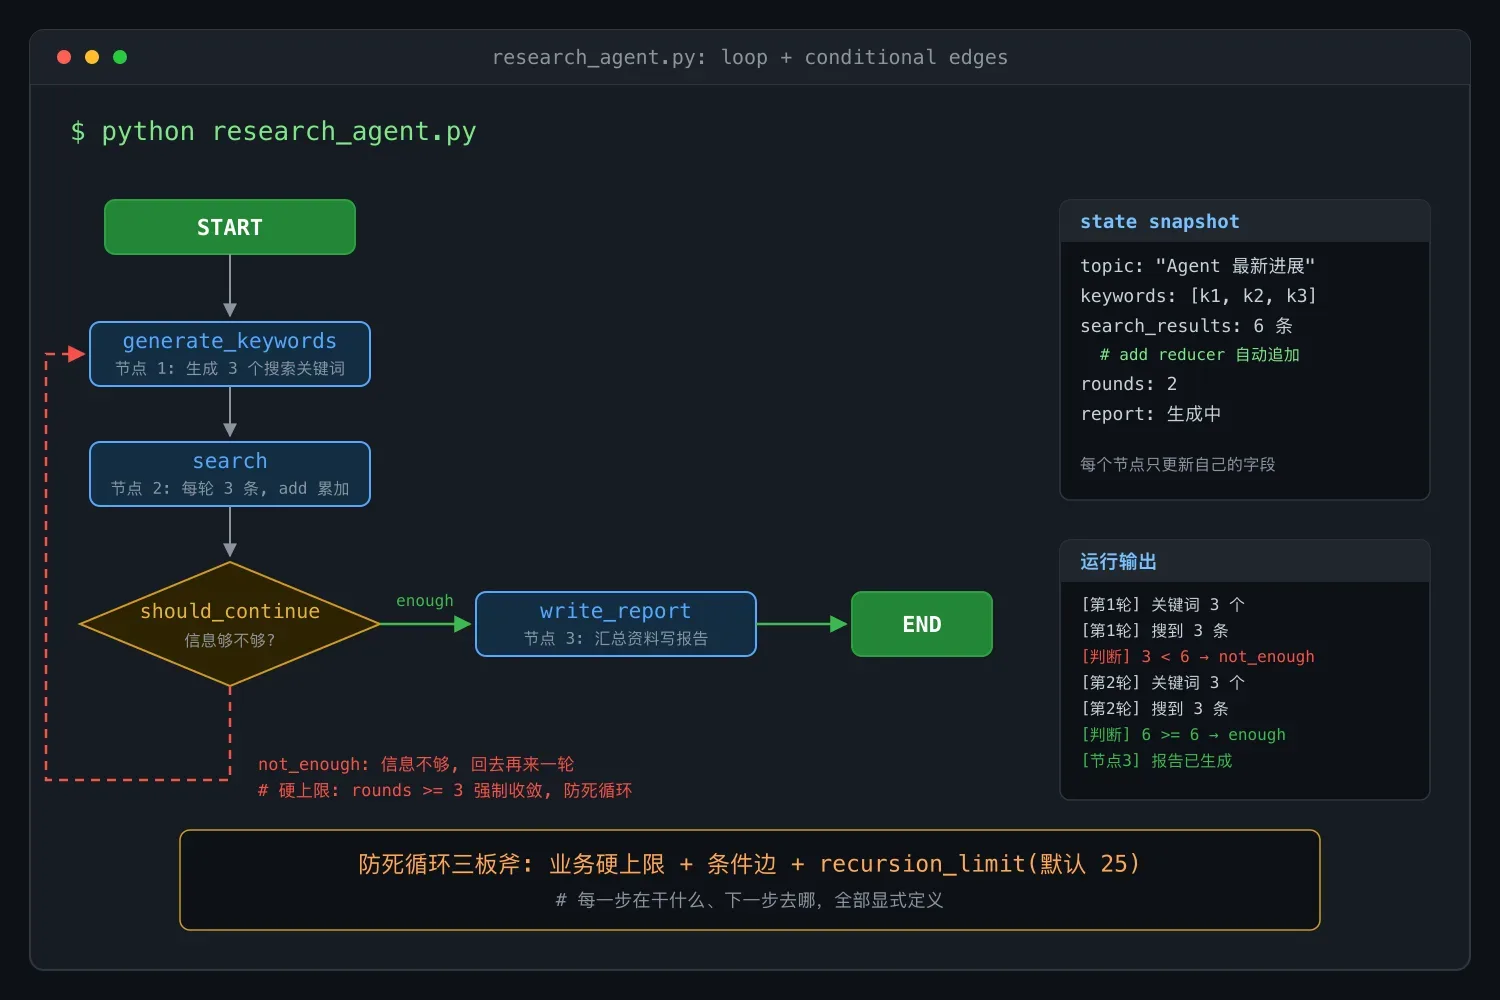
Agent(智能体)是一个以 LLM 为大脑、能自主规划、调用工具、根据反馈调整决策、循环执行直到完成目标的系统。它的核心循环叫 ReAct(Reason + Act):
Thought(思考):我该做什么?
Action(行动):调用某个工具
Observation(观察):工具返回了什么
→ 回到 Thought,继续下一步
直到 LLM 判断"任务完成",输出最终答案。
5.3 代码示例:一个最小 Agent 的思路
# 一个能查天气 + 查汇率的 Agent(思路示意,生产环境请用成熟框架)
import json

tools = {
    "get_weather": lambda city: f"{city}今天 28 度,晴",
    "get_exchange_rate": lambda cur: f"1 人民币 = { {'usd':0.14, 'eur':0.13}.get(cur) } {cur}"
}

def agent_run(user_question):
    messages = [
        {"role": "system", "content": "你是一个助手,可以调用工具:get_weather(city)、get_exchange_rate(cur)。需要工具时用 JSON 输出 {tool, args},否则直接回答。"},
        {"role": "user", "content": user_question}
    ]

    while True:  # ReAct 循环
        r = client.chat.completions.create(model="gpt-4o-mini", messages=messages)
        reply = r.choices[0].message.content

        if reply.strip().startswith("{"):  # LLM 决定调工具
            decision = json.loads(reply)  # 解析出 {"tool": ..., "args": ...}
            tool_result = tools[decision["tool"]](**decision["args"])
            messages.append({"role": "assistant", "content": reply})
            messages.append({"role": "user", "content": f"工具返回:{tool_result}"})
            continue  # 拿到工具结果,回到思考
        else:
            return reply  # 不调工具,即最终答案

print(agent_run("北京天气怎么样?美元汇率多少?"))
真实生产中你不会手写这个循环,LangGraph、OpenAI Assistants API、Anthropic 的 Tool Use 这些现成方案都把调度封装好了。
5.4 常见误区
- "Agent 就是多调几次 LLM":错。Agent 的关键是自主决策和根据反馈调整,不是简单多调几次。
- "Agent 什么都能干":错。当前 Agent 在复杂任务上可靠性不足,所以工业上常加 HITL(人工审核)兜底。
- "用了 Agent 就不用 RAG 了":错。它们经常组合使用:Agent 调用的某个工具,可能就是"查 RAG 知识库"。
六、概念 5:MCP(模型上下文协议),AI 的"USB 接口"
6.1 小白定义
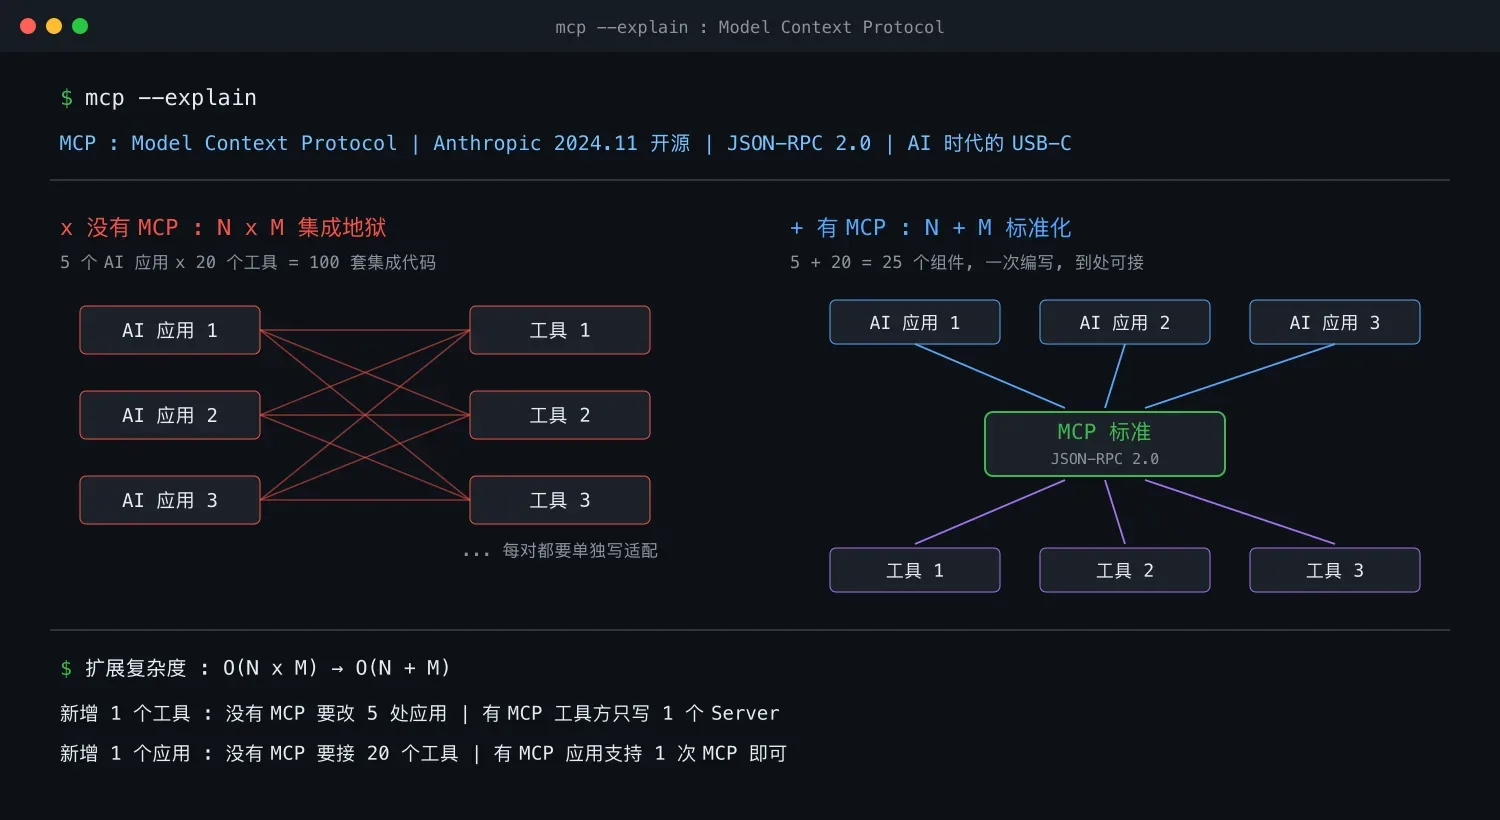
MCP 是给 AI 定的一套"统一插座标准",让任何工具、数据源插上就能用。
类比一下:以前每个工具要单独写一段代码让 AI 调用,就像每种电器各配一个充电器,乱成一团。MCP 就像 USB-C 标准,只要工具支持 MCP,AI 直接就能用,不用单独适配。
6.2 专业定义
MCP(Model Context Protocol,模型上下文协议)是 Anthropic 在 2024 年底开源的协议,定义了大模型与外部数据源、工具之间的标准通信方式。
它采用 Client-Server 架构:
AI 应用(MCP Client)
    ↕  标准协议(JSON-RPC)
MCP Server(包装了某个工具/数据源)
    ↓
真实工具:数据库 / GitHub / Slack / 文件系统 等
只要工具方提供一个 MCP Server,任何支持 MCP 的客户端(Claude Desktop、Cursor、Cline 等)都能直接用它。
6.3 为什么 MCP 重要
- 工具方:写一次 MCP Server,所有 MCP 客户端都能用,不用重复集成。
- AI 应用方:不用为每个工具单独写适配代码,"插上即用"。
- 生态:截止 2026 年已有数千个 MCP Server,覆盖数据库、GitHub、Slack、Notion、浏览器等。
6.4 代码示例:用 MCP 让 Claude 读你的本地文件
(这里只展示思路,完整实现可参考 MCP 官方文档)
# 一个最小 MCP Server,让 AI 能读本地文件夹
from mcp.server import Server
import os

server = Server("my-file-reader")

@server.tool("list_files")
def list_files(path: str):
    """列出某文件夹下的文件"""
    return os.listdir(path)

@server.tool("read_file")
def read_file(path: str):
    """读取文件内容"""
    with open(path) as f:
        return f.read()

# 启动后,Claude Desktop / Cursor 等支持 MCP 的客户端就能直接用这俩工具了
6.5 常见误区
- "MCP 是 Anthropic 私有的":错。它已开源,OpenAI、Google 也已表态支持,正在成为行业标准。
- "MCP = Function Calling":不完全。Function Calling 是"单次调用工具",MCP 是"工具发现的协议标准"。可以理解为:MCP 是工具的"App Store",Function Calling 是"调用某个 App 的方式"。
七、五大概念的关系全景图
最后用一张图把五个概念串起来,这也是整个 AI 工作流系统的标准架构:
                    ┌──────────────┐
                    │   用户输入    │
                    └──────┬───────┘
                           ↓
            ┌──────────────────────────┐
            │     Prompt(指令层)       │ ← 你写的提示词
            │  ┌────────────────────┐  │
            │  │  RAG(检索增强)    │  │ ← 检索文档塞进来
            │  └────────────────────┘  │
            └──────────────┬───────────┘
                           ↓
                  ┌─────────────────┐
                  │   LLM(大脑)    │ ← 大模型本身
                  └────────┬────────┘
                           ↓
                  ┌─────────────────┐
                  │  Agent(决策层) │ ← 决定调不调工具、怎么调
                  └────────┬────────┘
                           ↓
                  ┌─────────────────┐
                  │  MCP(工具接口)  │ ← 标准化连工具
                  └────────┬────────┘
                           ↓
                  ┌─────────────────┐
                  │ 工具/数据源      │
                  │ DB / API / 文件  │
                  └─────────────────┘
一句话总结五个概念的协作:你用 Prompt 给 LLM 下指令;为了让它有据可依,先用 RAG 检索文档;为了让它办事,给它 Agent 能力去用工具;为了能方便地接各种工具,用 MCP 做统一标准。这就是一个完整的 AI 工作流。
八、五个概念的一句话速记卡
把这张表存下来,忘了就翻一翻:
| 概念 | 一句话 | 类比 |
|---|---|---|
| LLM | 会接话的超级大脑 | 聪明但无知的实习生 |
| Prompt | 你给 AI 的工作指令 | 便签纸上的任务说明 |
| RAG | 干活前先查资料 | 给实习生配的资料柜 |
| Agent | 自己拆任务用工具 | 实习生会自己用工具干活 |
| MCP | 工具的统一插座 | USB-C 标准接口 |
九、本章小结
- LLM 是大脑,Prompt 是指令,RAG 是记忆,Agent 是双手,MCP 是插座,五个概念合起来就是一个完整的 AI 工作流系统。
- LLM 的本质是"预测下一个 token",它不是数据库,所以会幻觉。
- Prompt 不是越长越好,结构化(角色、任务、上下文、格式、约束)才稳定。
- RAG 解决"AI 不知道私有知识"的问题,五步流水线:解析、切片、向量化、检索、生成。
- Agent 的核心是 ReAct 循环:思考、行动、观察、再思考。
- MCP 是 AI 时代的 USB-C,让工具"插上即用",正在成为行业标准。
搞懂这五个概念,你已经能看懂 80% 的 AI 技术文章了。接下来要做的,是把这套类比用在自己的项目里,边做边巩固。
十、动手练习
练习 1(理解):用本文的"实习生类比",给你的非技术朋友讲解这五个概念,看他能不能听懂。如果他能听懂,说明你是真懂了。
练习 2(动手):去 claude.ai 或 chat.openai.com,分别用一句模糊指令和一条结构化指令问同一个问题(参考本文 Prompt 一节的例子),对比两者的输出质量。
练习 3(探索):去 github.com/modelcontextprotocol/servers 浏览现有的 MCP Server 列表,挑 3 个你觉得有意思的,想想它们能让 AI 干什么新事情。
十一、延伸阅读
- OpenAI Tokenizer(在线看 token 切分):https://platform.openai.com/tokenizer
- Anthropic MCP 官方文档:https://modelcontextprotocol.io
- 论文《Retrieval-Augmented Generation》(RAG 原始论文):https://arxiv.org/abs/2005.11401
- 论文《ReAct: Synergizing Reasoning and Acting》:https://arxiv.org/abs/2210.03629