字节笔记本
2026年11月7日 · 约 4 分钟读完
四家 AI 公司统一训练退出信号:一行 robots.txt
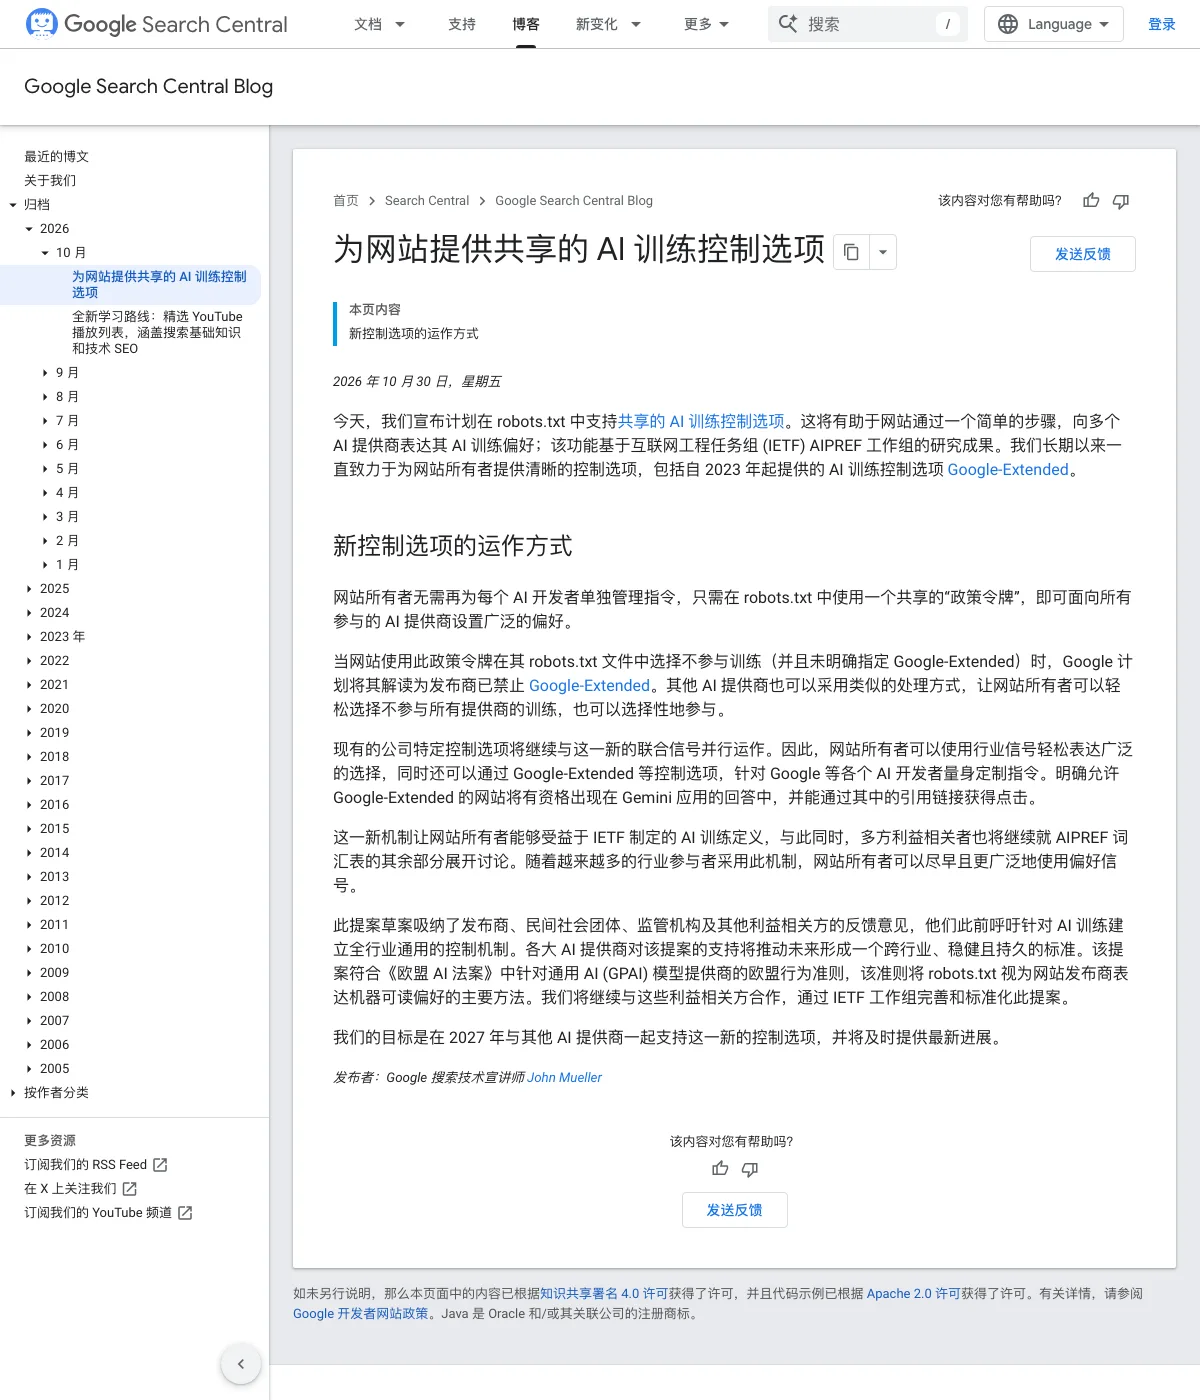
2026 年 10 月 30 日,Google、Microsoft、OpenAI、Anthropic 四家同日宣布:支持一个共享的 robots.txt 政策 token __usage_ai-training——网站管理员写一次,即可向所有参与方表达"我的内容不用于 AI 训练"的偏好。
先把最关键的性质说清楚:这还不是一个生效的机制。它的源头是 IETF 草案 draft-kelley-aipref-training-preference-signal-00(Anthropic 标准技术负责人 Kevin Kelley 提交,10 页、2027 年 5 月 3 日到期)——个人提交、未获 IETF 背书,需经 AIPREF 工作组审议;四家也要到 2027 年才陆续开始执行。现在就把这行写进 robots.txt 的网站,表达的是立场,不是立即生效的禁令。
怎么写
写法不引入新语法,遵循 RFC 9309 的既有 robots.txt 规则:
User-Agent: __usage_ai-training
Disallow: /
想给某些路径开口子,可以加 Allow: /press-kit/ 这样的例外。
最容易踩的两个坑
- 通配组不匹配这个 token:
User-agent: *那一组不会匹配__usage_ai-training——没单独写这个组,就等于没表达任何偏好; - 只面向未来:已经被抓取、已经进训练集的内容不受影响。
训练退出 ≠ grounding 退出
这是本篇最值得讲清的区分。"训练"(拿内容练模型)与"grounding"(回答时引用网页)是两件事,四家的处理并不一致:
- Microsoft 分两档:可以只禁训练、放行 grounding;页面级可用 meta 标签或 HTTP 头表达;另有 DisallowExtended 选项——只允许微软自有产品做 grounding。另外 Microsoft 2027-03-01 起停读 NoArchive / NoCache 作为训练与 grounding 信号;
- Google 默认联动:未单独处理 Google-Extended 时,共享退出信号视同禁用 Google-Extended——也会退出 Gemini 引用网页作答的 grounding,但搜索排名不受影响;
- 时间表:Microsoft 2027-02-01 起执行;Google 称 2027 年初;OpenAI"未来数月内";Anthropic 已开始开发、未给日期。
Meta 缺席,与一个欧洲注脚
四家里没有 Meta:其发言人 Andy Stone 称共同信号是"重要一步",但未承诺遵守——注意这只是未承诺,不是明确拒绝;同日 Meta 还更新了商业条款,允许向 Facebook/Instagram/WhatsApp 商业账号关联网站派爬虫并用于训练。另一个注脚:Google 称该方案符合欧盟 AI 法案下通用 AI 行为准则——robots.txt 被认可为表达机器可读偏好的主要方式。
尾注:与上周那条新闻是一体两面
上周写过纽约时报告 Brave:爬虫不报名,robots.txt 的君子协定管不住它。AIPREF 是同一枚硬币的另一面——让"表达偏好"这件事标准化。标准能不能管住所有爬虫另说,但"网站第一次有了一行写清楚偏好的统一写法",这步是真的迈出去了。顺手对照:训练退出写进 robots.txt 的行为,与 Gemini API 计费切换那种"老机制退役"不同——前者是增量协议,后者是截止日。