
字
字节笔记本
2026年11月6日 · 约 2 分钟读完
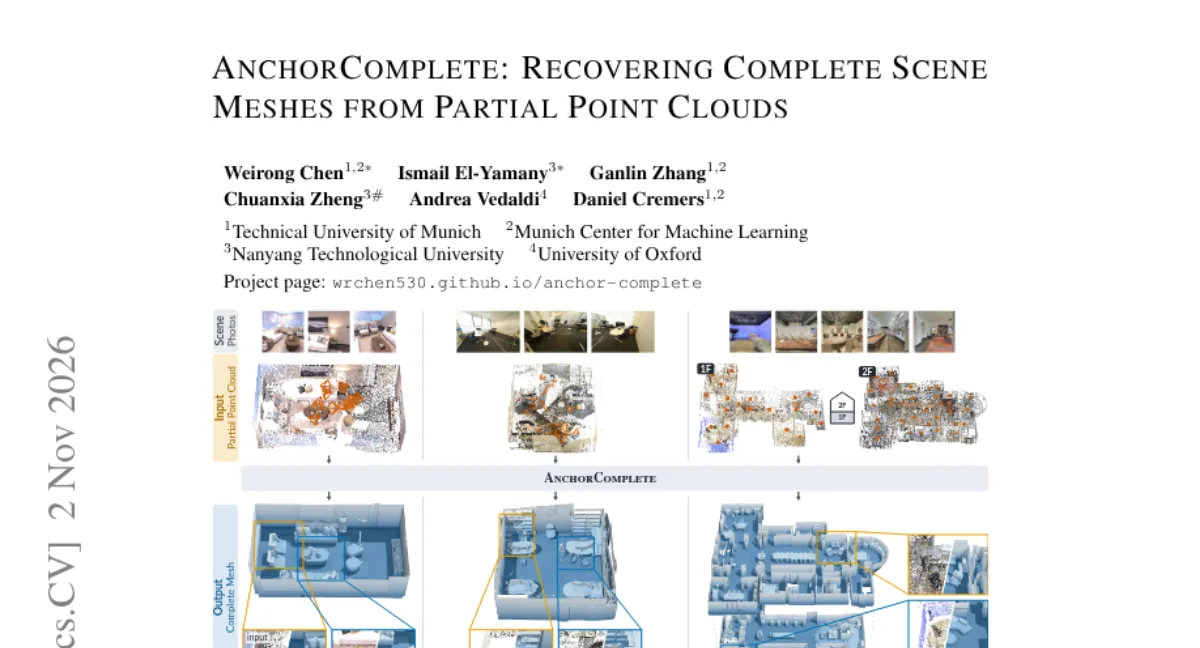
点云有洞也能补出完整场景网格:AnchorComplete 出手
API中转
¥120
DUSt3R 这类重建方法和 SLAM 系统都有个天生的产出缺陷:只能恢复看得见的表面,点云永远带着大洞。慕尼黑工业大学、牛津大学与南洋理工的 AnchorComplete(arXiv 2611.03228,作者含 Daniel Cremers 与 Andrea Vedaldi)直接瞄着这个缺陷:从局部点云生成完整场景网格,同时对观测几何保持忠实,还能适配任意场景尺度。
框架基于 TRELLIS.2,两个核心组件撑起效果。其一,局部点条件化走混合方案:全局场景 token 提供先验,可见体素注入结构潜变量做热启动,双路径锚定让生成既敢补洞又不偏离实测。其二,公制尺度的由粗到细生成:用固定物理尺寸的窗口以八叉树方式覆盖场景,每个窗口继承父级几何(0.8 热启动),窗口之间重叠四分之一,网格分辨率从此与场景大小解耦,客厅和整层楼用同一套分辨率逻辑。
成绩按论文口径:在 Replica 与 SCRREAM 数据集的稀疏视图设置下取得最佳 CD 与 F-score,N 等于 10 视图时 Replica 上 F 0.05 达 0.829,对比 NKSR 的 0.754。更实用的是跨源泛化:DA3、Pi3、COLMAP、DROID-SLAM、模拟 LiDAR 的输出都无需重训练直接吃,F 0.05 在 0.547 到 0.761 之间。消融证明优势来自点条件化而非场景级训练。
边界也要说清:只预测几何不含纹理,严重依赖上游点云质量,目前限于室内场景。对做机器人感知、数字孪生和空间计算的团队,这篇等于给「看得见的半间房」补上了「看不见的另外半间」,下游的碰撞检测与规划终于能拿到一张完整的图。
相关文章

分享: