
字
字节笔记本
2026年11月6日 · 约 1 分钟读完
蒸馏分数接近满分,泛化能力却可能悄悄溜走
API中转
¥120
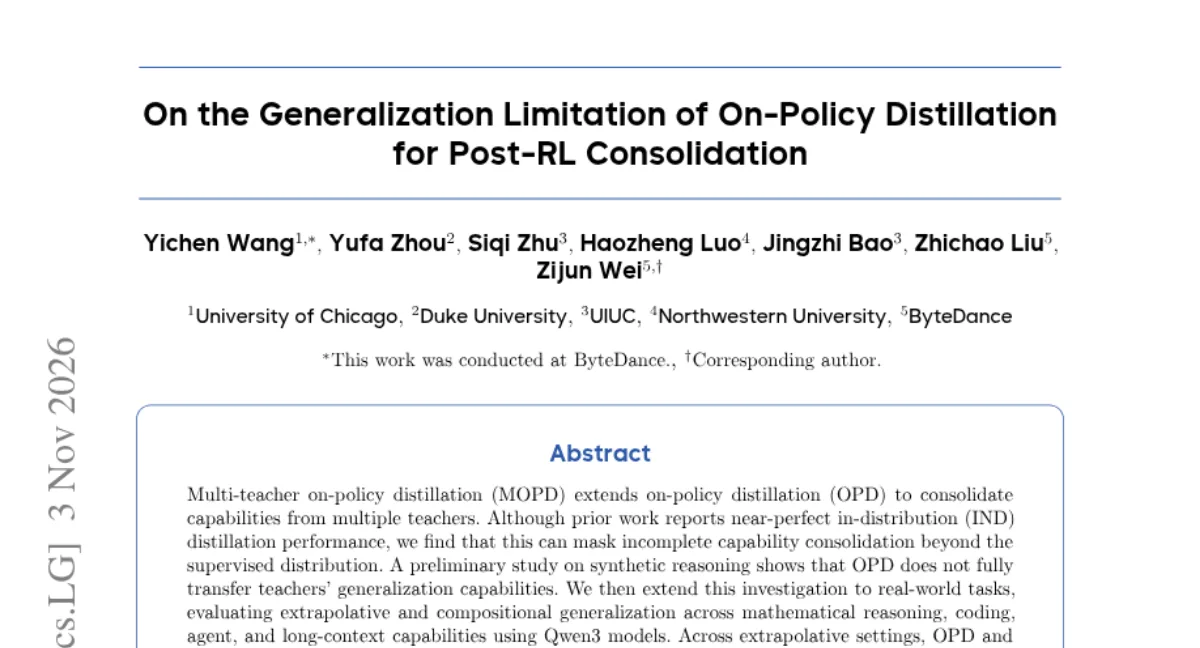
把 RL 训出的教师蒸馏给学生,分布内分数几乎满分,是不是就大功告成?字节跳动的研究(arXiv 2611.05609)发现了一个容易被指标掩盖的盲点:学生在分布内蒸馏上可以逼近甚至超过教师(达到教师水平的 96.04% 到 102.73%),但分布外能力会悄悄退化,比基座模型低 2.45 到 16.25 个百分点;组合任务上,MOPD 学生的 OOD 成绩比最佳教师低 18.19 到 24.34 个百分点。
实验横跨数学、代码、Agent、长上下文四个域,用外推式与组合式两类泛化做 OOD 评估,基于 Qwen3 系列的不同师生组合。参数更新的几何分析给出了机制解释:蒸馏更新的幅度更小、谱更集中,MOPD 的更新结构共享度更高,这也是它平均比 RL 基线 OOD 遗忘更少的原因。
两个瓶颈被精确定位:教师自身的能力上限,和训练数据的覆盖范围。好消息是同时缓解二者可以在实验中消除 OOD 遗忘,甚至暗示超越教师的可能。论文给出两个低成本修补:几何导向的更新约束,和保留基座的回放(base-preserving replay),后者在几乎不损失分布内成绩的前提下改善 OOD,评论数据里 GSM8K 的 OPD 学生 AIME25 拉到 67.50 而 GSM8K 只降 0.18 分。
对从业者的行动清单论文也直接给了:别拿分布内蒸馏分数当整合成功的判据,OOD 保留必须单独评测;蒸馏前先查教师能力上限与数据覆盖是否匹配你的目标分布;优先试 base-preserving replay,代价极小。做模型交付的团队,这份清单值得直接进验收文档。
相关文章

分享: