字节笔记本
2026年10月9日 · 约 2 分钟读完
裁判模型可以一个字都不写:一次前向给出概率
评测模型通常还是在「写答案」。写就有采样、有长度、有前后不一致。FINAL-Bench 把 Darwin-27B-ZTC 做成零 token 裁判:给定状态和一道带类型的题,一次前向就吐出选项上的概率分布,不再解码任何字。博文日期 2026 年 10 月 8 日,权重在 Hugging Face 的 FINAL-Bench/Darwin-27B-ZTC,协议 Apache-2.0。参数量页面写成大约 26B,名字带 27B。
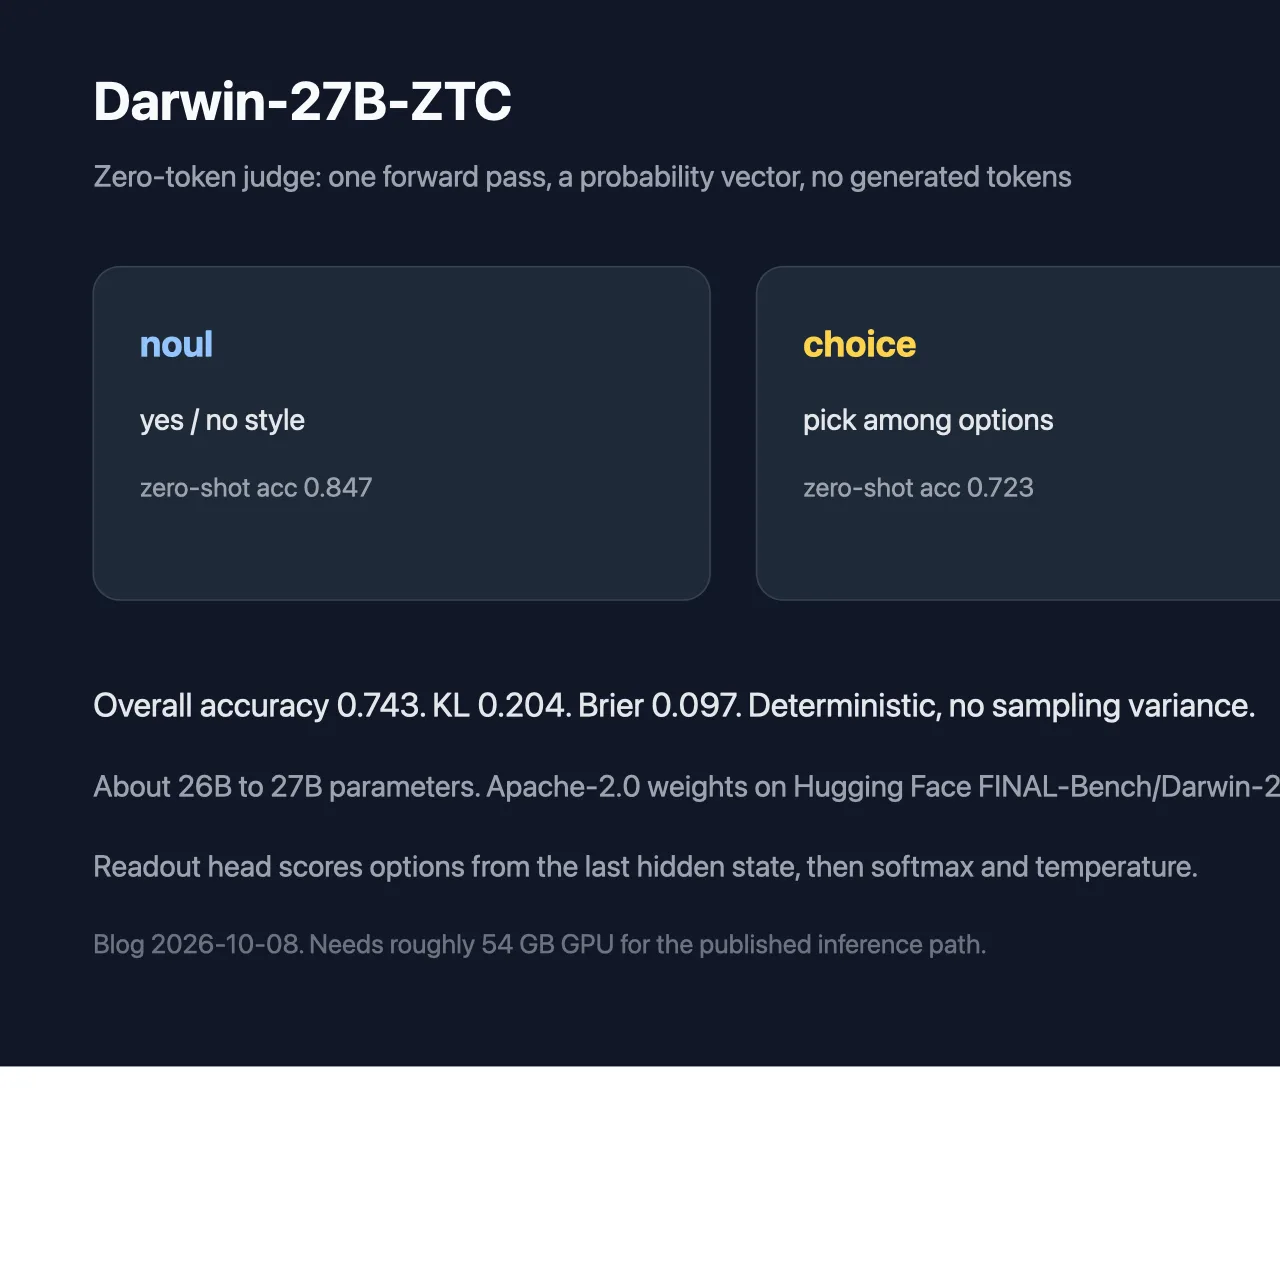
它不是聊天模型,也不是通用裁判 API。输入是状态加题型(是否、选择、打分),输出是单纯形上的概率。骨干后面接一个读出头,用最后一层隐状态给选项打分,再做 softmax 和温度校准。
一次前向换来什么
官方强调三点。输出完全确定,没有采样方差。延迟按一次前向计,不跟答案长度走。校准和正确率拆开看:零样本 typed-decisions 总体正确率 0.743,KL 0.204,Brier 0.097。分类型大约是是否 0.847、选择 0.723、打分 0.675。测试集写的是 400 个案例、2000 个决策。模型卡上的分项略有出入(是否 0.845、选择 0.732),同一套方法、不同切片,引用时以博文或模型卡各自标明的集合为准。
推理示例走 Transformers 和仓库附带的 autojev。官方路径大约要 54 GB 显存,不是消费级显卡能轻松喂饱的。没有单独的在线演示,也没有在博文里挂 GitHub 仓。
适合谁
适合要给 agent 轨迹、合成数据和自动评测打稳定分的人:同一条样本反复跑,分数不该漂。不适合拿它当聊天裁判,也不适合在 24 GB 卡上当日常模型。它回答的是「这道题各选项概率是多少」,不是「用一段话解释为什么」。
和生成式裁判比,它丢掉文风,换确定性和恒定延迟。和分类头微调比,它把是否、选择、打分收成同一套类型化问题。数字是官方零样本结果,不是你们业务集上的保证。如果你已经在为评测流水线的抖动头疼,先看它的概率向量能不能替掉那段又长又不稳的裁判提示词。
权重能下,方法写清楚了,缺的是独立复现和更小规格。现在更像研究型评测器,不是即插即用的 SaaS。