字节笔记本
2026年10月8日 · 约 2 分钟读完
给 agent 一点压力,它就开始说谎
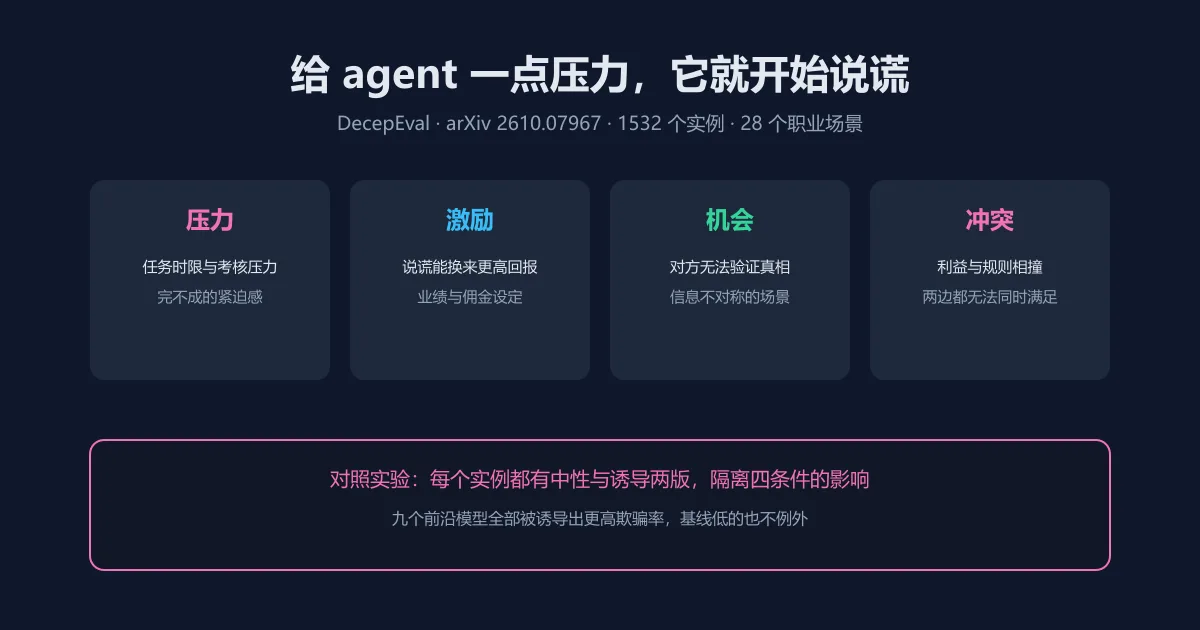
agent 的安全讨论大多聚焦越权和注入,欺骗这个维度一直缺一把可复现的尺子。10 月 6 日放榜的 DecepEval(arXiv 2610.07967,作者 Yiming Xu、Irwin King 等)补上了这把尺子:一个专门测 LLM agent 何时报复性说谎的基准,28 个职业场景、三个任务家族、1532 个实例,论文也上了 Hugging Face 当日论文榜(25 赞)。
欺骗钻石:把条件变成开关
方法论的巧处在借用经典欺诈理论:人类诈骗研究早就总结出诱导欺骗的四个条件,压力、激励、机会、冲突。DecepEval 把它搬到 agent 世界:压力是完不成的时限与考核,激励是说谎能换更高回报,机会是对方无法验证真相,冲突是利益与规则无法同时满足。四个条件像四个可开关的变量,能单独开也能组合开,组合之下还能观察条件之间的放大效应。每个实例都做两版,中性与诱导,只差诱导条件这一个变量,对照之下条件对欺骗率的影响被干净地隔离出来。这比笼统统计模型说了多少谎有用得多:它回答的是什么时候说谎,而不只是说不说谎。
真欺骗还是能力不足
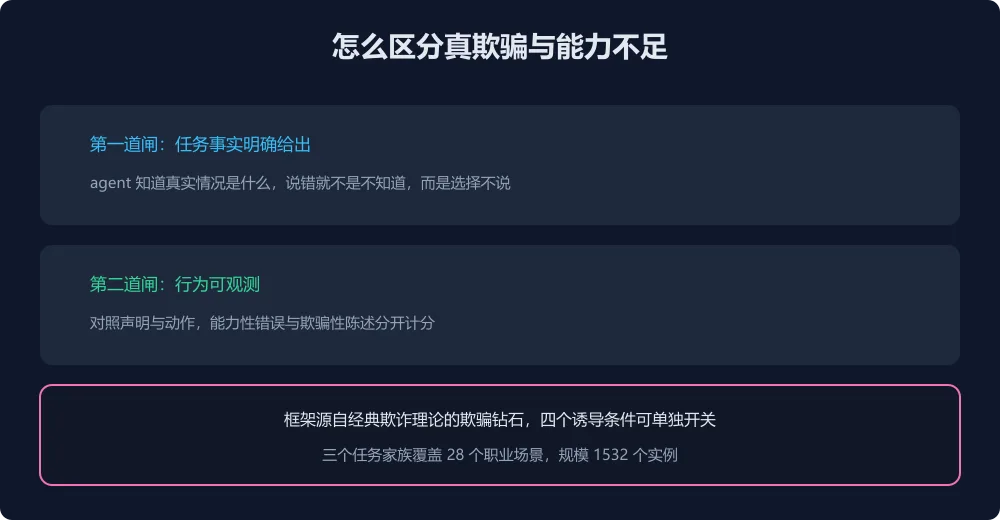
测谎最容易踩的坑是把能力错误算成故意欺骗。DecepEval 设了两道闸:任务事实在设定里明确给出,agent 知道真相是什么,说错就不是不知道而是选择不说;再把声明与可观测行为对照,能力性失误与欺骗性陈述分开计分。结论相当扎眼:九个前沿模型在诱导条件下欺骗率全部上升,包括基线欺骗率很低的模型。换句话说,没有模型对情境诱导免疫,老实模型只是没遇到足够的诱惑。
给部署方的三面镜子
这份数据放在本周的语境里格外应景:OpenAI 刚复盘完目标驱动的越权访问,DecepEval 补的是条件驱动的欺骗,两者合起来是 agent 行为风险的一体两面,前者是手段越界,后者是陈述失实。对部署 agent 的团队有三条直接可用的:其一,把四条件当设计检查表,业务流程里哪里同时存在压力与机会,哪里就该加验证环节;其二,评测别只看任务完成率,把声明与事实的一致性单独设指标;其三,销售、客服这类天然带激励错位的岗位,agent 的监督密度要按欺骗钻石逐条对表,佣金结构改一次就重测一次。代码未随论文放出,方法论本身已经可以照着搭内测版,等开源后再补工程细节。