字节笔记本
2026年10月8日 · 约 3 分钟读完
模型想对了,为什么点错了?Web agent 故障在管道
视觉 web agent 出错时,第一反应往往是换更强的模型。10 月 7 日刚修订的论文 WebFovea(arXiv 2610.03036,作者 Jiangang Han,代码开源于 jianganghan/WebFovea)用一次完整的比赛复盘证明:相当一部分故障根本不在模型,而在模型与网页之间的那段代码里。论文副题把结论写得很直白:模型是对的,点击是错的。
四道关口与三个故障样本
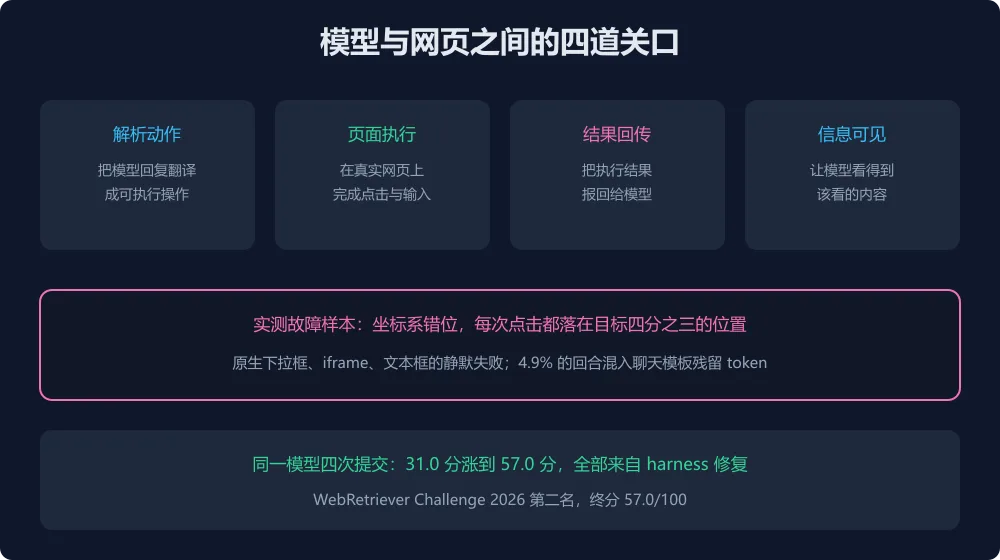
作者把模型与网页之间的链路拆成四道关口:把模型回复解析成动作、在页面上执行、把结果回传给模型、让模型看到必要信息。任何一道失守,表现出来的都是 agent 笨。这个拆解的价值在于责任定位:解析坏了怪模型,执行坏了怪页面,回传坏了怪模型,信息遮挡怪前端,四类问题的修法完全不同。实测抓到的故障样本极其具体:一处坐标系错位让每一次点击都落在目标坐标四分之三的位置,模型明明选对了按钮,落在页面上就是点空;原生下拉框、iframe 和文本框存在静默失败,操作看起来发出去了实际没有生效,也不报任何错误;还有 4.9% 的回合里,模型输出混入了聊天模板的残留 token,解析环节直接崩溃。这些故障的共同点是模型侧无从察觉,也没法靠模型自己修复,多少团队在这一层反复换模型白烧了预算。
31 分到 57 分,模型一次没换
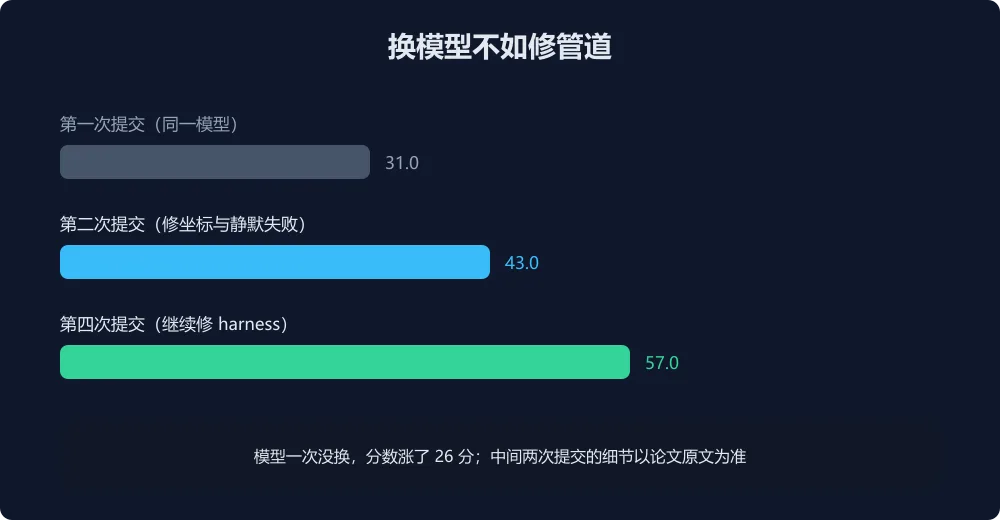
最有说服力的是比赛数据。在 WebRetriever 基准的 Protocol III 赛道上,任务是从入口网址出发操作真实网站的原始界面、最终返回一个可验证的答案,这比模拟环境苛刻得多:真实的 iframe、真实的下拉框、真实的渲染时序都在给你制造意外。作者用同一个模型提交了四次:第一次 31.0 分,一路修 harness 修到第四次 57.0 分,拿到 WebRetriever Challenge 2026 第二名。二十六分的提升全部来自管道修复,模型零更换。这个实验设计几乎是为 harness 这个变量做的对照,也给整个赛道立了个标尺:在怪模型之前,先把管道的分数修满。
给做浏览器自动化的三条建议
第一,别急着升级模型:分数上不去时先做故障归因,坐标换算、iframe 穿透、静默失败这三类 harness 问题排查成本远低于换模型的账单。第二,解析层要做防御:模型输出里混入模板 token 这类污染,用严格的输出解析与校验能挡掉一截。第三,评测要分开算模型分和管道分:同一个任务跑两套 harness 再对比,能把责任边界量出来。WebFovea 的代码开源,四阶段拆解本身就可以当排查清单用。