字节笔记本
2026年10月8日 · 约 2 分钟读完
自进化越练越差,病根出在题目上:R-Quest 对症下药
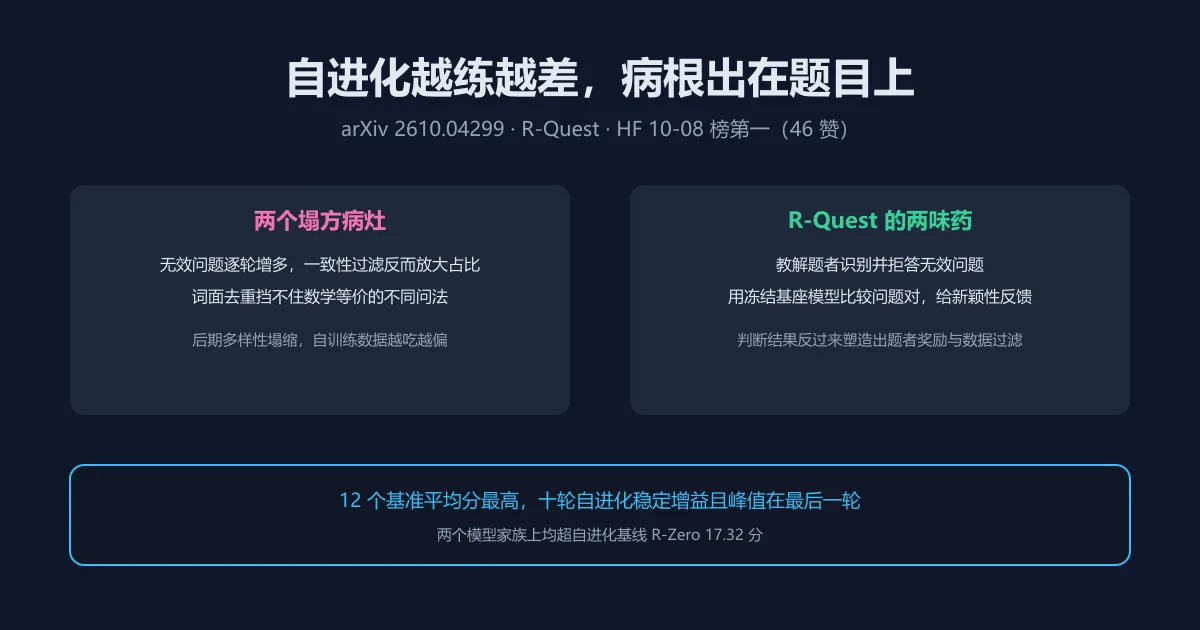
让模型自己出题自己练,是自进化路线最诱人也最危险的设定:不需要人工数据,理论上可以无限迭代。实际跑起来的曲线却常常事与愿违,几轮自训练后性能不升反降。Hugging Face 10 月 8 日论文榜第一(46 赞)的 R-Quest(arXiv 2610.04299,作者 Jinyuan Li 等)把这条下坡路拆开看,病根不在解题,在出题。
两个塌方病灶
第一个病灶是无效问题越滚越多。自生成的问题里有相当比例本身站不住脚,比如条件自相矛盾或根本无解;更糟的是常用的答案一致性过滤会系统性地放大无效问题的占比,因为无效问题的答案往往高度一致,反而更容易通过过滤,等于用筛子专门捞出坏数据。第二个病灶是多样性塌缩。常见的词面相似度去重挡不住数学上等价但表述不同的问题,同一道题换了三种问法就被当成三道新题,训练数据在后期迅速同质化,模型越练越窄。两个病灶叠加,自进化就变成自我退化。
两味药
R-Quest 的修法直接对着病灶去。对无效问题:训练解题者识别并拒答站不住脚的题,再用这些判断去塑造出题者的奖励并过滤训练数据,坏题在源头就被拦下。对多样性塌缩:用冻结的基座模型对采样出的问题两两比较,给出新颖性反馈,等价重复的问题拿不到新意分,不管它换了什么说法。冻结基座做裁判的好处是判断标准不随自进化漂移。
成绩单
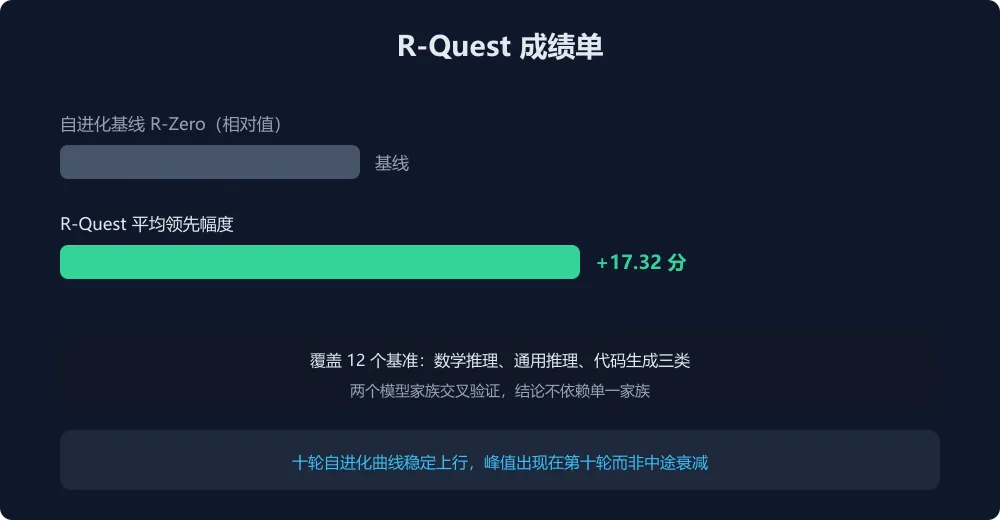
效果在两个模型家族上交叉验证:数学推理、通用推理、代码生成三类共 12 个基准,平均分拿到最高;对比自进化基线 R-Zero 领先 17.32 分;更关键的是十轮自进化的曲线稳定上行,峰值出现在第十轮而不是中途衰减,这正是可持续自进化最想要的形状。基线方法普遍在三四轮后开始掉头向下,曲线形状的对比比单点分数更能说明问题。论文未附代码仓库,复现要等作者放料,方法论描述本身已经足够细。
对做自进化管线的团队,这份工作的操作启示有三条:出题质量控制要前置,别等过滤阶段再拦,一致性过滤反而会捞坏题这点尤其反直觉;新颖性判断别用词面相似度,找个冻结的裁判看语义等价;自训练数据里无效样本的占比要当核心监控指标盯住,它是塌方的前兆,等性能掉下来再查已经晚了一轮。