
字
字节笔记本
2026年11月5日 · 约 1 分钟读完
世界模型卡在一分钟,Alaya 用 1,655 小时游戏视频补课
API中转
¥120
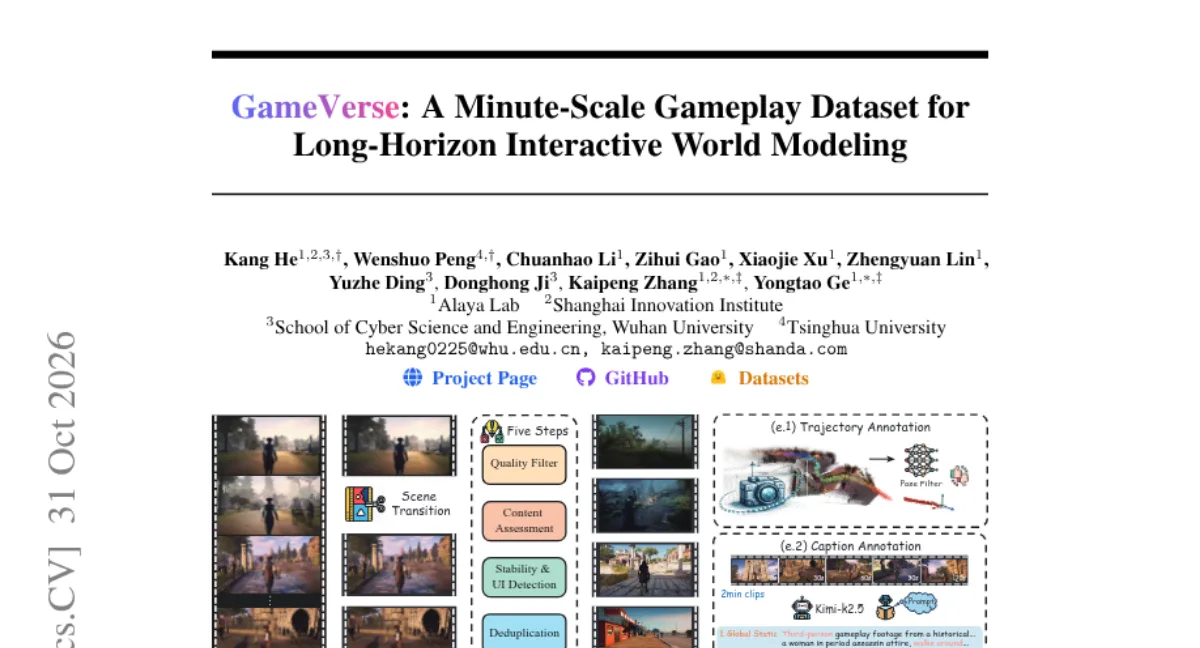
交互式世界模型有个公开的尴尬:生成约一分钟之后,画面就开始糊成一团。Alaya Lab 团队在新论文 GameVerse(arXiv 2610.37257)里把病根归给了数据:不是模型不行,而是长期时序训练数据太匮乏。为此他们造了一个当前规模最大的游戏视频数据集。
数字先摆出来:约 69,700 个视频片段,总计 1,655 小时、3.496 亿帧,覆盖第一人称与第三人称游戏画面。最有含金量的是其中 1,358 小时的连续两分钟序列,按论文说法比既有数据集的片段长度长出一个数量级,现有游戏数据集的片段普遍不足十秒。
光长不够,还得配得上训练。团队为整套数据跑了统一流水线:场景一致性分割、质量过滤、相机位姿估计、基于事件的字幕标注。每个片段配上跨分钟保持稳定的相机轨迹,字幕则区分静态场景与动态前景事件,并按事件边界而不是固定时间窗对齐,这让「正在发生什么」的监督信号落在真实的剧情节点上。
效果经得起验证:综合分析显示 GameVerse 在规模、多样性和标注质量上超越现有公开数据集,在其上训练能显著延长世界模型的有效时域。数据集已在 Hugging Face 开放(Kangverse/GameVerse),论文当日冲到 Daily Papers 第三、33 个赞。
值得一提的是,Alaya Lab 同期还发了 StreamDuo,给没见过的游戏配了一个实时解说员加一个研究 agent,两条工作拼起来是同一盘棋:游戏画面是最好的世界模拟教材,先解决教材长度,再解决理解深度。做世界模型或游戏 AI 的团队,这套数据可以直接开吃了。
相关文章

分享: