字节笔记本
2026年10月9日 · 约 3 分钟读完
规则藏起来,agent 还能越玩越会吗
多数 agent 基准考的是「规则你已经知道」。Learn2Play Bench 反过来:二十套文字游戏把规则藏起来,同一随机种子换一集,布局会变、规则不动。agent 只能靠上一集的记忆把后面的分打上去,权重不许动。论文 arXiv 2610.08215,HF 今日论文榜大约 91 票。代码快照在 liushiliushi/Learn2Play-Bench,目前约 12 星、0 个 fork,API 里没有许可证字段。项目页和在线试玩分别在作者站点与 learn2play.fun。
它要测的是从反馈里发现规则、靠练习涨分、场景变了还能复用同一套规则。这和「把说明书喂进上下文再开打」不是一回事。
怎么玩,怎么打分
仓库 README 写的最短路径是 Python 3.10 标准库:
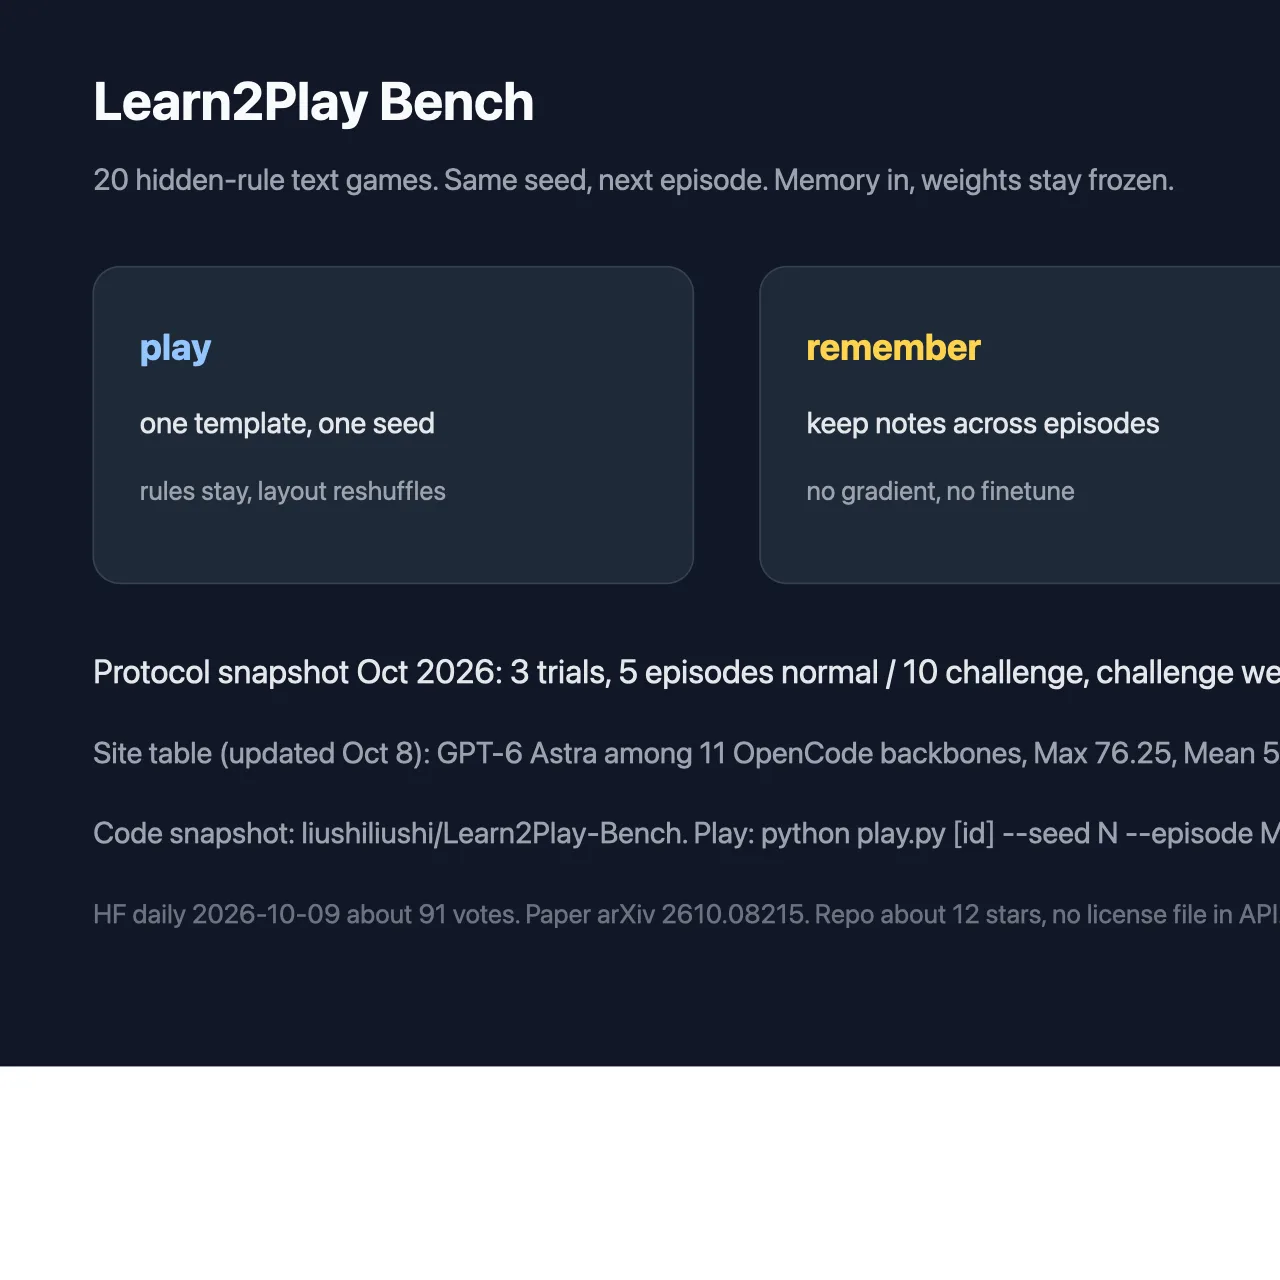
python play.py [id] --seed N --episode M --lang en换一集时种子保持不变,只改 --episode。默认种子在 default_seeds.json。项目页把协议写成:每个模板选一个种子,3 次试验,普通档 5 集、挑战档 10 集,挑战权重 3、普通权重 1。指标叫 Max、Mean、LG、LS。快照标注 2026 年 10 月,榜表更新到 10 月 8 日。
官方表上的一条对照:在 11 个 OpenCode 骨干里,GPT-6 Astra 排第二,Max 76.25,Mean 56.07,LG +23.79,LS +5.88。页面还写了 600 次核过的终端回放,以及 Astra 大约 150 美元、每集约 0.25 美元。这些是站点自己的表,不是第三方复现。人类对照只给每套游戏的 Top-1/3/5 和全体均值,不跟 AI 混排。
适合谁
适合做 agent 记忆和在线学习、却不想一上来就微调整个模型的人。二十个模板、纯文本、能自动打分,复现成本低。不适合当通用智能榜:它测的是「陌生规则能不能越玩越会」,不是写代码或逛网页。仓库还是匿名审稿快照,星少、许可证不明,接进产品前要自己核对授权。
和常见游戏基准比,它把规则藏起来,逼你从反馈里学。和长上下文考试比,它允许跨局记笔记,却不许改权重。论文和站点已经能把题跑通;缺的是更稳的许可证和更大的公开回放集。想先摸手感,用同一种子连打两集,看第二集分会不会自己涨。