字节笔记本
2026年10月5日 · 约 2 分钟读完
答得自信不等于答得对:法律 AI 的两把尺
法律是最不能容忍一本正经胡说的领域,偏偏大模型最擅长一本正经。10 月初两篇 arXiv 论文,一篇教法律模型怎么给奖励,一篇量出当前模型到底多不可靠,正好构成垂域落地的两面。
LexReward:三维细目打分再训偏好
Yida Cai 等人的 LexReward(arXiv:2609.39071)先指出问题:法律回答的奖励信号要同时覆盖对错与多维质量,现有方法只给一个粗粒度总分,既不领域化也不可解释。他们的方案按三个维度细目打分:风格量词句质量,要素量法律主体、事实、法条与判决是否齐全,推理链量论证的次序、完整、正确与不冗余。每个细目配标准与质量等级,产出成对偏好数据用于 DPO 训练,三维全面提升;再训出的奖励模型 LexRM 可以在没有参考答案的情况下给强化学习供信号。页面未见代码链接。
哥伦比亚法律基准:不可靠的定量画像
Ruben Manrique 等人的基准(arXiv:2610.03639)问了被长期回避的问题:美国法之外的法域,模型可靠吗?1042 道题覆盖十个法律领域、三种题型,人机协同多轮专家校验,15 个专有与开源模型受测。
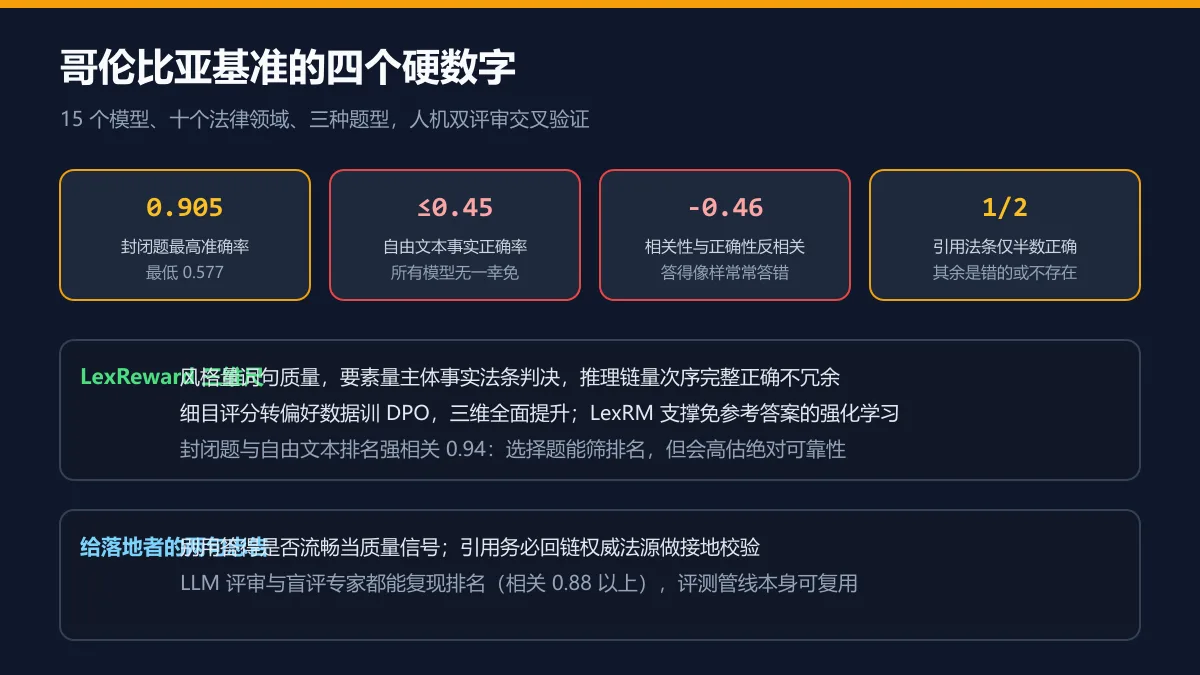
数字相当扎眼。封闭选择题准确率最高 0.905、最低 0.577,看着还行;但自由文本的事实正确率没有任何模型超过 0.45。更狠的是回答相关性与正确性呈负相关(-0.46),听起来越像在好好回答的,往往错得越自信。评审环节发现模型引用的法条只有约一半是对的,其余是错的或干脆不存在。好消息是封闭题与自由文本的排名强相关(0.94),选择题可以用来筛排名,但会高估绝对可靠性。作者开放了基准构建管线。同样未见代码链接。
放在一起读
训练侧的细粒度奖励与评测侧的可靠性画像合起来,就是法律 AI 落地前该做的两件功课:用三维尺把质量定义清楚,用接地校验把引用管起来。这个套路对所有强合规垂域都成立。