字节笔记本
2026年10月5日 · 约 2 分钟读完
一个索引吃遍所有档位:MRVQ 省下二十倍内存
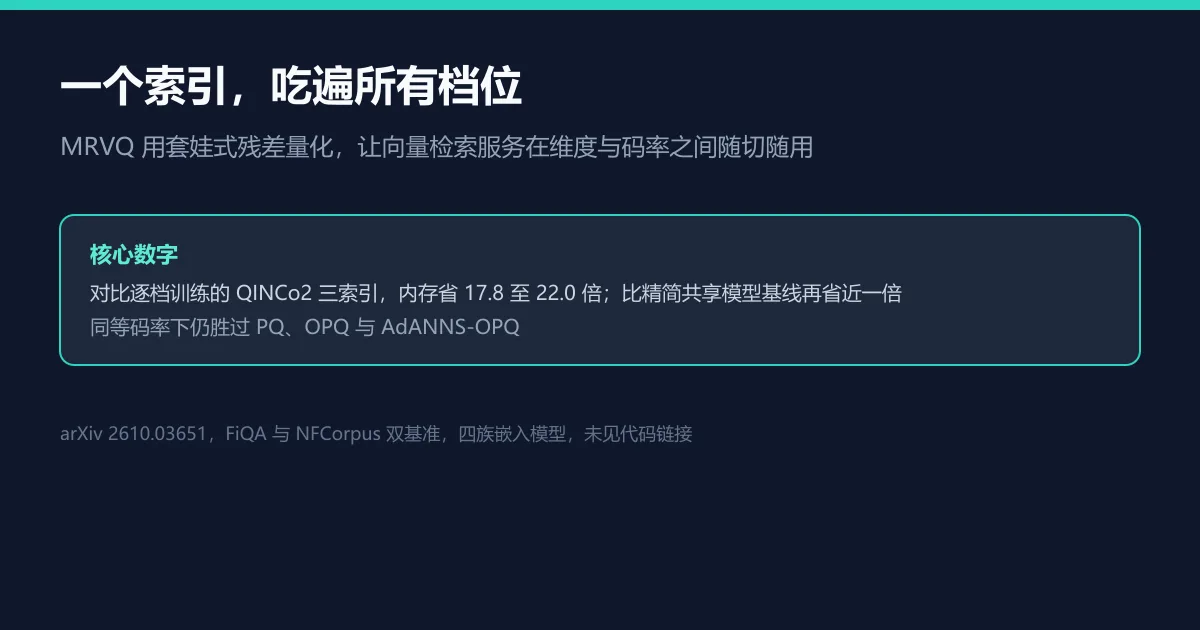
向量检索服务有个日常烦恼:延迟、质量、内存的约束一变,就得换嵌入维度或索引码率,传统做法是每个档位各训一套量化器,存储与运维成本随档位翻倍。Sean Culatana 等人的 MRVQ(arXiv:2610.03651)给出的答案很优雅:一套索引,随切随用。
方法:套娃式残差量化
MRVQ 全称 Matryoshka Residual Vector Quantization,在冻结的嵌入上做后置残差量化。它的最高码率码流可以两种方式截断:丢掉后面的残差级,码率下降;丢掉嵌入坐标,维度收缩。于是一份驻留产物就能服务所有评测过的维度码率组合,这正是套娃表示的思想搬到残差量化上。
数字怎么说
FiQA 与 NFCorpus 双基准、四族嵌入模型、4 到 16 字节码率的网格里,MRVQ 是所有测过的设计里内存最低的:对比三个分别训练的 QINCo2 索引省 17.8 到 22.0 倍内存,比精简的共享模型基线再省 1.89 到 2.02 倍;同等码率下质量仍胜过 PQ、OPQ 与 AdANNS-OPQ。
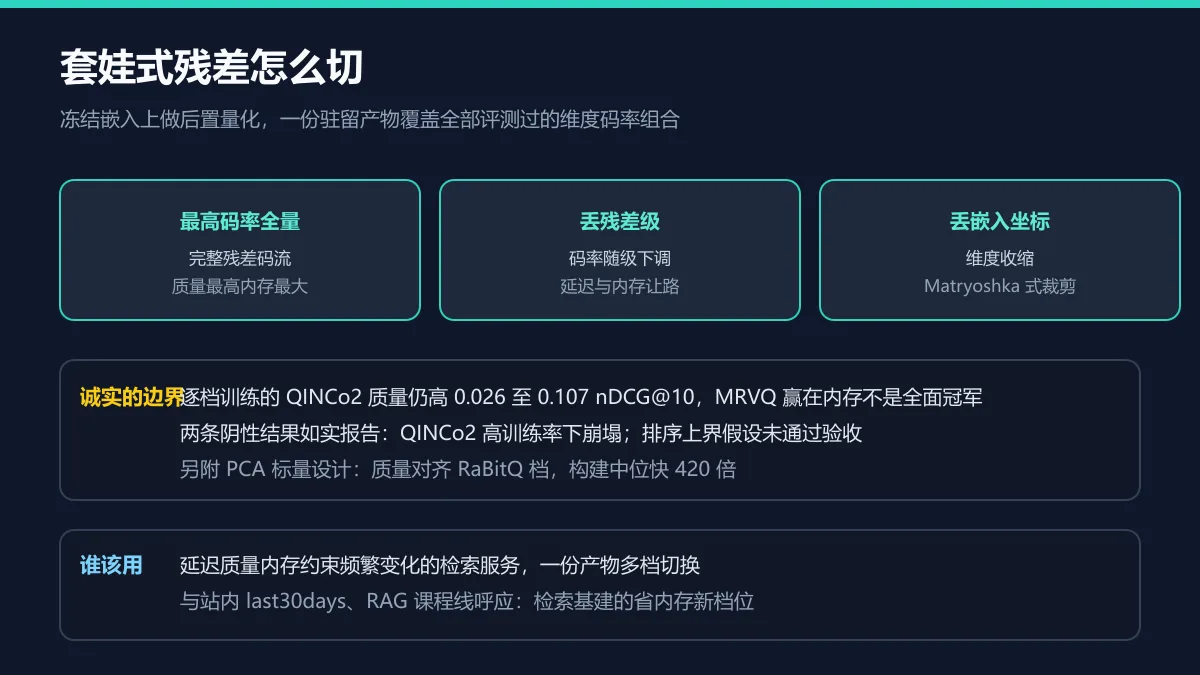
论文的诚实同样值得记。逐档训练的 QINCo2 在质量上仍高 0.026 到 0.107 nDCG@10,MRVQ 赢的是内存不是全面冠军;两条阴性结果照登:QINCo2 在高训练率下会崩塌,一个排序上界假设没有通过验收标准。作者还附赠了一个 PCA 标量设计,质量对齐 RaBitQ 档位而构建中位耗时快 420 倍。页面未见代码链接。
谁该关注
运营多档检索服务的团队是第一受众:约束变化时不再需要为每档维护独立索引,运维面收窄一个数量级。与站内写过的 last30days 技能包、七周 RAG 课程连起来看,检索基建的省内存档位又多了一个选项,做嵌入服务的同学可以直接对着论文复现实验设置。