字节笔记本
2026年11月5日 · 约 2 分钟读完
KV 缓存压到 0.5 bit,循环模型省出一半显存
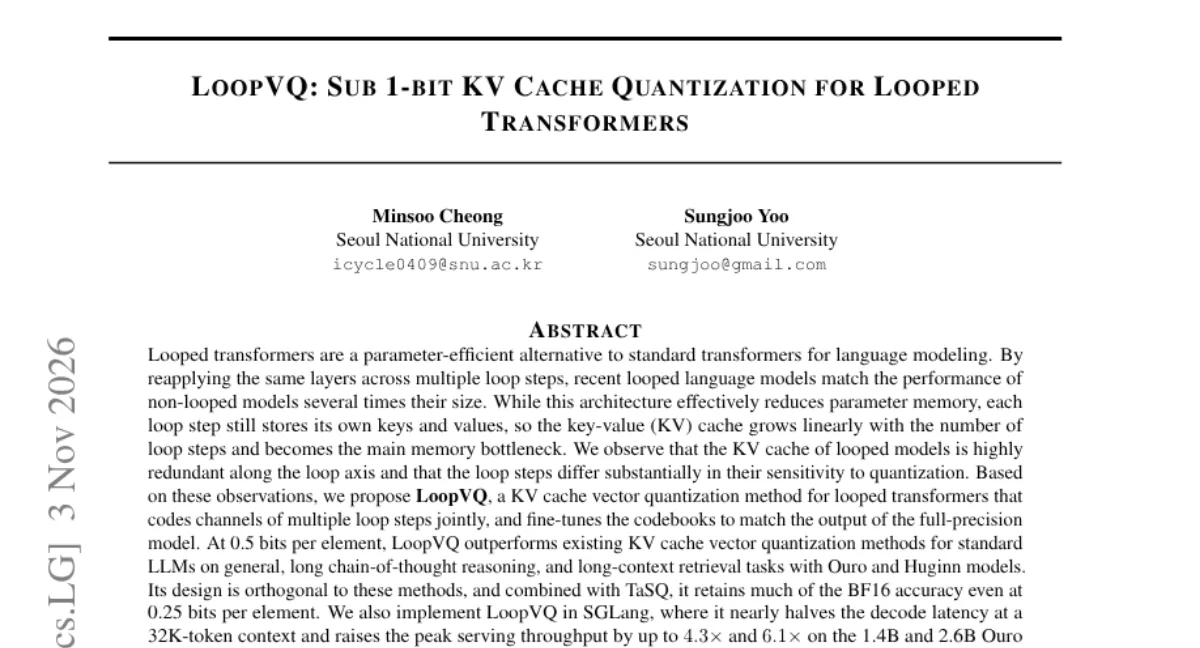
循环 transformer(looped transformer)靠反复复用同一组层来省参数,Ouro、Huginn 这类模型是代表。但省参数的账没算全:每个 loop step 都要各存一份 KV 缓存,缓存随循环次数线性膨胀。论文给了个直观对比:Ouro-1.4B 每 token 的 KV 缓存是 Llama-3.1-8B 的六倍,中等长度上下文下 KV 内存就能超过权重本身。LoopVQ(arXiv 2611.05304)就是为这笔账来的:把 KV 缓存压到 0.5 bit 甚至 0.25 bit,精度还基本守得住。
它的底气来自一个被前人忽略的冗余:同一个位置在不同 loop step 上的 key 通道高度相关,相邻 loop step 之间的相关性从 0.69 一路升到 0.94,平均绝对相关 0.85;而同一子向量里其他通道的相关性只有 0.16。既然 loop 轴这么「啰嗦」,那就沿 loop 轴做向量量化:把连续若干个 loop step 的通道合并成一个子向量,共享同一个码本索引,一个索引伺候多个 loop step,位宽不变、冗余归零。
光量化还不够,论文的第二板斧是 loop 感知的码本微调:各 loop step 的量化敏感度能差 5 倍(第一个最敏感),传统 Fisher 加权 k-means 表达不了这种差异,于是直接以最小化与全精度模型输出的 KL 散度为目标端到端微调码本,权重全部冻结,KL 误差约减半,梯度还能精确反传、不用 straight-through 估计凑合。工程上已集成进 SGLang,sink 和 recent token 保留 bf16。
效果按任务分层看:通用基准(GSM8K、MATH500、HumanEval、MBPP)上 0.5 bit 平均 73.58 对 BF16 的 75.67,接近无损;0.25 bit 还有 62.28,基线只有 28 上下。最脆的长链推理场景,基线在 0.25 bit 直接崩到 14 到 15,LoopVQ 在 Ouro-2.6B-Thinking 上守住 56.02。系统层面更诱人:RTX 6000 Ada 上 32K 上下文解码延迟约减半,峰值吞吐比 BF16 高出 4.3 倍和 6.1 倍(1.4B 与 2.6B 两档),校准加微调只要几分钟到十几分钟。
对追循环架构和「用深度换参数」路线的团队,这篇等于给推理服务端补上了缺席已久的内存账本;配合与通道轴量化正交可叠加的设计,0.5 bit 档已经可以当默认档用。