
字
字节笔记本
2026年11月6日 · 约 1 分钟读完
45% 的多语言安全失败,只有本地化测试才抓得到
API中转
¥120
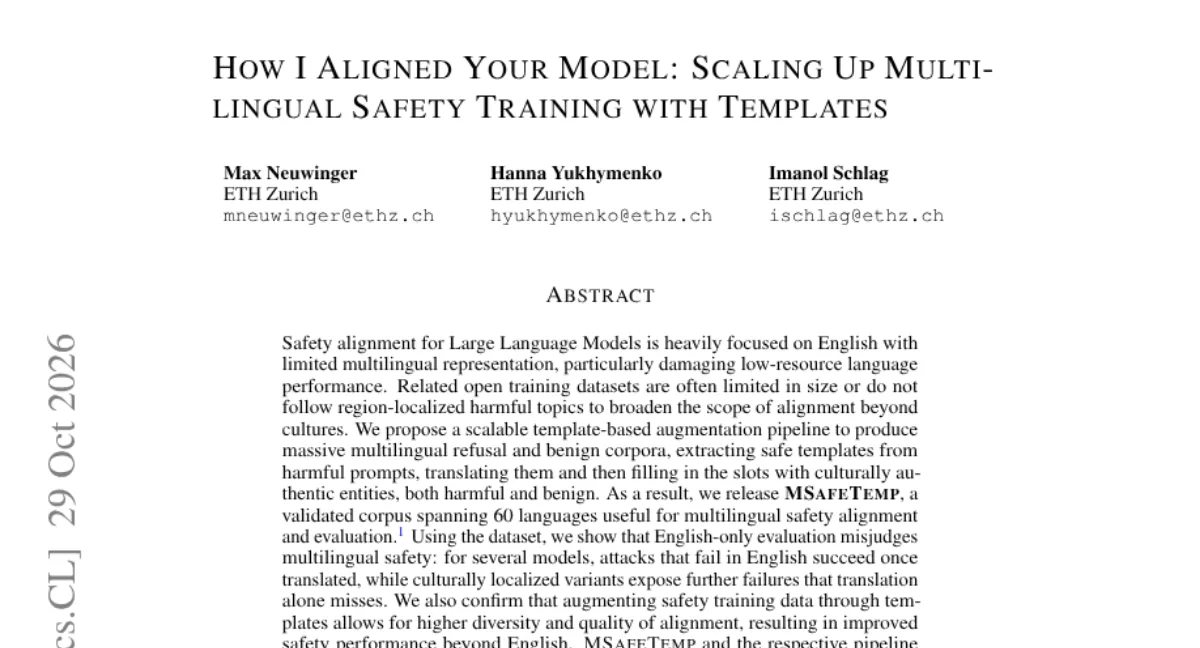
大模型的安全对齐有一个对非英语用户不公平的事实:红队测试在非英语语言上远比英语有效,同一句有害请求翻译成本地语言后,模型可能照答不误。苏黎世联邦理工瑞士 AI 项目的 MSafeTemp(arXiv 2610.40516)把修补这件事做成了可复制的管线:模板化生成 44 种语言、约 180 万条经过验证的安全训练数据。
管线的巧思在「抽词成模板」:把有害提示里的致害词语抽出来换成带类型标签的占位符,得到抽象模板,避开生成模型自己的拒绝,再翻译模板、按语言回填占位符。三条增强分支各管一件事:TR 管翻译加通用填充的有害变体,OR 管良性最小对控制过度拒绝,PH 用各语言的「文化卡」本地实体做文化本地化变体。生成与评判模型刻意来自不同家族,文化卡再由另一个模型校验。
几个数字按论文口径值得记:英文提示翻译后,Olmo 在 HarmBench 上的攻击成功率从 0% 升到 13.7%,翻译变体让四个模型的攻击成功率提高 2.4 到 4.4 倍;约 45% 的特定分支失败只在文化本地化变体下出现,翻译变体根本测不出来。人工验证走的是 IRB 批准流程,15 名评审、11 种语言、600 次打分,自然度 4.43 分、文化契合 4.46 分。
训练效果同样有数据:SFT 大幅降低多语言攻击成功率(MMLU 略损、GSM8K 损更多),再用 on-policy DPO 压过度拒绝;在训练集未包含的语言上也有接近的提升,说明跨语言迁移成立。数据与代码以宽松许可开源。做多语言产品的团队,这条管线可以直接抄来补自家模型的语言安全洼地。
相关文章

分享: