字节笔记本
2026年11月5日 · 约 2 分钟读完
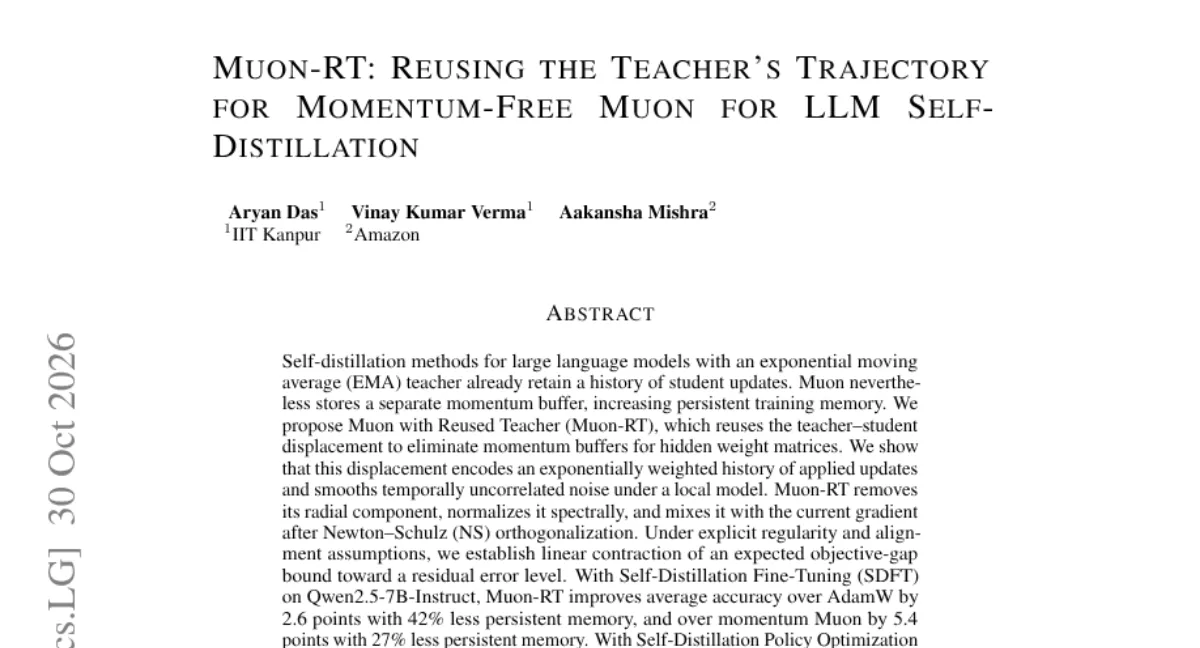
教师的轨迹就是动量,Muon-RT 省下 42% 训练显存
Muon 优化器这两年在 LLM 训练里势头很猛,但它有个容易被忽略的账单:每个隐层权重矩阵都要存一份独立的动量缓冲区,持久显存开销随模型线性涨。IIT Kanpur 与 Amazon 的研究者提出了 Muon-RT(arXiv 2610.41104),回答了一个漂亮的问题:EMA 自蒸馏里,教师模型现成的参数轨迹,能不能直接替代动量缓冲?
理论起点是一个观察:教师与学生权重的位移本身,就编码了已应用更新的指数加权历史,并且在时间不相关噪声模型下能平滑噪声、把方差压到原来的若干分之一。于是更新流程改成四步:直接对当前梯度做 Newton-Schulz 正交化;对教师学生位移去掉与学生权重的径向分量;用幂迭代估计的最大奇异值做谱归一化(每个矩阵只留一个长度为批大小的向量热启动);最后按 0.1 的系数把两支混合。理论部分给出线性收缩到残余误差的保证,实现上做了 FSDP 分片与临时张量及时释放,额外成本约每步 2%。
数字按论文口径:SDFT 场景下 Qwen2.5-7B-Instruct 比 AdamW 平均准确率高 2.6 点、持久显存少 42%,比带动量的 Muon 高 5.4 点、显存少 27%;SDPO 场景 Olmo-3-7B 上比 AdamW 高 2.0 点,五小时预算下领先扩大到 2.4 到 3.7 点。显存对比最直观:7B 模型的持久状态 Muon-RT 37.7GB,动量版 Muon 51.6GB,AdamW 64.5GB;投影到 10 万亿参数规模就是 121TB 对 160TB 和 200TB。
局限作者自己写明白了:实验只覆盖两个 7B 家族和四个任务,收敛分析的常数没有针对真实 LLM 估计过,而且方法前提是已经有参数对齐的 EMA 教师,为省显存专门养一个教师并不划算。对正好在跑自蒸馏的团队,这是一份几乎白捡的显存优化。