字节笔记本
2026年10月7日 · 约 11 分钟读完
Next.js 服务端接入 Supabase 的关键取舍
Supabase 给你一个开箱即用的 Postgres,Next.js App Router 给你一套前后端同构的骨架,两者凑在一起,大多数教程只演示到「能跑通」:创建客户端、查一张表、返回 JSON。但真要把数据层搭得干净,中间横着四五个决策点,每一个都直接影响安全性和可维护性。本文按一次真实接入的演进顺序,把这些取舍逐条摊开。
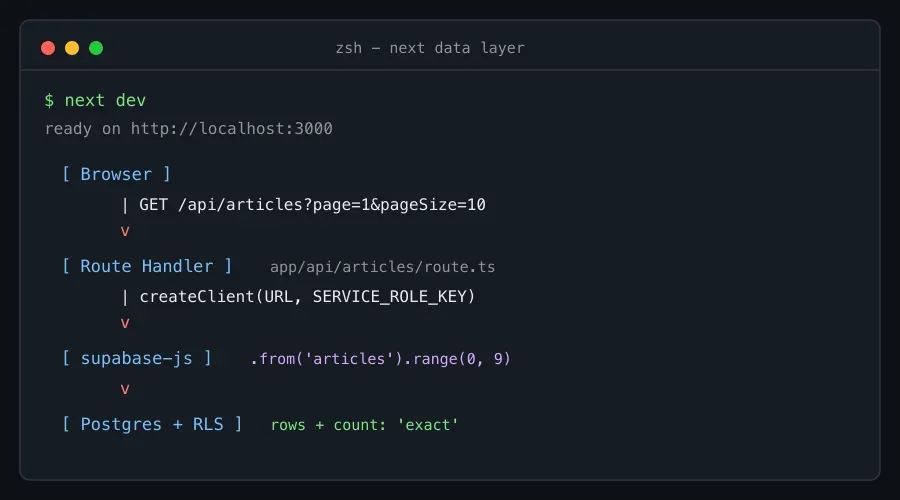
先交代一下背景。Supabase 的本质是托管 Postgres,再配上一层自动生成的 REST API(基于 PostgREST)、认证和实时订阅。既然它自带 API,为什么还要在 Next.js 里写一层 Route Handler?常见理由有四个:把聚合多表、拼接视图的逻辑收进自己代码里,而不是散落在 SQL 视图;统一鉴权和限流的入口;向外部隐藏真实表结构,保留演进余地;以及对接 Webhook、定时任务这些不属于「查表」的杂事。想清楚这一层,后面每个决策才有判断的坐标系。
先把客户端和密钥分清楚
接入的第一步没什么悬念:安装 @supabase/supabase-js,在 Route Handler 里创建客户端。
// app/api/user/route.ts
import { NextResponse } from 'next/server';
import { createClient } from '@supabase/supabase-js';

const supabase = createClient(
  process.env.NEXT_PUBLIC_SUPABASE_URL!,
  process.env.SUPABASE_SERVICE_ROLE_KEY!
);
真正值得停下来想的是那把密钥。每个 Supabase 项目至少有两把钥匙:anon key 面向浏览器,受行级安全(RLS)约束,谁调用就只能读到策略放行的行;service_role key 则完全绕过 RLS,权限上相当于数据库的超管。
服务端路由用 service_role 本身没错,代码只跑在服务端,变量不会打进客户端 bundle。但有两个前提必须守住:变量名绝不能加 NEXT_PUBLIC_ 前缀,加了就会随前端代码一起暴露;既然绕过了 RLS,鉴权责任就转移到路由自己头上,一个谁都能 curl 的公开接口配上 service key,等于把整张表裸奔在公网。更稳的思路是反过来:能用 RLS 管住的读操作直接用 anon key,把访问控制交还给数据库,路由只负责透传用户身份。
顺着这个思路再进一步:当接口需要「当前登录用户」的语义时,别拿 service key 查完再自己过滤,正确工具是 @supabase/ssr 提供的服务端客户端——从请求的 cookie 里恢复用户会话,supabase-js 会带着用户凭据查询,RLS 自然按人生效。service key 应该留给少数真正需要越权的场景,比如后台统计、跨租户的定时清理。
分页:range 是闭区间
文章列表分页是这类接入里第二个高频需求。supabase-js 的 .range(from, to) 是闭区间,两端都包含,偏移量算法随之确定:
const from = (page - 1) * pageSize;
const to = from + pageSize - 1;

const { data, count, error } = await supabase
  .from('articles')
  .select('id, title, author, created_at', { count: 'exact' })
  .order('created_at', { ascending: false })
  .range(from, to);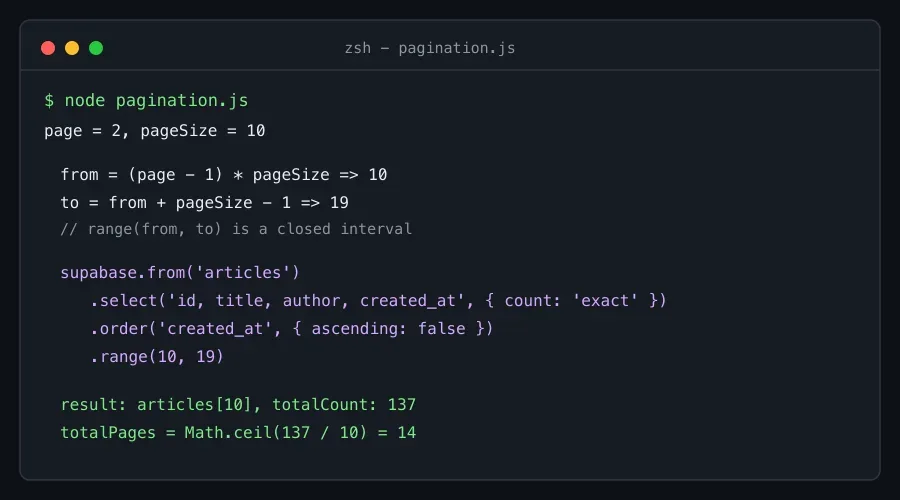
两个细节容易被忽略。其一,count: 'exact' 会让 Supabase 在同一次请求里附上满足条件的总行数,前端直接算 totalPages = Math.ceil(count / pageSize),省掉一次额外的 count 查询;其二,列表接口只 select 列表页真正要渲染的列,别图省事 select('*'),文章正文动辄几十 KB,混进列表响应是分页接口变慢的头号原因。
另外要心里有数:.range() 这类 offset 分页在深翻页时性能会退化,数据量到了几十万行的量级就该换 keyset 分页,也就是记住上一页最后一条的排序值,用 .gt() 或 .lt() 续查。对绝大多数内容站,offset 分页配一个 created_at 索引已经绰绰有余。
一个端点,还是两个端点
第三步是 API 形态。最省事的写法是单个 POST 端点,用 body 里的 action 字段做分发:
export async function POST(request: Request) {
  const { action, ...params } = await request.json();
  switch (action) {
    case 'getArticles':    return getArticles(params);
    case 'getArticleById': return getArticleById(params);
    default:
      return NextResponse.json({ error: 'Invalid action' }, { status: 400 });
  }
}
这种 RPC 风格能跑,但等于放弃了 HTTP 语义:方法清一色 POST,缓存层无从介入,日志里也看不出哪类请求出了问题。改成 GET 之后语义立刻清晰:
GET /api/articles?page=1&pageSize=10
GET /api/articles?id=xxx
单个端点靠「有没有 id」分叉是能用的过渡态,但更直觉的终态是拆开:列表留在 /api/articles,详情挪进动态路由 /api/articles/[id],两条路径独立演进,404 只属于详情接口。
错误处理也值得多说一句。上面这批代码的 catch 块都长得一样:统一返回 500,外加一句笼统的 "Failed to fetch"。方向是对的,对外不泄露内部细节,但别忘了在服务端把真实错误记录下来,否则线上排障只能靠猜。入口处的参数校验同样不能省,page 是不是正整数、id 是不是合法的 uuid,用 zod 之类的 schema 库在解析 body 的地方一次做完,比让错误脏数据流到数据库再报错体面得多。
顺带补一个 supabase-js 的坑:详情查询末尾的 .single() 在查不到行时返回的是 PGRST116 错误,而不是空 data,所以 404 分支要先检查 error 再看 data,照抄「data 为空就 404」的写法永远不会命中。
服务端组件,别绕自己的 API
路由接好后还有个更隐蔽的问题:首页是服务端组件,它该不该 fetch 自己刚写的数据接口?本地这样跑没问题:
async function getArticles() {
  const res = await fetch(
    'http://localhost:3000/api/post?page=1&pageSize=10',
    { cache: 'no-store' }
  );
  if (!res.ok) throw new Error('Failed to fetch articles');
  return res.json();
}
代价是实打实的:请求从服务器发出,绕回自己的 HTTP 端口再序列化一遍,平白多一跳;部署之后 localhost:3000 未必成立,又多一个要用环境变量维护的域名。服务端组件本就能直接触达数据库,在组件里用同一个 supabase 客户端查询,取数和渲染同进程完成,更快,也少一层故障点。
那 Route Handler 还剩什么用?浏览器端组件、第三方调用方、Webhook,以及必须藏在服务端的密钥逻辑。内部渲染路径直连数据库,对外暴露才走 API,这条线划清楚,架构就干净了。
缓存:no-store 还是 revalidate
最后一处取舍在缓存。Next.js 对服务端 fetch 提供两种朴素开关:cache: 'no-store' 每次渲染都真发请求,适合编辑预览这类强实时页面;next: { revalidate: 60 } 让结果缓存六十秒,内容站的列表页几乎都该选它。用户对「一分钟前的列表」毫无感知,但每次渲染都打一次数据库,高并发下就是事故。
还有个版本提醒:Next.js 15 起,服务端 fetch 的默认行为从「默认缓存」改成了「默认不缓存」。从旧版本升上来的代码如果不显式声明缓存策略,缓存会悄悄消失,数据库压力翻倍是常见的升级后遗症。所以写数据获取的地方,缓存策略要显式写出来,别赌框架默认值。
缓存之外还有第三条路:按需失效。编辑后台发布或修改文章时,在写操作里调一次 revalidatePath('/') 或 revalidateTag('articles'),缓存立刻作废、下次请求重新渲染。对内容站来说,这是「长缓存保性能」和「发布即生效」之间最舒服的平衡点,比全局 no-store 精准得多。
收尾
如果要把这套模式推到团队里复用,还有两个顺手可做的小工程:一是用 supabase 的类型生成命令从数据库 schema 导出 TypeScript 类型,查询结果和筛选参数从此有编译期检查;二是把创建客户端的代码收敛到一个 lib 模块,避免每个路由文件各初始化一遍,将来换配置要改十处。
回顾整条路径:初始化时想清楚密钥与 RLS 的责任边界;分页记住闭区间和 count: 'exact';API 形态从 POST 加 action 分发走向 RESTful 拆分;服务端组件直连数据库,API 只留给外部调用方;缓存策略显式声明。Supabase 本身不复杂,复杂的是散落在「能跑通」与「能上线」之间的这些判断,把它们逐一显式化,数据层才算真正搭完。