字节笔记本
2026年9月27日 · 约 3 分钟读完
显存不够就"瘦身":NVIDIA 官方模型优化库 ModelOpt 上手
本地跑大模型最扎心的两件事:显存不够装不下,量化一刀下去智商掉线。NVIDIA 官方其实给了个正经解法——Model Optimizer(简称 ModelOpt,Apache-2.0),一个把量化、剪枝、蒸馏、稀疏化打包在一起的模型优化库,这几天冲上了 GitHub Trending(4.8 千 stars)。
它是什么
ModelOpt 是 NVIDIA 官方的模型优化库:输入一个 Hugging Face、PyTorch 或 ONNX 模型,用 Python API 组合各种优化技术,导出一个优化后的量化 checkpoint。这个 checkpoint 可以无缝对接 SGLang、TensorRT-LLM、TensorRT、vLLM 等主流推理框架。
和社区量化工具的区别在于:它与 NVIDIA Megatron-Bridge、Megatron-LM 和 Hugging Face Accelerate 深度集成,训练侧的量化感知蒸馏(QAD)这类高阶技术也能一键使用。
优化技术六件套
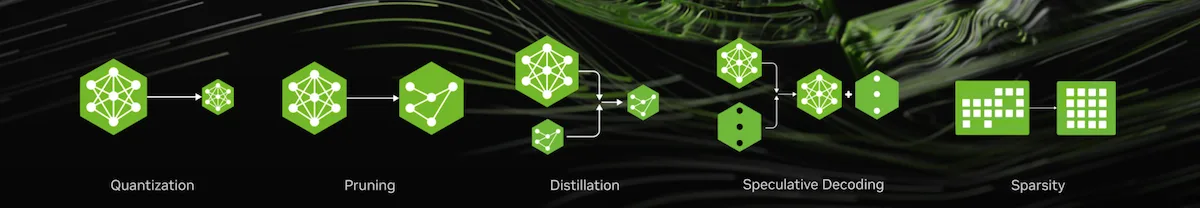
量化(INT8/FP8/NVFP4)、剪枝、神经架构搜索(NAS)、蒸馏、投机解码、稀疏化——每种技术都有独立的 API 可以组合使用。
最新的 NVFP4 W4A4 加 QAD 教程用 Qwen3.6-35B-A3B 做了演示:vLLM 吞吐比 BF16 反升 1.30 倍,checkpoint 体积缩小 3.1 倍,而量化带来的精度损失被蒸馏过程补了回来。
快速上手
pip install nvidia-modelopt对 Hugging Face 模型做后训练量化(PTQ)只要几行配置,导出的量化 checkpoint 直接喂给 vLLM 或 TensorRT-LLM。Hugging Face 导出 API 现在同时支持 transformers 和 diffusers 模型(文生图模型也能量化了)。
适合谁用
- 本地部署党:之前"Q4 量化智商掉线"的痛点,NVFP4 加 QAD 是升级路线——体积缩 3 倍、精度蒸馏补回;
- 推理服务团队:vLLM/TensorRT-LLM 部署前的标准优化步骤;
- 训练侧:Megatron-LM 和 Megatron-Bridge 用户。
一个定位提醒:优化后的模型跑在 NVIDIA 推理栈上效果最好(TensorRT-LLM/vLLM),纯 CPU 或非 NVIDIA 推理框架不适用。另外 NVFP4 这类 4-bit 浮点格式需要较新的 GPU 硬件支持。
仓库地址:github.com/NVIDIA/Model-Optimizer(Apache-2.0),文档 nvidia.github.io/Model-Optimizer。