
字
字节笔记本
2026年10月6日 · 约 2 分钟读完
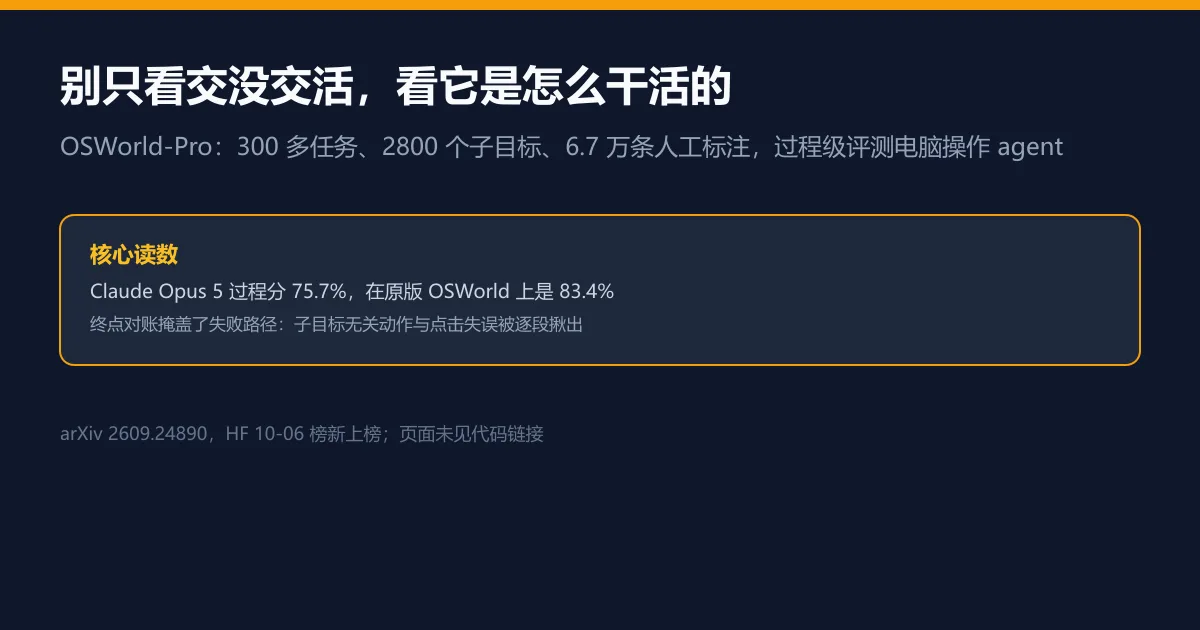
别只看交没交活,看它是怎么干活的
API中转
¥120
电脑操作 agent 的成绩单通常是这么算的:任务结束跑一遍功能校验,文件在就过、状态对就过。至于中间绕了多少远路、有多少步骤靠蒙,终点对账一概看不见。Zhilin Wang 等人的 OSWorld-Pro(arXiv:2609.24890,今日 HF 榜新上榜)换了一个口径:查路径,不查终点。
基准怎么建
规模给得很足:300 多个任务拆解出 2800 个以上顺序依赖的子目标,配 67000 多条人工标注,用人工对齐的 LLM 裁判沿子目标链逐段追踪进度。判定标准与人类判断对齐后,agent 在哪一步偏离、哪一步空转,都有了可计量的读数。
数字立刻拉开差距:前沿模型在过程评测下明显降分,Claude Opus 5 只有 75.7%,而它在原版 OSWorld 的终点评测上是 83.4%。降掉的这部分就是旧口径的盲区,蒙对结果但过程混乱的表现再也藏不住。论文还命名了两类高频失败:子目标无关动作(干着干着跑偏)与点击类失误(指哪不打哪)。页面未见代码链接。
为什么这类基准重要
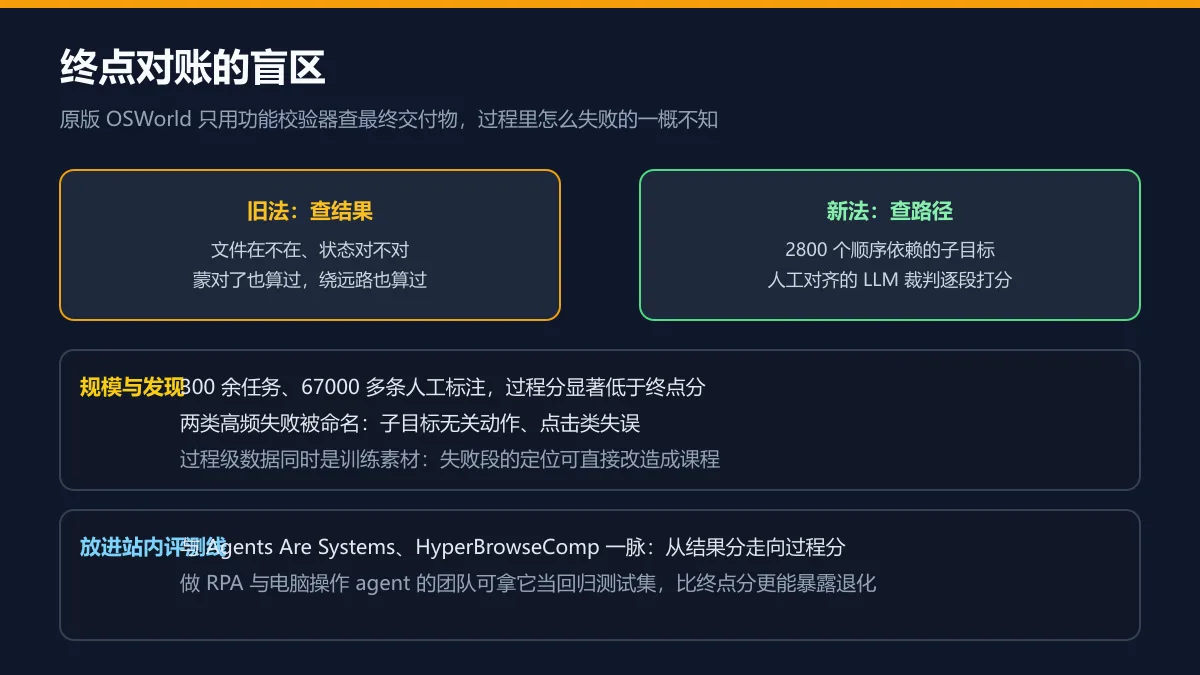
站内评测线一路写过来,趋势已经很明显:Agents Are Systems 把配置方差算进成绩,HyperBrowseComp 防参数记忆漏题,这一篇把镜头从结果摇到过程。三篇合起来是一句话:只看终点的分数正在失去信息量。
对做 RPA 与电脑操作 agent 的团队,过程分的价值不止于评测。67000 条人工标注的子目标数据本身就是课程素材:失败段的精确定位可以直接改造成训练信号,比端到端的成败标签密得多。就算不训练,拿它当回归测试集,也比终点分更能提前暴露版本退化。
相关文章
分享: