字节笔记本
2026年11月8日 · 约 4 分钟读完
数据不够,模型要大 7000 倍:Q Labs 改写 Chinchilla scaling 法则
数据不够,模型要大 7000 倍:Q Labs 改写 Chinchilla scaling 法则
Q Labs 11 月 8 日登 HN 首页的博客《Quadrillion-parameter transformers and how to train them》(27 分),配套论文 arXiv:2610.37842《Improving Data-Constrained Scaling with Hyperparameter Transfer and Ensembling》(Baron、Berman、Satheesh、Vegesna、Dahal、Andrew Gordon Wilson,arXiv 页面核实 2026-10-27 提交)。先定性:这是scaling law 研究解读,不是新模型发布——没有任何千万亿参数模型被训练出来,7,000 倍与千万亿参数都是外推处方。
论点:数据受限时,Chinchilla 的 20:1 不再最优
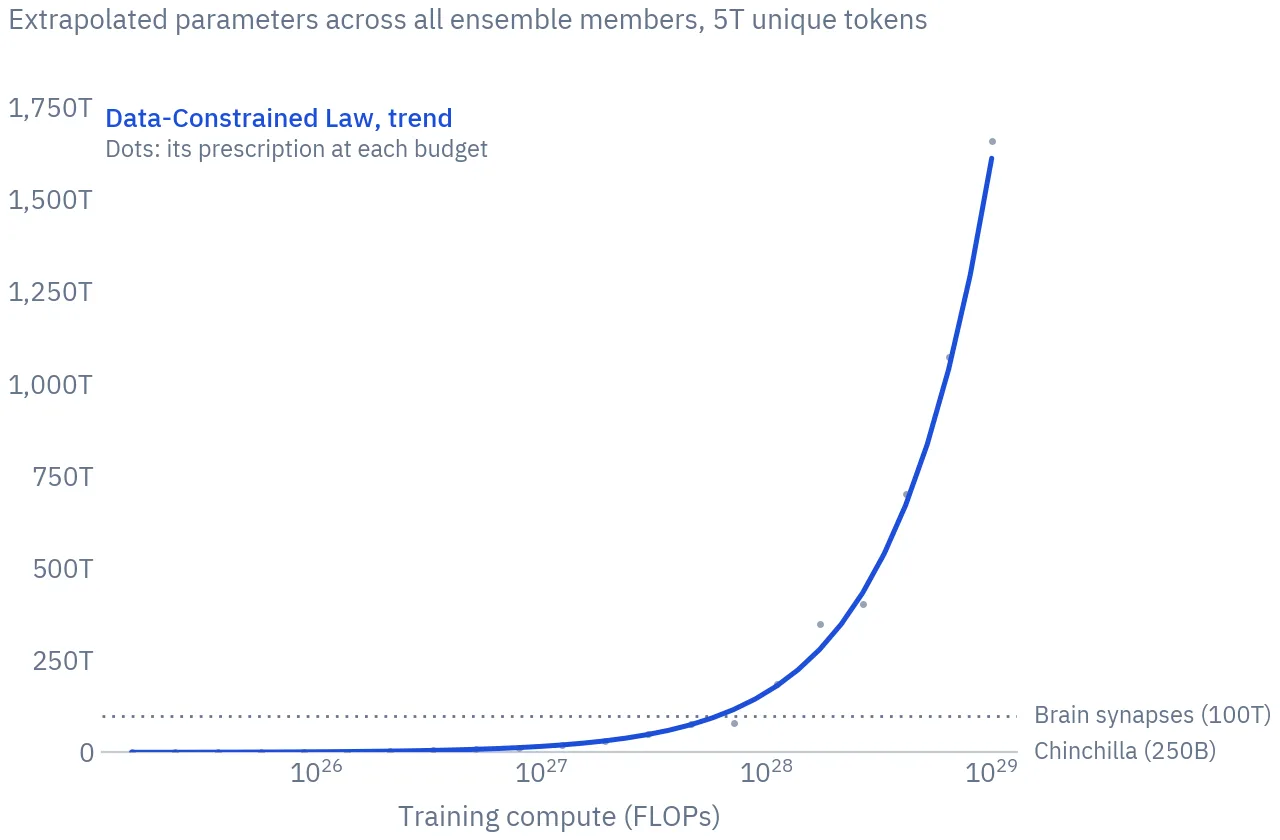
Chinchilla 的“20 tokens/参数”是数据充足时的处方。Q Labs 的论点:高质量数据增长赶不上算力增长,大模型将越来越多地在“数据受限、多 epoch”regime 下训练;此时最优模型规模随算力预算继续增长,同时 epoch 数与 ensemble 成员数也应随算力增长。数字(博客口径):外推到 5T token 数据集、10^29 FLOPs 算力下,数据受限 scaling law 给出的最优参数量约为 Chinchilla 处方的 7,000 倍,ensemble 总参数超过 300 参数/token(博客图表直读:该预算下外推参数约 1,750T,图上并排画了人脑突触 100T 与 Chinchilla 250B 两条参照线)。
人类对照与方法
博客的人类对比:人脑约 100T 参数(每个突触算一个权重)、一生约 200M token——token/参数比约 1:500,000,与 AI 的 20:1 相差 1,000 万倍;作者称“在 30T token 上,我们应该训练千万亿(quintillion)参数级网络,当前网络小了七个数量级”。方法:拟合含 5 项的 scaling law(不可约项 + 模型规模 + token 量 + 过拟合惩罚项 + ensemble 增益项),另拟合超参数幂律——最优 weight decay 随 epoch 数与模型规模陡峭增长;ensemble 两档:快照 ensemble(单次训练取多 checkpoint 平均,零额外算力)与深度 ensemble(独立训练再平均)。
验证与两处口径分歧
论文摘要原文口径:在 100M token 的 FineWeb 子集上训练,新配方比旧配方验证 loss 降低 0.15 nats 以上(困惑度降约 14%),且随算力单调改进;验证算力为拟合算力的 12 倍(论文口径,本文直读)。口径分歧如实记:博客称外推验证到 16 倍拟合算力,论文摘要写 12 倍——两个数字并存,以论文原文为准,不自行调和。背景:Q Labs 自述为研究泛化问题的实验室,“投资人包括 Jeff Dean”为其官网自述、未独立核实。
判断
三点校准:① 别写成“Chinchilla 被推翻”——两条法则管两个 regime,数据充足时 20:1 仍成立,这篇改写的是“数据固定时该怎么花算力”的那一半;② 7,000 倍是外推处方不是实验结果,真正落地的是 100M token 小规模上的 0.15 nats——外推链从 100M 到 5T 跨了五个数量级,中间每一环都可能失真;③ 与第十四批 Village 性价比篇不同层:那是“买谁的 token 划算”,这篇是“数据到底时算力该怎么花”——如果数据受限训练真成主流,weight decay 与 ensemble 会从调参细节变成主预算项。