字节笔记本
2026年10月6日 · 约 2 分钟读完
开头的几个 token,藏着推理的钥匙
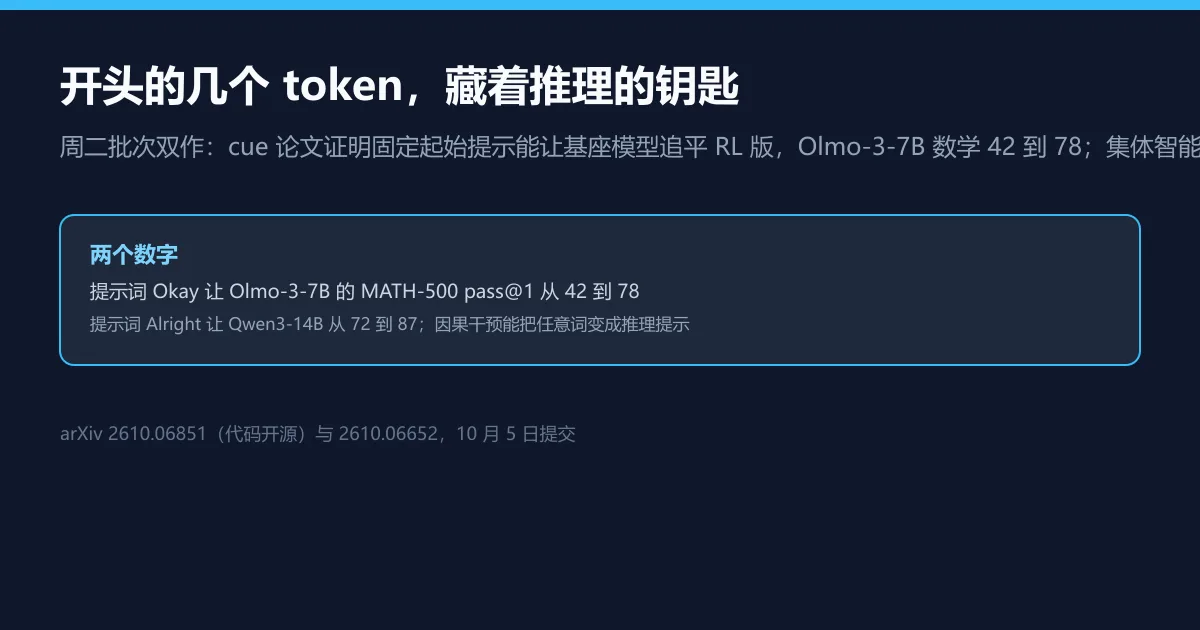
为什么同一个基座模型,换个开头就突然会推理了?Sophie L. Wang 等人的 cue 论文(arXiv:2610.06851)把这个问题拆到了 token 级,答案既简单又震撼:训练数据早就把特定起始提示与后续推理绑在了一起。
三层证据
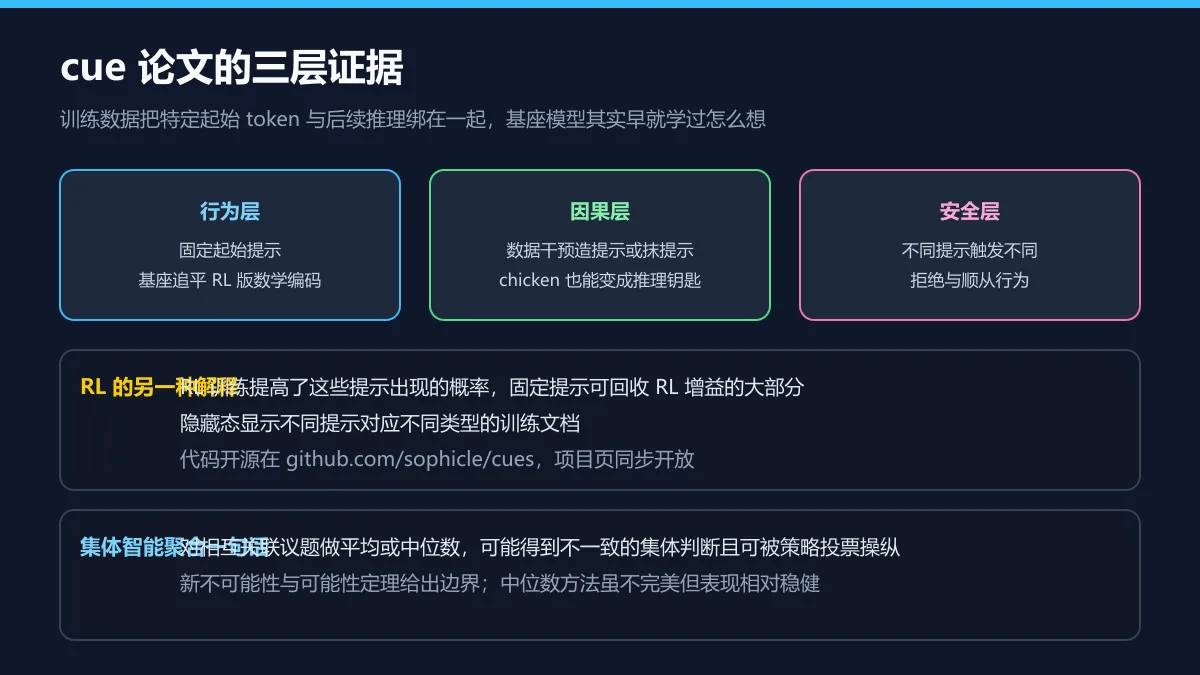
行为层的数字最直观:固定起始提示后,基座模型在数学与编码上可以直接叫板自己的 RL 版。提示句 Okay 把 Olmo-3-7B 的 MATH-500 pass@1 从 42 拉到 78,提示词 Alright 让 Qwen3-14B 从 72 升到 87。顺着这条线,RL 训练的作用被重新解释为提高了这些提示出现的概率,固定提示就能回收 RL 增益的大部分。
因果层更硬:通过数据干预,作者能把任意词(比如 chicken)改造成有效的推理提示,也能抹掉既有提示的效果;一处类似编辑让 Think duck duck goose 像 Think step by step 一样起作用。隐藏态分析显示不同提示的内部表征对应不同类型的训练文档。
安全层的案例值得所有部署方注意:不同提示会触发不同的拒绝与顺从行为,对应不同的训练数据类型,意味着提示工程同时也是行为刻度盘。代码开源在 github.com/sophicle/cues,项目页同步。
集体判断的数学边界
Franz Dietrich 与 Christian List 的集体智能聚合(arXiv:2610.06652)处理群体层面的问题:当成员对相互关联的议题各自给出判断,平均或中位数这类合理聚合可能产出不一致的集体判断,多数方法可被策略投票操纵,也并非都在追踪真相。两位作者对三个难题分别证明了新的不可能性与可能性定理,结论落在中位数方法上:虽不完美,表现相对稳健。对设计多 agent 投票与评审机制的团队,这份理论边界图是防坑手册。
放在一起读
一篇说明个体的推理能力可能一直都在,只差一句开场白;一篇说明群体的智慧取决于聚合规则的选择。个体与集体两层,推理的可控性都比想象中更依赖结构细节。