字节笔记本
2026年11月5日 · 约 2 分钟读完
推理太贵怎么办?改写它的思考历史,成本立省三成
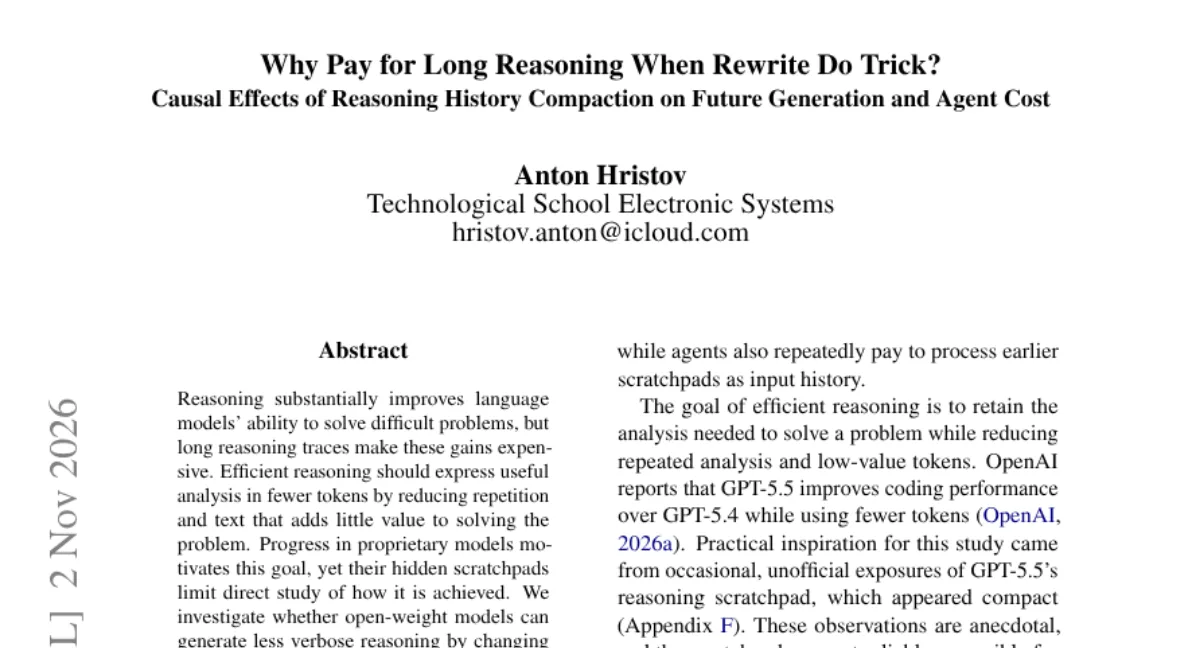
推理模型的账单大头不是答案,是思考。这篇单作者独立研究(arXiv 2611.03852)引用的数据很扎眼:推理 token 占 GLM 5.2 生成量的 84.9%、Claude Fable 5 的 75.1%,DeepSeek V4 Pro 仅推理输出就吃掉总 API 成本的 53.4%。它探究的问题因此很实际:能不能不动模型权重,只改写模型自己早前的推理历史,就让它后续思考得更省?
方法叫推理历史压缩:由另一个压缩模型(实验用 GPT 5.6 Sol 担任改写者兼评审)把历史 assistant 推理块改写成简短的状态记录,只留决策相关的事实、数字、不确定性和下一步意图,系统消息、用户消息、工具调用和观察结果原样保留。实验设计的严谨处在于「结果盲分叉」:改写在一个动作已发出、工具结果还没揭晓的时点完成,随后同一份历史分别以原版和压缩版续写,两者首个续写的唯一差异就是那段推理文本。
受控实验结果:172 个可比配对里 151 个(87.8%)后续推理变短,各路线中位数降幅 20.2% 到 50.5%,总体约 32%;精确成功率 174 对里从 165 变 166,基本持平。一个排除「只是措辞变了」的对照也很讲究:强行按 90% 到 110% 字数改写,后续长度几乎不变,成功率反而下降,说明有效的是删信息,不是换说法。部署实验在 SWE-bench Verified Mini 的 50 个任务子集上跑持续压缩,8 个配置里 6 个总花费更低、7 个目标请求时间更短,成功率差异最多 3 个任务。
泼两盆冷水也必要:一次性场景不划算,重写本身 0.339 美元远贵于续写的 0.096 美元,成本要约 82 次续写才回本,适合长会话高频复用的场景;作者也自陈缺乏删除截断类对照基线、样本非随机等局限,评审者还是「作者的两位家人」,结论当方向参考而非定论。代码已开源(DebelToni/ShortReasoning),跑长 agent 会话的团队值得拿自己的负载复测一遍。