字节笔记本
2026年11月5日 · 约 2 分钟读完
AI 解说员闯进没玩过的游戏,忘了名字就开口问
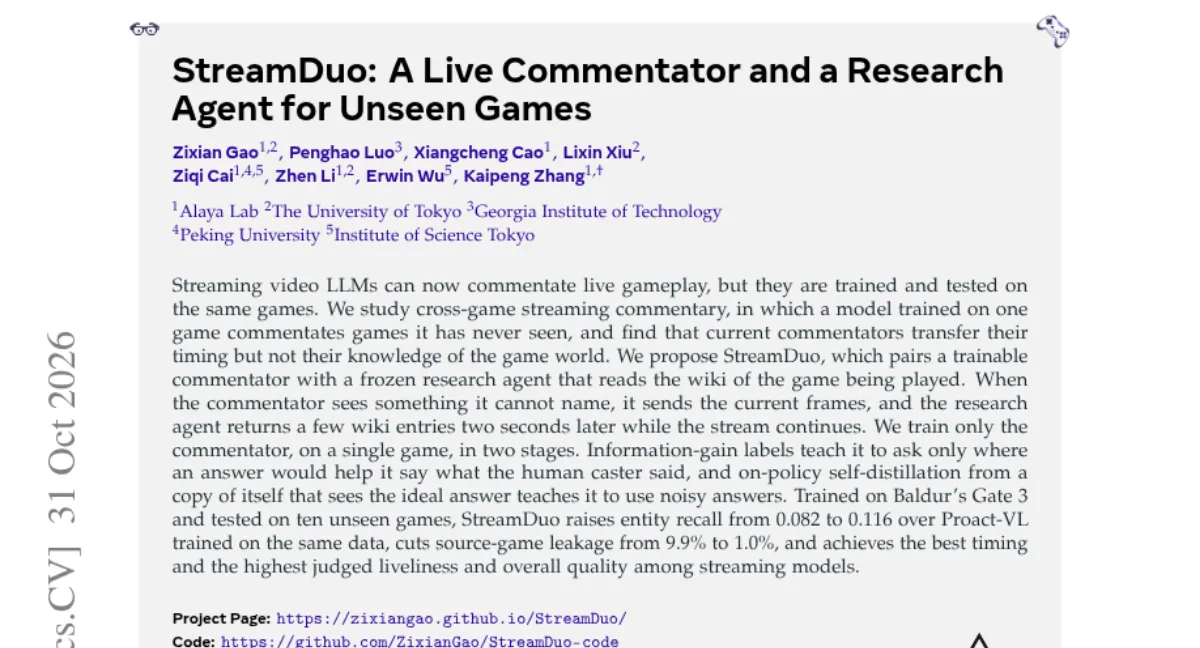
让 AI 解说员看一场没玩过的游戏直播,会发生什么?此前模型的答案是「张冠李戴」:解说的节奏都对,但会把新游戏的角色叫成训练游戏里的名字。新论文 StreamDuo(arXiv 2611.01120)给这个病开了个朴素的药方:忘了就问。
系统是双 agent 结构。解说员基于 LiveCC-7B,逐秒盯着视频流,两个小脑袋各司其职:说话头判断什么时候开口,提问头判断什么时候该查资料;整条系统里只有它被训练。研究 agent 则是一个冻结的 Qwen3-VL-8B,配 BM25 搜索工具,可查 19 万页的游戏 wiki。最妙的设计是提问方式:解说员不发文字问题,直接把当前帧丢过去,研究 agent 看图想搜索词、查 wiki、核对候选,最多返回三条词条,答案延迟两秒到达,解说流不断。
训练只在《博德之门3》的 10,286 段片段上进行,分两步:第一步用信息增益标签训练提问头,只有当答案能让模型复现人类解说时才标记提问时机,训练时还随机给实体改名,堵死背名字的捷径;第二步做 on-policy 自蒸馏,老师是同一模型的冻结副本,能看见带正确词条的理想答案,用放大加反向 KL 教学生学会消化带噪答案。
在 10 个未见游戏、2,470 段片段上考试:实体召回从基线 Proact-VL 的 0.082 提到 0.116;最刺眼的是源游戏名称泄漏,从 9.9% 压到 1.0%(基线 2,011 个名字里泄漏 200 个,它 3,363 个里只错 34 个)。整场测试只提问 264 次,约每六分钟一次,答案到达后正确命名实体的比例从百分之一二跳到 32%。效率上,研究 agent 平均 0.41 秒出答案,解说员每秒视频只花 0.26 秒计算,双 GPU 就能实时跑。
两处消融值得记下:自蒸馏阶段贡献最大,而只塞一份游戏档案几乎无效;把研究 agent 从 2B 换到 30B,召回几乎不动,说明瓶颈在分工机制不在模型大小。「知道自己不知道,然后开口问」,这条能力放到任何 agent 场景里都成立。