字节笔记本
2026年10月8日 · 约 2 分钟读完
让 agent 做游戏,做出来的是你想要的吗?
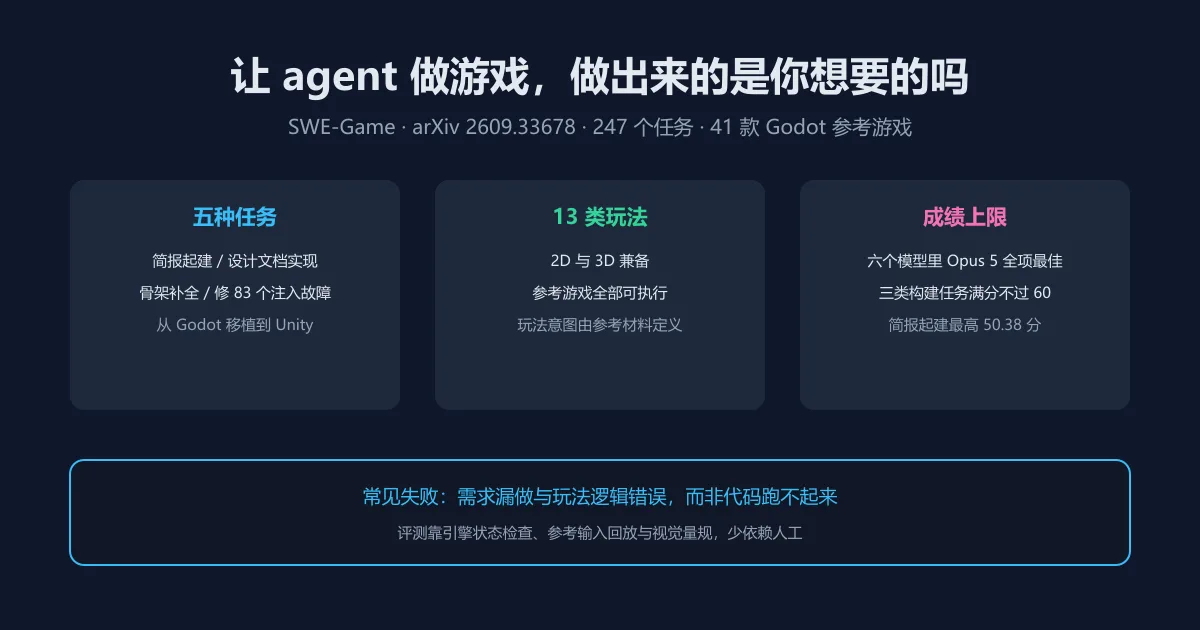
让编码 agent 做个小游戏,它能跑起来,但做出来的是你要的那个游戏吗?10 月 7 日刚修订的 SWE-Game 基准(arXiv 2609.33678,作者 Xiaoyu Chen、Weiran Huang 等 11 人)专门考这个问题,而且考法很扎实:41 款全部可执行的 Godot 参考游戏,覆盖 13 类玩法、2D 与 3D 兼备,从里面拆出 247 个任务,需求的意图由参考材料明确定义,不是靠人脑补。
五种任务与成绩上限
任务分五类:只给一句简报从零建游戏;按设计文档实现;给骨架补全;修复 83 个注入故障;以及把 Godot 游戏移植到 Unity。梯度设计得很聪明,从开放创造到受限工程再到跨引擎迁移,难度维度各不相同。成绩单给了个清醒的锚点:六个受测模型里 Opus 5 在全部五类任务上得分最高,但三类构建任务的最好成绩都没过 60 分(百分制),简报起建一类最高只有 50.38。失败模式的分析更值得细读:主要输在需求漏做与玩法逻辑错误,而不是代码跑不起来。换句话说,agent 的工程能力已经不是短板,理解并守住你要什么才是。
自动评测怎么取信于人
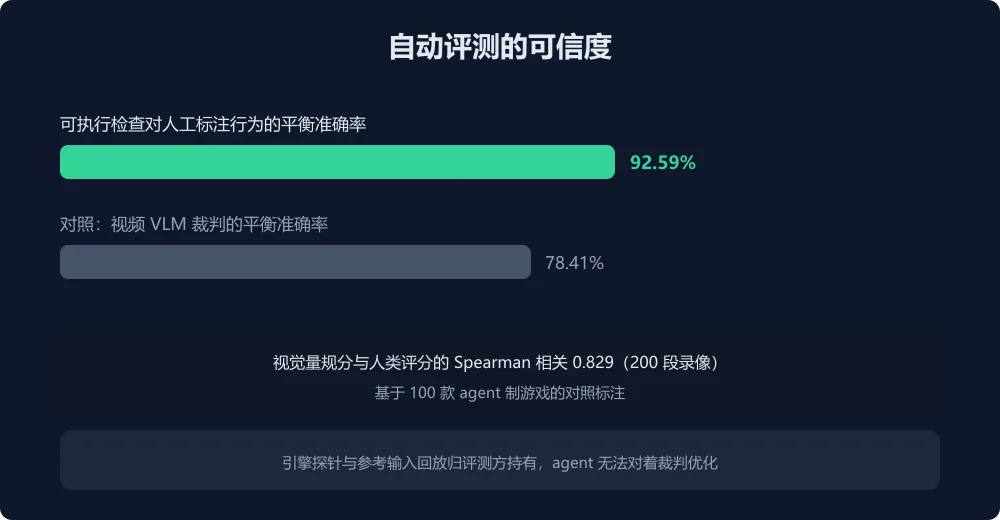
这类基准最大的质疑是裁判可信吗。SWE-Game 的答卷分三层:引擎状态检查直接读游戏内部状态;参考输入回放用认证过的操作序列去验证行为;再加上按游戏定制的视觉语言量规评表现质量。对照数据很有说服力:可执行检查对人工标注行为的平衡准确率 92.59%,明显优于看视频下判断的 VLM 裁判(78.41%);量规视觉分与人类评分的 Spearman 相关达到 0.829。评测侧还有个防作弊细节:探针与回放驱动归评测方持有,agent 没法对着裁判优化自己。
给工程团队的镜子
这份基准的价值超出游戏本身。第一,它是需求保真度的试金石:把任务换成建页面、写报表、搭工作流,需求漏做同样是最常见的失败,SWE-Game 的五类任务设计可以直接搬去做内部验收分类。第二,可执行评测优于看结果猜行为的思路值得抄:能用状态断言就不要用视觉模型下判断,92.59 对 78.41 的差距就是理由。第三,对做 agent 产品的团队,这是给客户展示能力边界时的诚实话术:构建类任务的天花板就在五六十分,交付流程里人的需求把关环节还远不能省。基准与代码未在论文页挂出链接,跟进以作者发布为准。