
字
字节笔记本
2026年11月5日 · 约 1 分钟读完
多模态模型看完视频记得多少?最高分只有 45.7
API中转
¥120
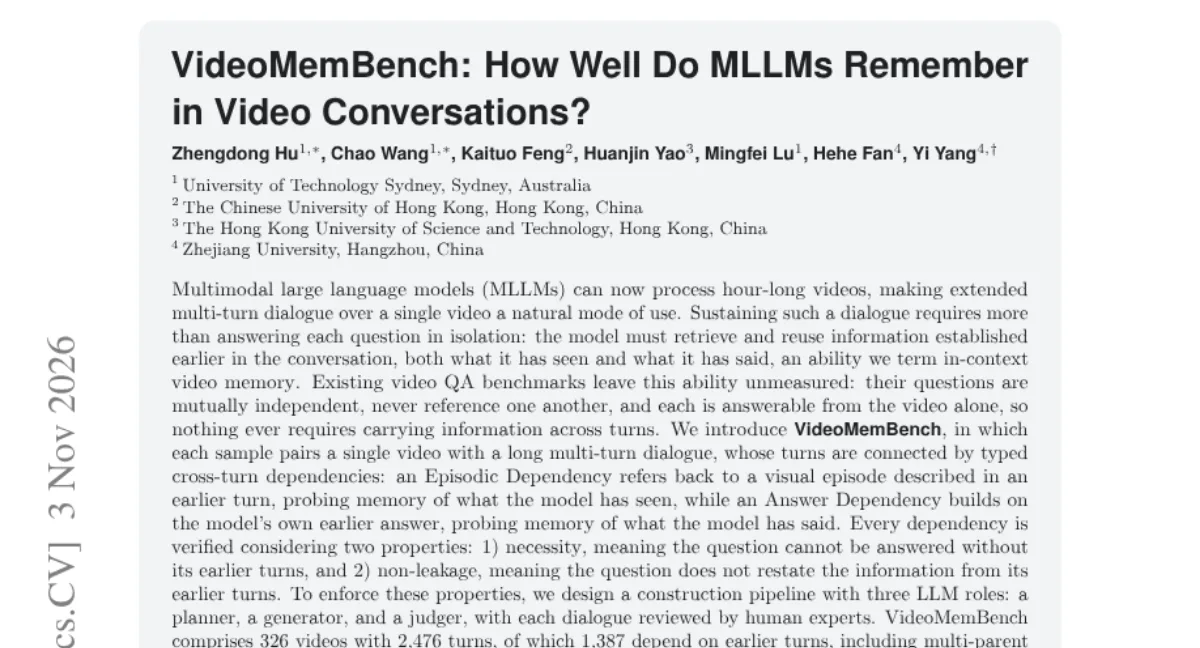
多模态模型的视频理解分数年年涨,但有一个能力一直在及格线下:看完一段长视频、聊了几十轮之后,它还记得自己看过什么、说过什么吗?VideoMemBench(arXiv 2610.40131)把这项能力单独拎出来考了考,结果全班最高分只有 45.7%。
它考的是「情境内视频记忆」:在长多轮视频对话中检索并复用先前信息。现有视频问答基准的题目相互独立、单独看视频就能答,测不出这项能力。VideoMemBench 的每道题由一段视频加一长串多轮对话构成,轮次之间埋了两类依赖:情节依赖回指前面轮次描述过的视觉片段,考「记住了看到的」;回答依赖建立在模型自己先前的回答上,考「记住了说过的」。每条依赖都要满足必要性与不泄露两条性质,前者保证不看前文答不出,后者保证题面不复述前文。构造流水线用 planner、generator、judger 三个 LLM 角色协作,每段对话再经人类专家审核。
规模是 326 个视频、2,476 轮对话,其中 1,387 轮带依赖,还包括多父依赖与长程回溯这种高压题。战绩单相当打脸:20 多个开源与闭源模型上场,Claude Opus 5 以 45.7% 的总分排第一。换成人话:模型在长对话里对自己的「观看历史」和「发言历史」都记不牢,越是聊得久丢得越多。
对做视频助手、会议助手、长视频分析的团队,这个基准指出了一个被榜单掩盖的真实缺陷:长上下文窗口大小不等于记忆能力,能否检索并复用几十轮前的视觉与对话细节才是用户体验的分水岭。基准、代码与数据均已开源,拿自己的产品管线跑一遍,大概率比看任何榜单都有体感。
相关文章

分享: