字节笔记本
2026年10月9日 · 约 9 分钟读完
视觉技能卡不先译成字,凭什么把成功率抬到 89%
把成功轨迹收成技能时,很多系统会先把空间布局和动作状态译成文字。几何关系一进语言,墙在哪、箱子怎么推,就容易糊成一句描述。ViSkill: Reinforcing VLM Agents with Evolving Visual-Native Skills 把成功交互收成视觉技能卡,直接给 VLM agent 用,不再先摊成文本。仓库 ZJU-REAL/ViSkill 本轮 API 核到 8 星、0 个 fork,许可证 MIT。论文 2026-10-08 挂到 arXiv。
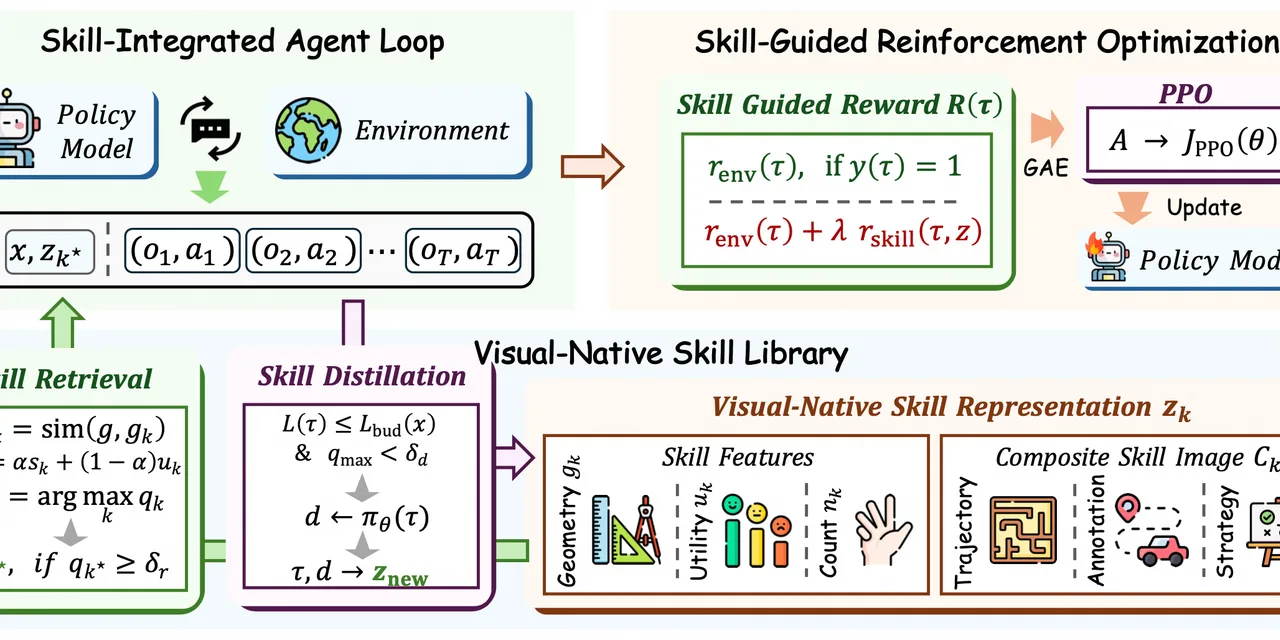
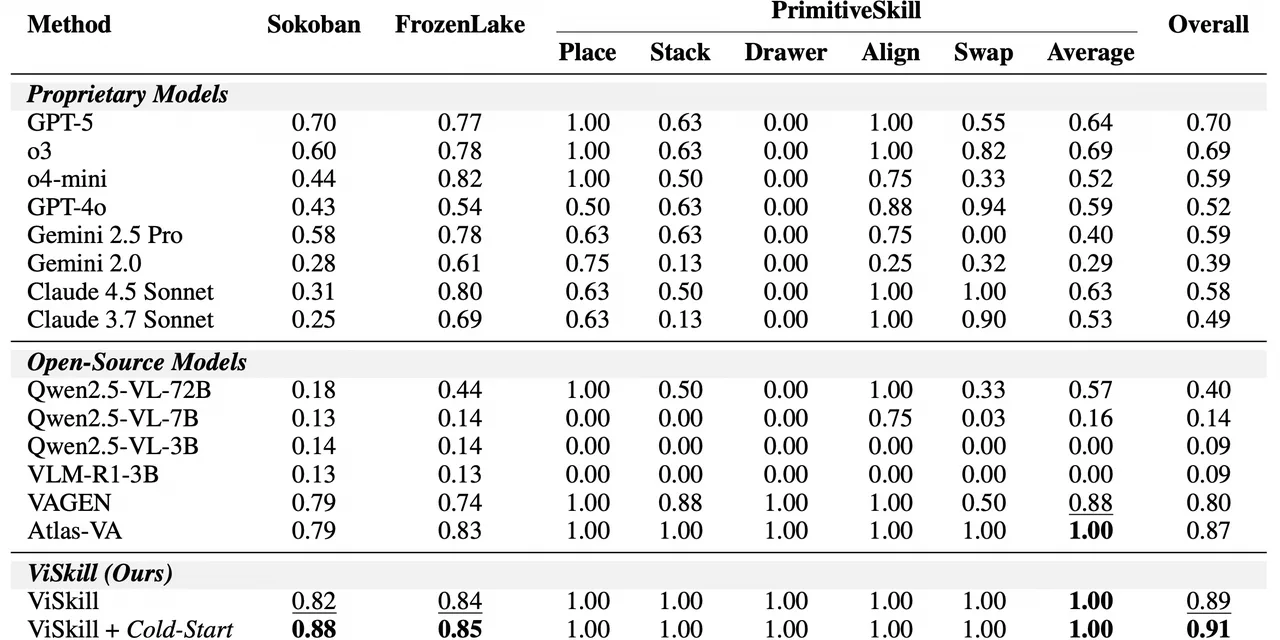
技能检索既指导推理,也塑造奖励;成功轨迹再蒸馏回库,技能积累和策略改进走同一圈。可选冷启动用求解器先铺一批种子技能。评测写在 Sokoban、FrozenLake 和 PrimitiveSkill 上。官方口径:总体成功率 0.89,冷启动后 0.91,快过标准 PPO,也高于他们评过的闭源和开源基线。README 用百分数写成 89% 和 91%,底模默认 Qwen2.5-VL-3B。这些是仓库和摘要数字,不是本轮复现。
技能卡为什么还要带图
摘要把现有路线写成两类问题。一类只会把空间摊成语言,几何结构丢掉。另一类开始用视觉证据,却把技能更新和策略优化拆开,两边不能互相抬。ViSkill 的技能卡带标注轨迹和蒸馏策略,检索按几何来,奖励也按技能走。库不是说明书附件,是训练循环的一部分。
代码 2026-10-08 放出,论文第二天上 arXiv。Hugging Face 上已有 hongxingli/ViSkill-Sokoban 和 hongxingli/ViSkill-FrozenLake,卡片写 apache-2.0,基座都是 Qwen/Qwen2.5-VL-3B-Instruct。本轮两个模型各 10 次下载、0 likes。PrimitiveSkill 权重页 README 没给,评测要另起环境服务。
项目站在 VAGEN 和 veRL 上。仓库把所需 veRL 源码打进树里做复现,并保留原许可证。本轮没有把那两份上游再核一遍星数。三套环境分工不同:Sokoban 和 FrozenLake 偏格子世界里的规划与避险,PrimitiveSkill 走操作仿真,渲染依赖 ManiSkill。论文把它们放在同一套视觉技能闭环里,而不是各写一套文本手册。权重目前只公开前两套,第三套要自己训,或只跑评测脚本对别人的接口。
新闻栏写 2026-10-08 放代码和 Sokoban / FrozenLake 权重,2026-10-09 论文上 arXiv。仓库创建时间是 2026-10-08,最近推送 2026-10-09。星数 8,更像刚开源的研究仓,不是日榜爆款。写进标题的 89% 和 91% 都绑在 Qwen2.5-VL-3B 和这三套环境上,不要外推成任意 VLM 或真实机械臂。
本机怎么接到那 89%
README 写在带 CUDA 的 Linux 上装。克隆后建 viskill 环境,Python 3.10,再 bash install.sh。渲染和资产另跑 bash install_render.sh,PrimitiveSkill 还要 ManiSkill。训练脚本默认 Qwen2.5-VL-3B-Instruct,任务和种子在 examples/train/ 的 YAML 里。开训前改 CUDA_VISIBLE_DEVICES 和 REF_MODEL_PATH。PrimitiveSkill 要先起环境服务,并让 YAML 里的 base_urls 对上地址。
git clone https://github.com/ZJU-REAL/ViSkill.git
cd ViSkill
conda create -n viskill python=3.10 -y
conda activate viskill
bash install.sh
bash install_render.sh
# Sokoban / FrozenLake / PrimitiveSkill
bash examples/train/sokoban/train_ppo_qwen25vl3b_skill.sh
bash examples/train/frozenlake/train_ppo_qwen25vl3b_skill.sh
# PrimitiveSkill 先起环境服务
bash examples/train/primitive_skill/start_env_server.sh
bash examples/train/primitive_skill/train_ppo_qwen25vl3b_skill.sh
三条训练入口都在 README 里。FrozenLake 和 Sokoban 不依赖额外服务;PrimitiveSkill 少了环境服务就起不来。评测侧同样拆成三套 run_eval.sh。本轮没有改这些脚本,只按仓库原文抄命令。
冷启动默认关。要先铺种子技能,就在对应 cold_start_*.yaml 里填接口地址和密钥,再跑 generate_cold_start.sh。训练脚本里打开 skill_system.cold_start.enable=true,并把 source 指到生成的库。评测走训练中的验证 rollout;examples/evaluate/ 另有闭源和开源 VLM 基线。本地推理先 bash examples/evaluate/launch_sglang.sh,再改各环境 config.yaml 里的 backends.openai.base_url、模型和密钥。本轮没有在本机跑通训练。
评测脚本在 examples/evaluate/。Sokoban 和 FrozenLake 可直接 run_eval.sh;PrimitiveSkill 仍要环境服务先起来。本地权重把 MODEL_PATH 和 MODEL_NAME 传给模型服务,并在评测配置里用同一个名字。仓库没有把三条环境的分项成功率再写成表格,首页只给总体 89% / 91%,以及一张三环境对照图。本轮没有把那张图上的柱高逐根读成数字。
冷启动关着也能训,只是前期更慢。摘要把冷启动写成可选加速,不是必选项。求解器种子技能要自备接口,README 用 YOUR_API_BASE_URL 和 YOUR_API_KEY 占位,不要把真实密钥写进仓库。PrimitiveSkill 的 YAML 还要让 base_urls 对上本机环境服务,对不上就训不起来。
星数还低,数字仍以仓库和摘要为准。读这篇只需记住:技能卡带视觉;三环境总体 89%,冷启动 91%;底模是 3B 的 Qwen2.5-VL;代码 MIT,放出的两份权重卡片写 apache-2.0。站内已有的 eviskill 稿谈的是文本技能进化留证据,不是这套视觉闭环,不要并成一篇。OnTrack 和 Cadence 看的是编码轨迹该不该打断,ViSkill 看的是视觉环境里技能库怎么和 PPO 互相抬,三篇可以并排,不要并成一篇。OneSearch-VL 同日也在 cs.CL 新稿里,走的是图和视频深研的证据图,仓库只有 13 星,本轮不并进这篇。读 ViSkill 先核对三件事:技能是不是视觉卡,数字是不是绑在 3B 底模和三套环境上,权重是不是只公开了 Sokoban 和 FrozenLake。两份权重卡片写 apache-2.0,和代码仓 MIT 不是同一份协议。PrimitiveSkill 还要自己起环境服务,第三套权重本轮仓库没有放出。