字节笔记本
2026年10月6日 · 约 17 分钟读完
Agent 编程课 19:项目记忆与 CLAUDE.md
本文是《Agentic Coding 实战课》进阶篇的一章,主题是项目记忆。项目越做越大,每次开新会话都要向 Agent 重新解释一遍背景,这件事又累又容易漏。这一章讲怎么用 CLAUDE.md 把这些解释一次性沉淀下来,让 Agent 开机即懂,也让项目知识像团队 Wiki 一样留存下来。
一、为什么需要项目记忆
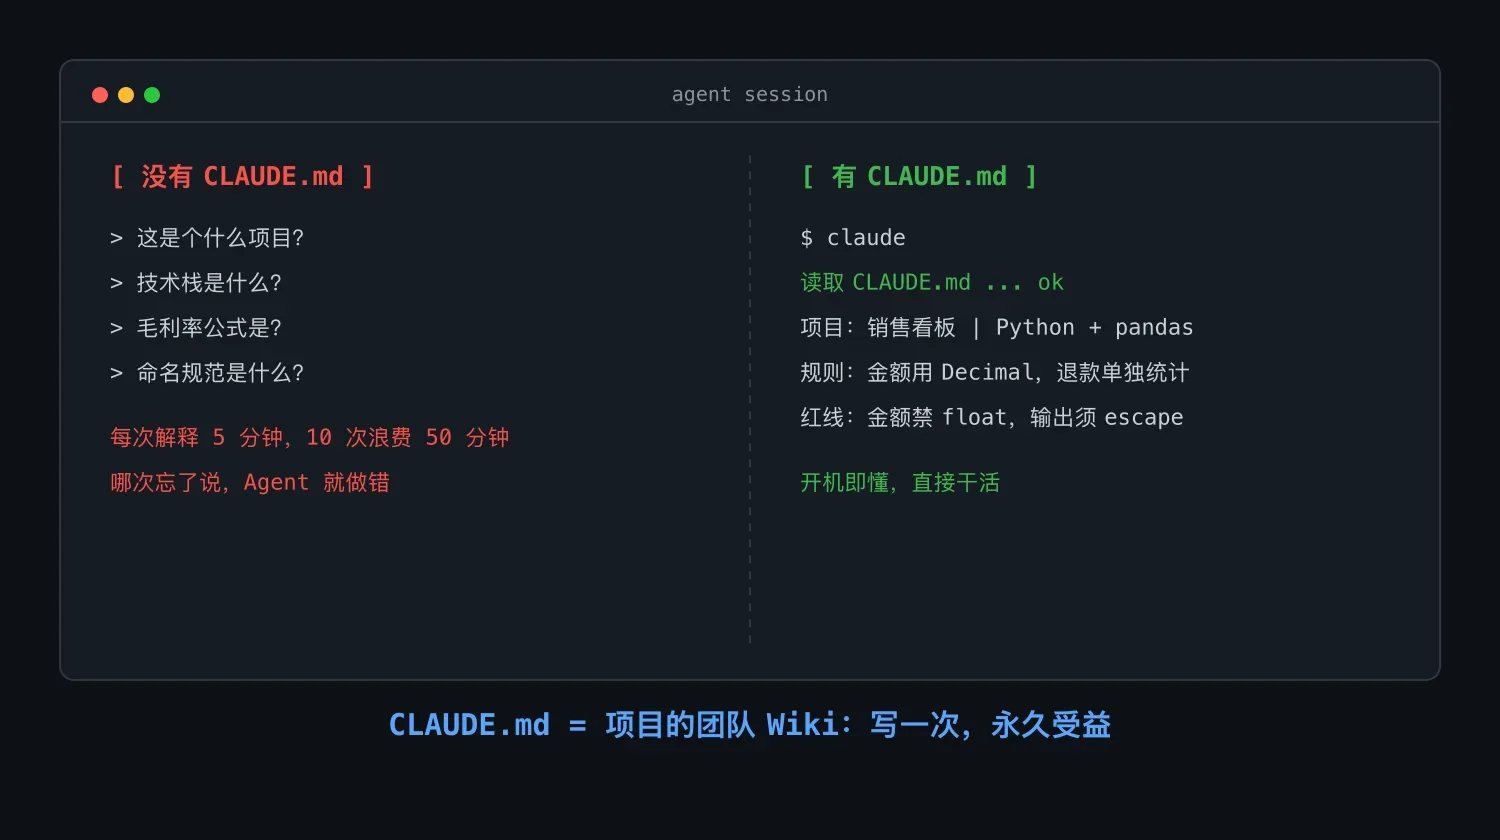
一位学员的项目做了两周,每次启动 Agent 都要重新解释:
- 这是个销售看板项目;
- 技术栈是 Python + pandas + Chart.js;
- 客户名是中文,要按 UTF-8 处理;
- 毛利率公式是什么;
- 命名规则是什么。
每次五分钟,说十次就是五十分钟,纯浪费。更糟的是,哪次忘了说,Agent 就做错了。
解决方案是 CLAUDE.md:放在项目根目录的特殊文件,Agent 每次启动会自动读取。把项目背景写进去一次,之后每次会话都永久受益。
二、CLAUDE.md 与普通文档的区别
| 特性 | 普通 README.md | CLAUDE.md |
|---|---|---|
| 给谁看 | 人 | Agent 优先,人也能看 |
| 何时读 | 人想看才看 | Agent 每次启动自动读 |
| 写法 | 营销、介绍风格 | 简洁、规则化、可执行 |
| 长度 | 不限 | 越短越好(省 token) |
| 更新频率 | 偶尔 | 随项目演进持续更新 |
核心原则一句话:CLAUDE.md 不是"项目介绍",是"Agent 工作规则"。README 写给人看,介绍项目;CLAUDE.md 写给 Agent,给规则,比如"金额必须用 Decimal 类型"。
三、CLAUDE.md 的七层结构
一份完整的 CLAUDE.md 建议包含以下七个部分:
# 项目名 CLAUDE.md

## 1. 一句话项目说明
(让 Agent 30 秒搞懂"这是什么")

## 2. 技术栈
(Agent 要知道用什么工具)

## 3. 项目结构
(文件在哪里,谁负责什么)

## 4. 业务规则(最重要)
(你的领域知识,Agent 不会自己知道)

## 5. 编码规范
(命名、格式、注释规则)

## 6. 工作流规则
(怎么 commit、怎么测试、何时清空上下文)

## 7. 常见坑与红线
(不要做什么,安全边界)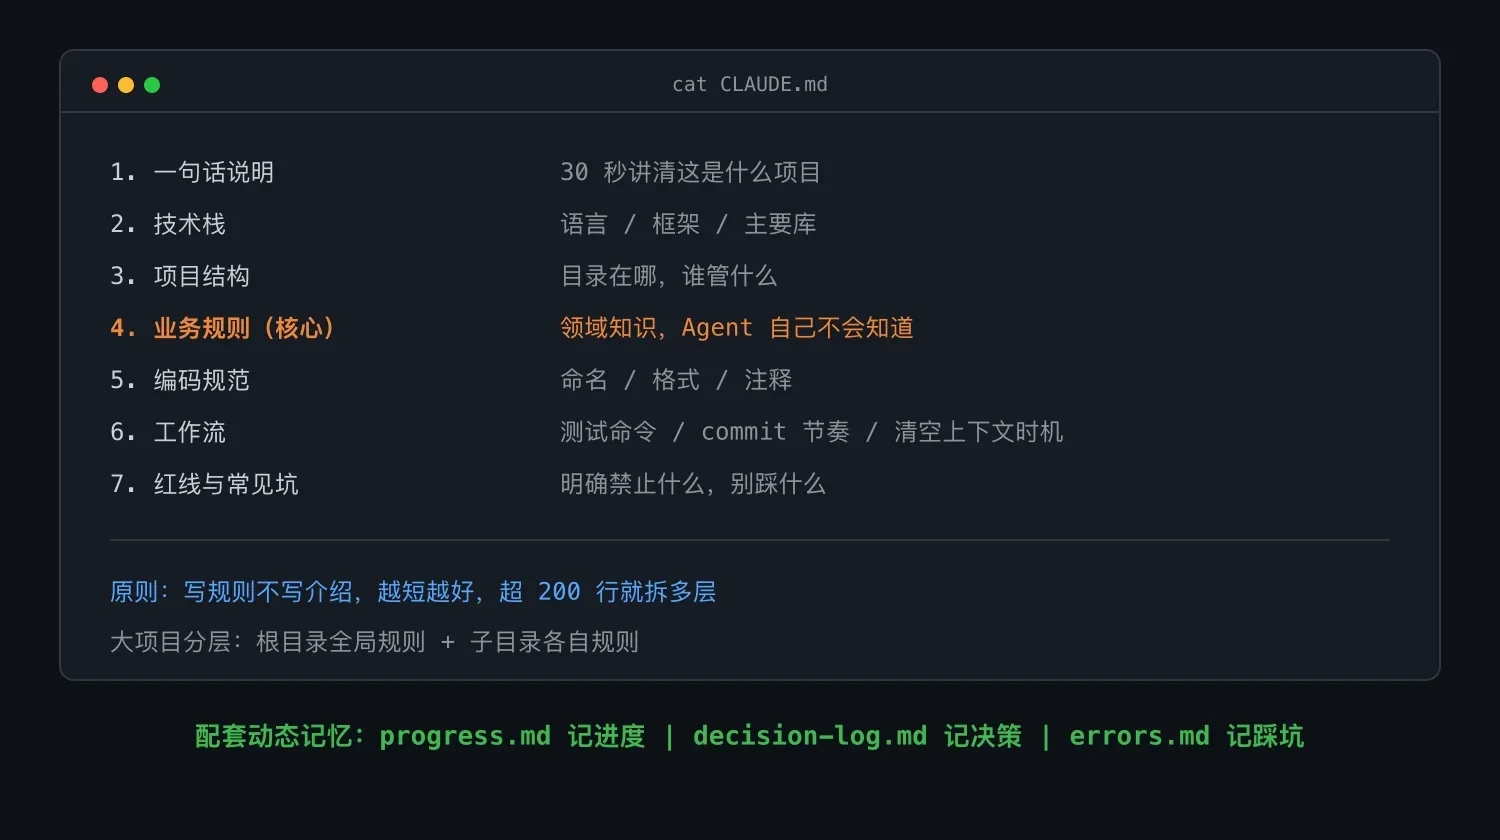
四、一份完整的示例
用一个销售看板项目举例:它把 ERP 导出的销售 CSV 转成网页看板,会计每周一跑一次,生成 dashboard.html 发给老板。下面是一份生产级 CLAUDE.md:
# 销售看板 CLAUDE.md

## 1. 一句话说明
这是一个把 ERP 导出的销售 CSV 转成网页看板的工具。
会计每周一跑一次,生成 dashboard.html 发给老板。

## 2. 技术栈
- Python 3.11+
- pandas(数据处理)
- Chart.js(前端图表,CDN 引入)
- pytest(测试)
- 无数据库、无后端、无部署

## 3. 项目结构
sales-dashboard/
├── data/                # CSV 输入
├── src/
│   ├── data_loader.py   # 读 CSV + 清洗
│   ├── calculator.py    # KPI + Top + 趋势
│   └── render.py        # 生成 HTML
├── tests/               # pytest 测试
├── output/              # 生成的 dashboard.html
├── main.py              # 入口
└── SPEC.md              # 完整规格

## 4. 业务规则(核心)

### 数据清洗
- amount 为负 = 退款,单独统计,不算入销售总额
- customer 为空 = 散户,归到"未分类"
- date 列必须解析为 datetime
- product 列去前后空格

### 计算规则
- 总销售额 = SUM(amount) WHERE amount > 0
- 客单价 = 总销售额 / 有效订单数
- 毛利率 = (总销售额 - 总成本) / 总销售额 × 100%
- 异常:本周销售环比下降超过 20% 标红

### 业务常识(用于验证)
- 毛利率正常区间:25% 到 35%
- 单笔订单金额区间:100 到 100000 元
- 异常值(小于 100 或大于 100000)要单独报告

## 5. 编码规范

### Python
- 函数用 snake_case
- 类型注解必加(def foo(x: int) -> str:)
- docstring 用 Google 风格
- import 顺序:标准库 / 第三方 / 本项目

### 命名
- 文件全小写下划线:data_loader.py
- 函数动词开头:load_data / calc_kpis
- 常量全大写:MAX_ORDER_VALUE

### 注释
- 业务规则必须有注释,标注"业务规则:"
- 不要解释"代码做什么",要解释"为什么"

## 6. 工作流规则

### 开发节奏
- 一个大任务一次会话
- 完成后跑 pytest tests/,全绿才能 commit
- commit message 写"做了什么",不写"改了什么"

### 测试
- 业务逻辑必须配测试
- 测试覆盖:正常、边界、错误三类
- 跑测试命令:pytest tests/ -v

### 调试
- 修 bug 先复现(写失败测试)
- 先告诉原因,再改代码
- 修完跑全量回归

## 7. 红线与常见坑

### 红线
- 金额计算禁止用 float,必须用 Decimal(精度问题)
- 客户名渲染到 HTML 前必须 html.escape(XSS 防护)
- 禁止用 eval / exec 处理 CSV 数据

### 常见坑
- CSV 中文乱码:用 utf-8-sig 读取
- Chart.js CDN 国内慢:换 staticfile.org
- pandas groupby 之后要 reset_index

### 安全
- data/ 目录的 CSV 是业务数据,不能 commit
- 不要把测试数据写死在代码里,用 fixtures
注意,这份 CLAUDE.md 全是"领域知识"和"工作规则",相当于把一位资深会计学员十几年的经验做了一次代码化浓缩。Agent 读了它,等于直接继承这些经验。
五、写 CLAUDE.md 的五个原则
原则 1:给规则,不给介绍
反例:"这是一个销售看板项目,让老板开心..."
正例:"总销售额只算 amount 大于 0 的订单"
原则 2:用"必须、不能",不用"建议、最好"
反例:"最好用 Decimal 算金额"
正例:"金额计算必须用 Decimal"
原则 3:越短越好
CLAUDE.md 占用每次会话的 token,超过 200 行就要瘦身。三个瘦身技巧:
- 删掉"显而易见"的内容(Python 用 4 空格缩进不用写);
- 把详细规范拆到单独文件(如 docs/coding-style.md),CLAUDE.md 只放最重要的 10 条;
- 用链接引用:"详细规范见 docs/testing.md"。
原则 4:随项目演进
CLAUDE.md 不是写一次就完。每发现一个新坑、新规则,立刻补进去:
# 比如今天发现 CSV 里偶尔有 BOM 字符
# 立刻更新 CLAUDE.md:
echo "- CSV 读取消 BOM:encoding='utf-8-sig'" >> CLAUDE.md
git commit -am "CLAUDE.md: 加 BOM 处理规则"
原则 5:让 Agent 帮你写和维护
> 看看我们最近 10 个 commit,有没有发现新的"业务规则"
  或"踩过的坑"还没写进 CLAUDE.md 的?建议补充。
Agent 会主动发现:"你昨天修了 BOM 问题,但 CLAUDE.md 没写,建议加。"
六、多层 CLAUDE.md:大项目的进阶结构
项目超大时,单个 CLAUDE.md 不够,可以分层:
项目根/CLAUDE.md          全局规则(所有目录适用)
项目根/src/CLAUDE.md      后端规则
项目根/frontend/CLAUDE.md 前端规则
项目根/tests/CLAUDE.md    测试规则
根 CLAUDE.md 管项目总览、全局业务规则、跨模块约定;子目录 CLAUDE.md 管该模块的特定规则、常见坑和测试方式。Agent 进入哪个目录工作,就优先读那个目录的 CLAUDE.md。
七、动态记忆:进度、决策与错误档案
CLAUDE.md 是"静态记忆"。还有三种"动态记忆",按需让 Agent 读取和更新。
1. 进度文件 progress.md
每个会话开始,让 Agent 读它:
# progress.md

## 已完成
- 数据层(data_loader.py)+ 5 个测试
- 计算层(calculator.py)+ 8 个测试

## 进行中
- 展示层(render.py):卡在 Chart.js 配置

## 下一步
- 完善 KPI 卡片样式
- 给 Top 客户表格加分页

## 历史清空上下文时间点
- 14:30 完成 1.1
- 15:45 完成 2.1
每次清空上下文(/clear)之前让 Agent 更新它,新会话读它就能秒速恢复。
2. 决策记录 decision-log.md
记录重要决策的"为什么":
# 决策记录

## 选择 pandas 而不是 polars
- 原因:会计熟悉 pandas,便于以后维护
- 备选:polars(更快,但学习曲线陡)

## 选择 Chart.js 而不是 ECharts
- 原因:CDN 引入即可,无构建步骤
- 备选:ECharts(功能多,但复杂)
这是"防健忘"机制:三个月后你忘了"当时为什么这么选",看一眼就懂。
3. 错误档案 errors.md
每次踩坑后记录:
# 错误档案

## E001: CSV 中文乱码
- 现象:客户名显示成问号
- 根因:CSV 是 GBK 编码
- 解决:pd.read_csv(f, encoding='gbk') 或 utf-8-sig

## E002: 毛利率 80%
- 现象:算出来毛利率高得离谱
- 根因:忘了扣成本
- 解决:补 (revenue - cost) 公式
下次遇到类似问题,让 Agent 先查 errors.md:"遇到一个 bug,先查 errors.md 看是不是历史问题。如果是,按记录的方案修。"
八、CLAUDE.md 模板(照抄即可用)
# [项目名] CLAUDE.md

## 一句话说明
[这个项目做什么,给谁用,多久用一次]

## 技术栈
- 语言 / 框架 / 主要库

## 项目结构
[tree 一级目录,每个标注用途]

## 业务规则(核心)
### 数据规则
- ...
### 计算规则
- ...
### 业务常识(验证用)
- ...

## 编码规范
- 命名 / 格式 / 注释要点

## 工作流
- 测试命令:...
- commit 节奏:一个大任务一次
- 清空上下文时机:...

## 红线
- 禁止 ...

## 常见坑
- ...

## 进阶文件(按需读)
- progress.md(当前进度)
- decision-log.md(决策记录)
- errors.md(错误档案)
九、一个真实的进化故事
一位学员的 CLAUDE.md 进化史,很能说明问题:
- 第 1 周:空。每次开 Agent 都要解释五分钟,踩了一堆坑。
- 第 2 周:1.0 基础版。写了项目说明和技术栈,少踩一些坑,但还是漏业务规则。
- 第 4 周:2.0 业务规则版。把退款处理、毛利率公式、异常值判断补进去,Agent 准确率从 60% 升到 90%。
- 第 8 周:3.0 完整版。加了红线、错误档案、决策记录,Agent 几乎不犯重复错。
CLAUDE.md 越完善,Agent 越准,你越省心,这就是它在项目层面的"投资回报"。
十、让 Agent 主动维护 CLAUDE.md
可以直接把这条写进工作规则:
每次你完成一个大任务,在 commit 前:
1. 检查是否发现了新的业务规则、坑、决策
2. 如果有,提议更新 CLAUDE.md(不要直接改,先问我)
3. 我确认后再 commit 一起

每 5 个 commit 做一次 CLAUDE.md 大扫除:
删过时的、合并重复的、提炼模糊的
这样 CLAUDE.md 会自动保持新鲜,不会沦为过时文档。
十一、上手练习
- 用上面的模板,给你手头任意一个已完成的项目写一份完整的 CLAUDE.md。
- 创建 progress.md 记录当前进度,清空上下文后让新会话读它,看能否秒速恢复上下文。
- 创建 errors.md,把你最近踩过的坑都记录进去。
- 让 Agent 帮你审阅现有 CLAUDE.md:"从'如果你是新接手的 Agent'的角度,指出哪些信息缺失、哪些表述模糊、哪些过时。"
- 进阶:把一个前后端分离的全栈项目的规则拆成"根目录 + frontend + backend"三层。
- 思考:下面这个 CLAUDE.md 有什么问题?
# 项目说明
这是一个销售看板。

# 用法
python main.py
参考答案:没有业务规则,没有编码规范,没有红线,太短没有价值。
要点回顾
- CLAUDE.md 是项目的"团队 Wiki",Agent 每次启动自动读取。
- 写"规则"不写"介绍",用"必须"不用"建议"。
- 七层结构:说明、技术栈、结构、业务规则、编码规范、工作流、红线。
- 业务规则是最核心的部分,那是你的领域知识的代码化。
- 越短越好,控制在 200 行以内,超了就拆多层。
- 配套动态记忆:progress.md 记进度、decision-log.md 记决策、errors.md 记错误。
- 让 Agent 帮你持续维护 CLAUDE.md。
- CLAUDE.md 越完善,Agent 准确率越高,你越省心。
想更进一步,可以研究"评估驱动开发":用数据衡量 Agent 表现,让项目改进从"凭感觉"变成"看数据"。
参考资料
- Claude Code CLAUDE.md 官方文档
- Anthropic Best Practices for Claude Code(项目记忆部分)
- Architecture Decision Records(ADR,决策记录的出处)