字节笔记本
2026年10月6日 · 约 19 分钟读完
AI 工作流 07:从 Token 到注意力,看懂大模型
本文是《AI 工作流工程师》系列专栏的大模型原理篇。做 AI 应用不需要会推导公式,但必须懂大模型的工作原理,否则没法 Debug、没法做优化,面试也答不上来。这一篇用零数学公式的方式讲清楚:大模型为什么能"接话"、为什么会幻觉、为什么有上下文限制。
一、最核心的一句话:预测下一个 token
如果你只能记住一件事,记住这句:
大模型的本质,就是"根据前面的话,预测下一个字"。
所有看起来很神奇的能力,对话、写代码、推理、翻译,底层都是这一个动作的反复执行。
举个例子:
输入:"今天天气真"
模型预测下一个字最可能是:"好"(80%)/ "差"(10%)/ "热"(5%)
选了"好",现在变成:"今天天气真好"
再预测下一个字,可能是 "," / "!"
一直接下去,就组成了一段话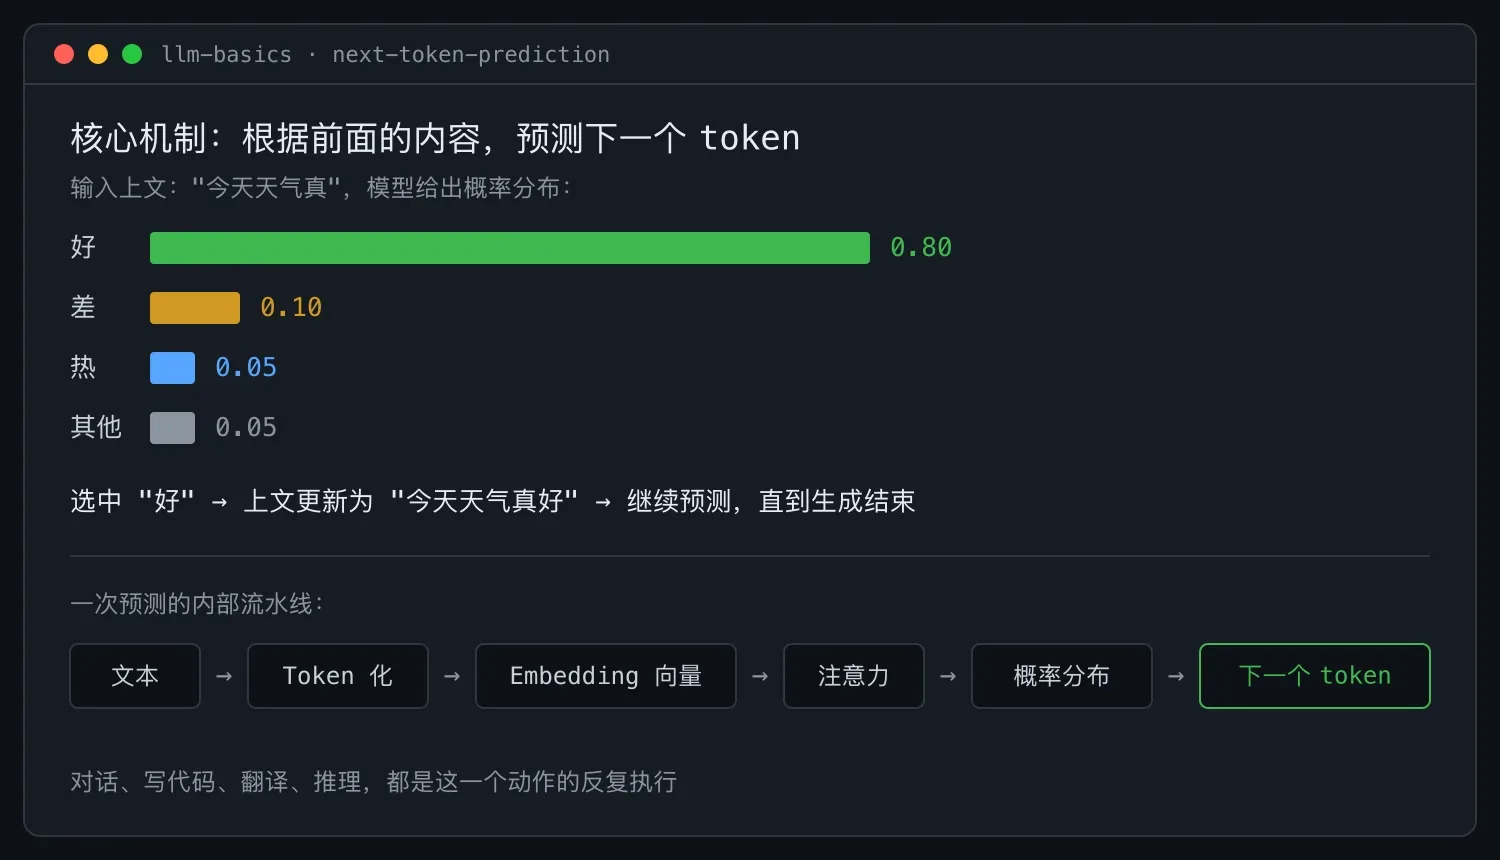
就这样,没有任何魔法。ChatGPT 回答你的问题,本质就是把"你的问题"当上文,然后一个字一个字地"接下去"。
这个心智模型能解释 LLM 的很多现象:
| 现象 | 用"接话"模型解释 |
|---|---|
| 为什么能对话? | 你的问题是上文,它接的"答"就是回答 |
| 为什么会幻觉(编造)? | 它只管"接得通顺",不管"是不是真的" |
| 为什么换种问法答案就不一样? | 上文变了,预测的概率就变了 |
| 为什么长文本会"忘了前面"? | 上下文窗口有限,前面的内容"看不到"了 |
| 为什么有的模型写代码强? | 训练时看了更多代码,"代码接龙"接得准 |
二、LLM 是怎么被训练出来的?三大阶段
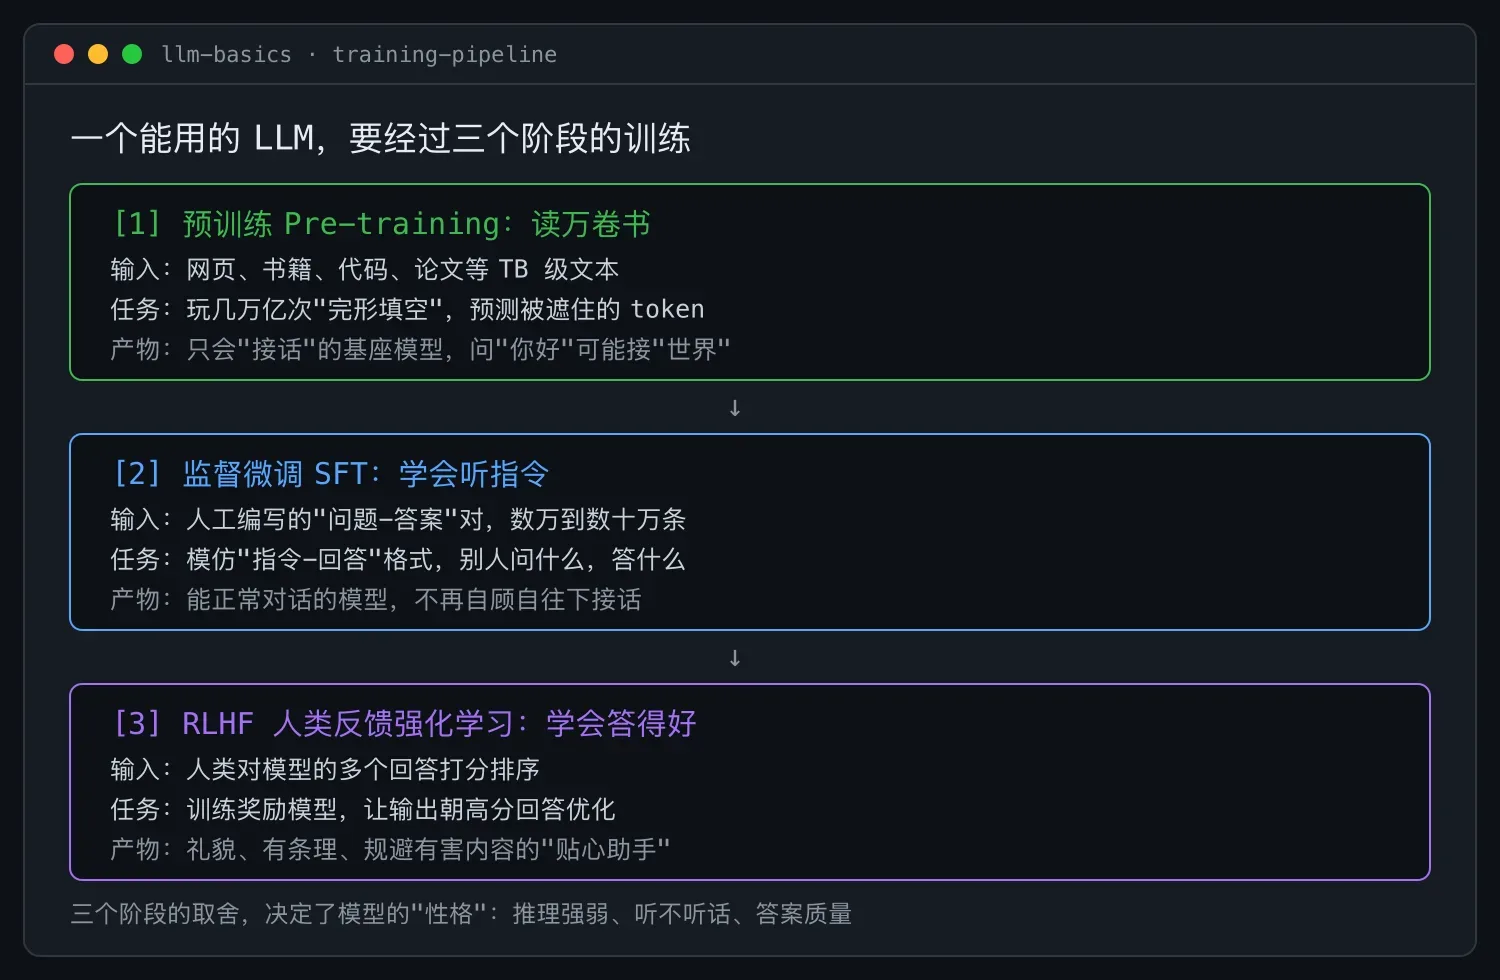
一个能用的 LLM(如 GPT-4)要经过三个阶段的训练。理解这三个阶段,你就懂了为什么 LLM 会有那些"性格"。
2.1 阶段一:预训练(Pre-training),读万卷书
这一步让模型"读完整个互联网"。喂给它几 TB 的文本(维基百科、书籍、网页、代码、论文),让它玩"完形填空"游戏几万亿遍。
产物:一个会"接话"的模型。但这时候它还不会聊天:你问它"你好",它可能接"世界"(因为训练数据里"你好"后面常接"世界"),而不是回答你。
类比:一个读过万卷书、但没受过社交训练的书呆子。
2.2 阶段二:监督微调(SFT),学会听指令
人工写几万到几十万条"问题-答案"对,比如"北京是哪个国家的首都?"对应一句标准回答,让模型学着模仿这种"指令-回答"的格式。
产物:现在它会听人话了。你问它问题,它会回答,而不是接着往下接话。
类比:书呆子上了社交课,学会"别人问什么,答什么"。
2.3 阶段三:RLHF(人类反馈强化学习),学会讨人喜欢
SFT 出来的模型已经能用,但答得不一定"好"。RLHF 让人类给模型的多个回答打分("答 A 比答 B 好"),训练一个"奖励模型",再用强化学习让 LLM 朝着"高分回答"优化。
产物:模型变得礼貌、有条理、避免有害内容,变成 ChatGPT 那种"贴心助手"。
类比:社交达人,不光会答,还答得让你满意。
2.4 为什么这个知识对你有用?
不同模型在不同阶段做了不同取舍:
| 模型 | 特点 | 原因 |
|---|---|---|
| DeepSeek-R1 / o1 | 推理极强,但慢、啰嗦 | RLHF 阶段特别强化了"思考过程" |
| GPT-4o | 综合均衡、快 | 三个阶段都做得扎实 |
| Claude | 写作、代码好 | SFT 数据质量极高 |
| 开源小模型(Qwen 7B) | 简单任务够用,复杂任务差 | 参数量小,预训练"读得少" |
给业务选模型时,本质是在挑"它的训练侧重适不适合你的场景"。
三、Token 化:把文字变成模型能吃的数字
模型不认识字,只认识数字。所以第一步是把文本切成 token,再把 token 转成数字 ID。
3.1 Token 是怎么切的?
不同模型用不同的分词器(tokenizer)。常见的 BPE(Byte Pair Encoding)算法按"高频片段"切:
英文 "hamburger" → ["ham", "burger"] → [3456, 7890]
英文 "tokenization" → ["token", "ization"] → [1234, 5678]
中文 "我爱学习" → ["我", "爱", "学习"] → [890, 234, 567]
罕见词 "AGI" → ["A", "G", "I"] → 单字切(因为罕见)
为什么有的英文词要切成好几个?因为分词器是按"统计频率"学出来的:常见词整块切,罕见词只能拆。
3.2 实操:看看一句话多少 token
import tiktoken

enc = tiktoken.encoding_for_model("gpt-4o")

text1 = "The quick brown fox jumps over the lazy dog."
text2 = "敏捷的棕色狐狸跳过了懒狗。"

print(f"英文 {len(enc.encode(text1))} tokens: {enc.encode(text1)}")
# 英文 9 tokens

print(f"中文 {len(enc.encode(text2))} tokens: {enc.encode(text2)}")
# 中文约 13 tokens(中文比英文费 token)
3.3 Token 和钱的关系
各家模型按 token 计费,价格差异巨大(以下为写作时的参考价,以各厂商官网实时价格为准):
GPT-4o:        输入 $2.5/M tokens,  输出 $10/M tokens
Claude 4:      输入 $3/M tokens,    输出 $15/M tokens
DeepSeek V3:   输入 ¥1/M tokens,    输出 ¥2/M tokens    (便宜约 20 倍)
通义 Qwen3:    输入 ¥0.5/M tokens,  输出 ¥2/M tokens
算笔账:处理 100 万字中文(约 150 万 token),GPT-4o 大约要 $3.75,DeepSeek 大约只要 ¥1.5(约 $0.2),差 20 倍。这就是为什么国内项目大多用 DeepSeek、通义,海外项目用 GPT、Claude。成本敏感的项目,token 单价是选型时必须算清的一笔账。
四、Embedding:让模型理解"语义"
Token ID 只是个编号("猫"=890,"狗"=8900),数字本身没有意义。Embedding 把它转成有语义的向量。
4.1 什么是 Embedding?
Embedding 就是把每个 token 映射到一组数字(比如 1536 维的向量),让"意思相近的词,向量也相近":
"猫"  → [0.21, -0.45, 0.88, ..., 0.12]   (1536 个数字)
"狗"  → [0.19, -0.41, 0.85, ..., 0.10]   (和"猫"很接近)
"汽车" → [-0.78, 0.32, -0.11, ..., 0.95] (和"猫""狗"差很远)
为什么要这样?因为数字才能算"相似度"。算两个向量的余弦相似度,就知道两个词有多像。
4.2 为什么 Embedding 是 RAG 的基础?
RAG(检索增强生成)的核心是"找出和问题最相似的文档"。做法是:
- 把所有文档切片,每片算一个 Embedding(向量),存进向量库
- 用户提问时,把问题也算成 Embedding
- 算问题向量和每个文档向量的相似度,取最相似的几片喂给模型
这就是为什么"语义相似的内容能被找到",而不是只靠关键词匹配。比如搜"如何退款",能找到"退货流程"的文档,虽然没有"退款"这两个字,但语义相近,向量距离也近。
五、注意力机制:让模型"看懂上下文"
这是 Transformer(GPT 等模型用的架构)的灵魂。不用懂公式,但要懂它的作用。
5.1 一个类比
读这句话:"我去了银行,存了钱。"
你怎么知道"银行"指的是"金融机构"而不是"河岸"(bank 在英文里有两个意思)?因为后面的"存了钱"给了你线索。
注意力机制就是让模型干这件事:读到每个词时,回头看上下文里哪些词最重要,给它更多"注意力"。
5.2 注意力解决的核心问题:一词多义
"苹果很好吃"       → 这里的"苹果"是水果
"苹果发布了 iPhone" → 这里的"苹果"是公司
传统方法(如 Word2Vec)给"苹果"固定一个向量,分不清这两种意思。注意力机制让"苹果"的向量随上下文动态变化:第一句里向"水果"偏,第二句里向"公司"偏。这就是 Transformer 比以前的模型强得多的原因。
5.3 多头注意力:多个角度看问题
GPT 用的是"多头注意力",同时从多个角度看上下文。打个比方:
- 一个"头"看语法关系(主谓宾)
- 一个"头"看情感色彩
- 一个"头"看指代关系("他"指代谁)
- 一个"头"看专业领域
GPT-3 用了 96 个头,GPT-4 估计有几百个。多头,就是多角度综合判断。
5.4 这对你有什么用?
| 现象 | 原理 |
|---|---|
| 上下文越长越慢(注意力是 O(n²)) | 每个词要看所有其他词,n 翻倍计算量变 4 倍 |
| 上下文窗口有限(如 128k) | 注意力显存占用随长度平方增长 |
| 中间信息容易被忽略(lost in the middle) | 注意力分布不均,开头结尾强,中间弱 |
| Prompt 顺序影响效果 | 注意力权重对位置敏感 |
实战启示:把最重要的指令放在 Prompt 的开头或结尾,把检索到的文档放中间,效果会更好。
六、上下文窗口:模型的"短期记忆"
每个模型有上下文窗口限制,也就是它能"看到"的最大 token 数:
| 模型 | 上下文窗口 |
|---|---|
| GPT-4o | 128K tokens(约 10 万字中文) |
| Claude 4 | 200K tokens |
| Gemini 2.5 Pro | 1M tokens |
| DeepSeek V3 | 128K tokens |
| 早期开源模型 | 4K–32K tokens |
6.1 超了会怎样?
- 大多数 API 会报错(输入超长)
- 有的会自动截断前面的内容(你前面的话被丢弃)
- 长文本里中间内容容易被忽略(lost in the middle 问题)
6.2 窗口不够怎么办?
这正是 RAG 要解决的问题:不要把所有资料都塞给模型,而是先检索出最相关的几段,只塞这几段。比如你有 1 万份文档(10 亿 token),不可能全塞进模型,RAG 帮你只取最相关的 5000 token 喂进去。
七、温度(Temperature):控制"创造力"
7.1 温度是什么?
LLM 预测下一个 token 时给出的是概率分布,温度控制"按概率随机选"还是"总选最高的":
温度 = 0:永远选概率最高的(输出稳定,但机械)
温度 = 0.7:大部分选最高,偶尔换一个(自然,平衡)
温度 = 1.0:更随机(有创造力)
温度 = 2.0:极度随机(乱说)
7.2 不同任务用不同温度
| 任务 | 推荐温度 | 原因 |
|---|---|---|
| 代码生成 / 信息提取 / 数学 | 0–0.2 | 要准确稳定 |
| 客服问答 / 总结摘要 | 0.3–0.5 | 略有变化但可控 |
| 营销文案 / 创意写作 | 0.7–1.0 | 要有创造力 |
| 头脑风暴 | 1.0–1.3 | 越发散越好 |
生产环境默认用 0(确定性、可复现、好 Debug),需要创意时再调高。
八、幻觉(Hallucination):为什么 AI 会"一本正经地胡说"
8.1 幻觉的本质
回到 LLM 的本质:"预测下一个 token"。它只保证"接得通顺、像真的",不保证"是真的"。
例子:你问"GPT-4 的训练用了多少张 A100 显卡",它可能说"约 25000 张 H100"。这听起来很专业,但它实际上只是在"接一段听起来像技术答案的话",数字可能是编的。
8.2 减少幻觉的工程手段
| 手段 | 原理 |
|---|---|
| RAG | 给它资料,让它"基于资料回答" |
| 低温度 | 减少随机胡编 |
| 要求引用来源 | 逼它标注依据 |
| 允许说"不知道" | Prompt 里加"资料不足时明确说不知道" |
| Guardrails | 输出后自动检查可信度 |
| 微调 | 用你的数据让它学得更准 |
没有任何手段能 100% 消除幻觉。生产 AI 系统必须接受这一点,用多种手段叠加,再加上人工审核(HITL)兜底。
九、常见模型家族速览
帮你建立模型地图:
| 家族 | 代表模型 | 特点 | 适合场景 |
|---|---|---|---|
| OpenAI GPT | GPT-4o / o3 | 综合最强,贵 | 高质量任务 |
| Anthropic Claude | Claude 4 / 3.5 | 长文本、写代码强 | 文档分析、编程 |
| Google Gemini | 2.5 Pro | 多模态、超长上下文 | 视频图片理解 |
| Meta Llama | Llama 4 | 开源旗舰 | 本地部署、微调 |
| DeepSeek | V3 / R1 | 推理强、超便宜 | 国内项目首选 |
| 阿里 Qwen | Qwen 3 | 开源生态好、中文强 | 国内企业落地 |
| 智谱 GLM | GLM-4 | 合规友好 | 国企、政企 |
| Mistral | Mixtral / Large | 欧洲开源 | 海外合规 |
选型原则:先按"国内还是海外""开源还是闭源""预算多少"筛一遍,再按任务类型(推理、写作、代码)选。
十、小结
- LLM 的本质是"预测下一个 token",所有能力都是这个动作的反复执行。
- 训练三阶段:预训练(读万卷书)、SFT(学会听指令)、RLHF(学会讨人喜欢)。
- Token 是模型处理和计费的最小单位;Embedding 把 token 变成有语义的向量,是 RAG 的基础;注意力机制让模型看懂上下文,是一词多义的解法。
- 上下文窗口是模型的短期记忆限制,窗口不够要靠 RAG。
- 温度控制创造力:精确任务用 0,创意任务用 0.7 以上。
- 幻觉是 LLM 的本性(只管通顺不管真假),要靠 RAG、低温度、要求引用、Guardrails 和人工审核多重叠加来降低。
- 主流模型分 GPT / Claude / Gemini / Llama / DeepSeek / Qwen / GLM 几大家族,按场景选型。
十一、动手练习
练习 1(理解):用自己的话向非技术朋友解释"为什么 ChatGPT 会胡说八道",用本篇的"接话"类比。如果他听懂了,你就真懂了。
练习 2(实操):用 tiktoken 算一篇 1000 字文章有多少 token,估算用 GPT-4o 和 DeepSeek 各处理一次要多少钱。
练习 3(实验):调 OpenAI 或 DeepSeek 的 API,对同一个问题分别用 temperature = 0 / 0.7 / 1.5 各问 5 次,对比输出的差异。
练习 4(思考):你想做一个"医疗咨询 AI",会怎么用本篇的知识控制幻觉?(提示:温度、RAG、Prompt、人工审核综合用)
十二、延伸阅读
- 论文《Attention Is All You Need》(Transformer 原论文,看不懂没关系,翻一翻):https://arxiv.org/abs/1706.03762
- Andrej Karpathy 的《Let's build GPT》视频教程(YouTube,从零搭一个 GPT)
- 3Blue1Brown 的《But what is a GPT?》可视化讲解注意力机制
- OpenAI Tokenizer 在线工具:https://platform.openai.com/tokenizer
- DeepSeek 技术报告(看预训练和 RLHF 怎么做):https://arxiv.org/abs/2401.02954
- 书:《这就是 ChatGPT》(Stephen Wolfram),小白读懂 LLM 的最佳科普
结语
把这篇的原理和你的日常调用对照起来:你在代码里设置的 temperature、max_tokens、上下文裁剪策略,背后就是这些机制。理解了原理,Prompt 写法、模型选型、参数调优就不再是玄学,而是有依据的工程决策。