字节笔记本
2026年10月6日 · 约 2 分钟读完
难 token 多算几轮,容易 token 一次过
两篇今日 Hugging Face 论文榜的高票新作,恰好一个管生成、一个管执行,都在回答同一个问题:计算与经验怎么按需分配。
ALoDLM:token 级的计算分诊
扩散语言模型并行生成速度快,质量却落后同规模的自回归模型。Liancheng Fang 等人的 ALoDLM(arXiv:2610.04198,今日榜 12 赞)把病根定位在计算错配:有的未知 token 一眼就有答案,有的需要反复琢磨,而现有 DLM 对所有位置一刀切地用同一深度。
解法是 token 自适应潜空间循环:每个去噪步先精修潜表征并按 token 难度分配计算,有把握的 token 立即提交为离散上下文退出计算,没解决的继续走循环精修。计算调度本身被当作潜变量,用条件负证据下界做联合训练。成绩单很硬:1.7B 与 8B 两个规模、十一个基准,全面胜过受评的全部扩散语言模型,也胜过对应规模的自回归基线,同时保住并行解码的速度。这与站内 Pivot-SD 的落子思想、Depth as Time 的时间折叠观察连成一条线:计算的位置与剂量,正在成为生成模型的新设计轴。页面未见代码链接。
ASCENT:干完活就地长记性
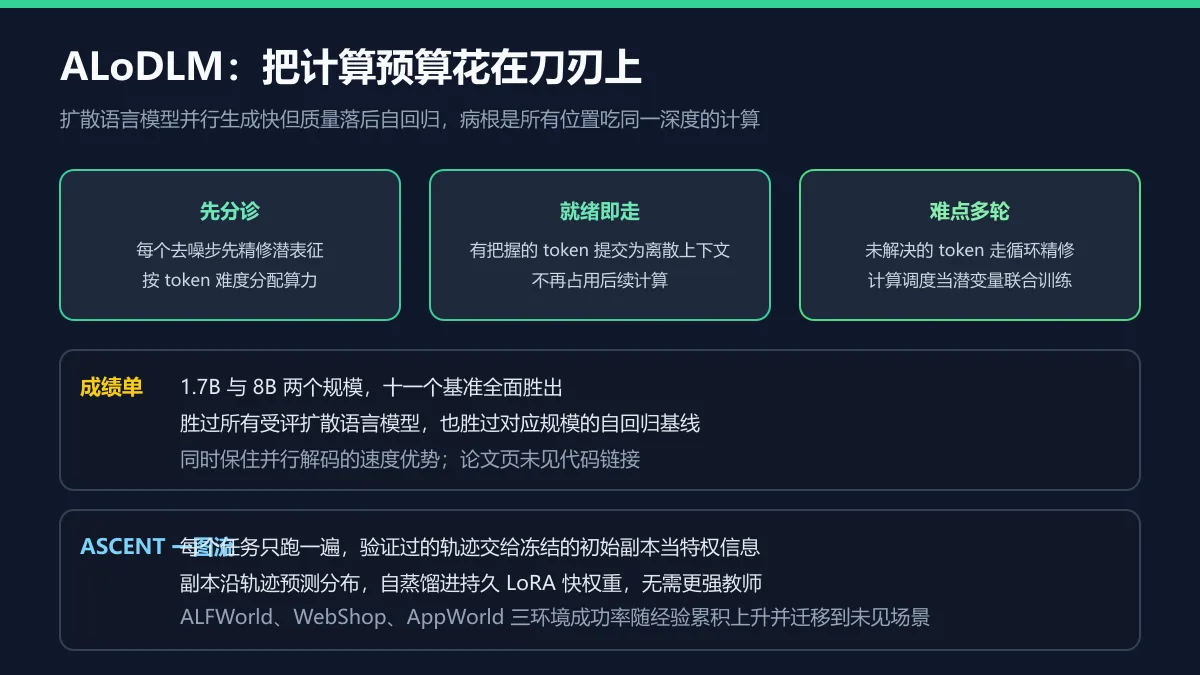
Haodong Lu 与 Dong Gong 的 ASCENT(arXiv:2610.05303,9 赞)研究在线 agent 测试时训练:agent 部署期间每个任务只执行一遍,执行轨迹加验证结果就是唯一学习信号,直接拿来做模仿或强化都会把策略带偏。ASCENT 的做法是自蒸馏:冻结一份初始模型当学生,把验证过的轨迹当特权信息喂给它,让它沿轨迹预测逐 token 分布,再蒸馏进持久化的 LoRA 快权重。全程不需要外部参照或更强的教师,无效动作轮次在训练前剔除。
ALFWorld、WebShop、AppWorld 三个环境里,成功率与交互效率都随经验累积上升,胜过在线适应基线,还能迁移到未见场景。项目页已开放,代码入口以项目页为准。
放在一起读
一篇在生成侧把计算花在难 token 上,一篇在执行侧把经验沉淀成快权重,共同点是拒绝平均主义。对工程团队的启示一致:先分诊,再分配,无论分的是算力还是经验。