字节笔记本
2026年10月6日 · 约 13 分钟读完
AI 工作流专栏 11:结构化输出,让大模型吐 JSON
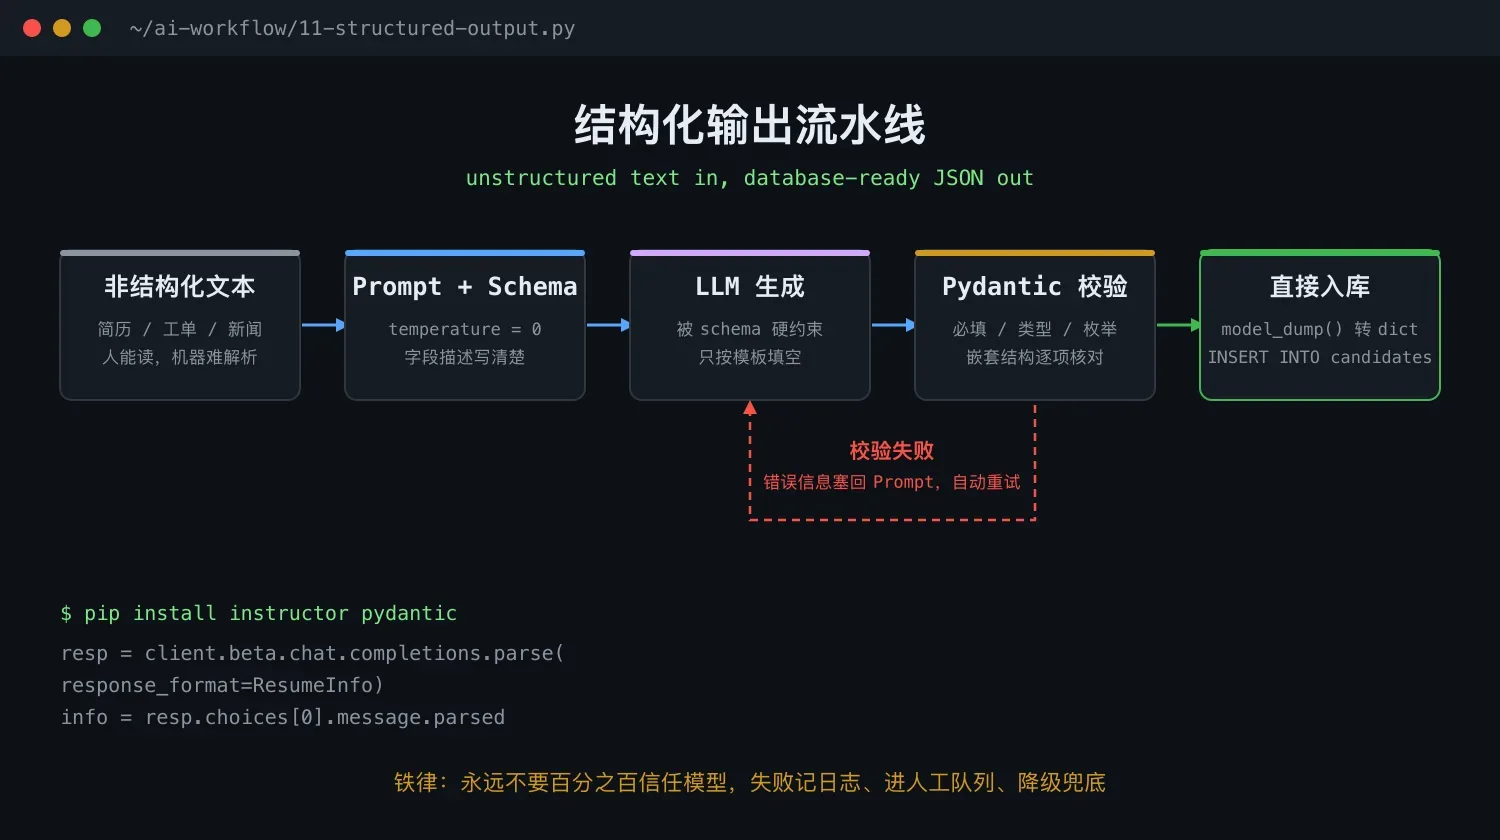
这是「AI 工作流专栏」的一章,这一章解决一个企业里最高频的问题:怎么让大模型把乱糟糟的文字,变成能直接进数据库的整齐数据。
一、为什么必须做结构化输出
企业落地 AI 时,最常见的场景不是陪人聊天,而是批量处理文本:HR 要把几百份格式各异的简历入库,客服要给每天上千条工单自动分类打标签,运营要从几百篇新闻里抽出时间、地点、人物、事件。这些任务的共同痛点只有一个:让大模型按你规定的格式吐数据。
可以拿买菜打比方。菜场摊主手写在塑料袋上的价签,人能读懂,机器解析起来又慢又容易错;超市条形码扫一下,名称、单价、重量直接进收银系统。所谓结构化输出,就是给 AI 的回答贴上条形码,让下游程序能确定性解析,不用再写脆弱的正则去抠字段。
以一段简历文本为例,下游 candidates 表的字段是固定的:name、gender、birth_year、phone、email、city、skills。如果模型回一段「这是一位男性候选人,出生于 1992 年」的自然语言,你还得写正则逐个抠字段;如果模型直接返回:
{
  "name": "张三",
  "gender": "男",
  "birth_year": 1992,
  "city": "杭州",
  "skills": ["Python", "Go", "Kubernetes"]
}
一行 json.loads() 就能入库。但听着简单,做起来至少有四个坑:模型在 JSON 前后加废话,例如「好的,这是你要的 JSON」;用 Markdown 代码块包裹输出,json.loads 直接报错;漏字段或者字段名拼错,你要 birth_year,它给你 birthday;类型不对,你要数字 1992,它给你字符串「1992 年」。
二、方案一:Prompt 里约定只输出 JSON
最朴素的做法,是在提示词里明确要求格式,再附一个输出示例,然后用 json.loads() 解析。多数时候管用,但稳定性靠运气:模型偶尔会多说一句「祝你工作顺利」,程序就崩了。所以必须写兜底清洗代码:
def clean_json(raw: str) -> dict:
    raw = re.sub(r"```(?:json)?", "", raw).strip("` \n")
    start, end = raw.find("{"), raw.rfind("}")
    if start == -1 or end == -1:
        raise ValueError("找不到 JSON 边界")
    return json.loads(raw[start:end + 1])
这个方案零成本,适合一次性脚本和 demo。代价是补丁代码越堆越多,不能上生产。
三、方案二:JSON Mode,保证合法但不保证对
OpenAI 在 chat.completions.create 里提供了 response_format={"type": "json_object"}。开启后,模型保证输出是合法 JSON,不会有废话和裸代码块,但字段名、类型、完整性它一概不管:简历里没写邮箱,它就不返回 email 键,而不是返回 null;phone 可能给你数字而不是字符串。注意使用前提:提示词里必须出现「JSON」这个词,否则 API 会报错。提取任务还务必把 temperature 降到 0,减少输出抖动。
resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": prompt}],
    temperature=0,
    response_format={"type": "json_object"},
)
data = json.loads(resp.choices[0].message.content)
JSON Mode 解决了语法合法,没解决语义对齐,适合 schema 简单、容错高的场景。一旦下游程序严格依赖字段,它就不够了。
四、方案三:Structured Outputs 加 Pydantic,生产首选
2024 年 8 月,OpenAI 推出 Structured Outputs:把 JSON Schema 作为硬约束传给模型,模型被强制按 schema 输出。它的好搭档是 Pydantic,Python 生态最流行的数据校验库:用一个继承 BaseModel 的类描述字段名、类型、约束,OpenAI SDK 会自动把它转成 JSON Schema:
from pydantic import BaseModel, Field

class ResumeInfo(BaseModel):
    name: str = Field(description="候选人姓名")
    gender: str = Field(description="性别:男/女")
    birth_year: int | None = Field(default=None, description="出生年份,没有则填 null")
    phone: str = Field(description="手机号,字符串")
    city: str = Field(description="期望工作城市")
    skills: list[str] = Field(description="技能列表")

resp = client.beta.chat.completions.parse(
    model="gpt-4o",
    messages=messages,
    response_format=ResumeInfo,
)
info = resp.choices[0].message.parsed
print(info.name, info.skills)
几个关键点:方法用 .parse 而不是 .create;response_format 直接传 Pydantic 类;返回的 message.parsed 已经是解析好的 Python 对象,连 json.loads 都省了;每个字段写 Field(description=...),模型更懂这个字段该填什么,准确率明显提升。
Pydantic 还天生支持嵌套和枚举,这是 JSON Mode 管不到的:
class Education(BaseModel):
    school: str
    degree: Literal["大专", "本科", "硕士", "博士"]

class ResumeInfo(BaseModel):
    name: str
    phone: str
    education: list[Education]
模型会递归地把每段教育经历填成嵌套对象,degree 只能四选一。目前 Structured Outputs 支持 gpt-4o、gpt-4o-mini 及更新模型,通义、DeepSeek 等国产模型也已陆续跟进类似能力。
五、方案四:Instructor,校验失败自动重试
方案三还有个小痛点:模型偶尔抽风,把 phone 填成数字,Pydantic 校验直接抛异常,程序崩了。Instructor 库相当于请了个质检员:校验失败时,自动把错误信息塞回给模型让它重填,重试到对为止。
import instructor

client = instructor.from_openai(OpenAI())

class ResumeInfo(BaseModel):
    name: str
    phone: str
    skills: list[str]

    @field_validator("phone")
    @classmethod
    def check_phone(cls, v):
        if not (v.isdigit() and len(v) == 11):
            raise ValueError("phone 必须是 11 位数字")
        return v

info = client.chat.completions.create(
    model="gpt-4o-mini",
    response_model=ResumeInfo,
    messages=[{"role": "user", "content": text}],
    max_retries=3,
)
返回值直接是 ResumeInfo 对象;max_retries=3 表示填错会被打回重填,最多三次;@field_validator 可以挂任意业务规则,比如手机号位数、年龄范围、枚举取值。它还支持 Anthropic、通义、DeepSeek 等多家后端。如果项目已经在用 LangChain,它同样提供 .with_structured_output(PydanticClass),原理类似,不必为此重复引入 Instructor。
六、选型建议与错误处理
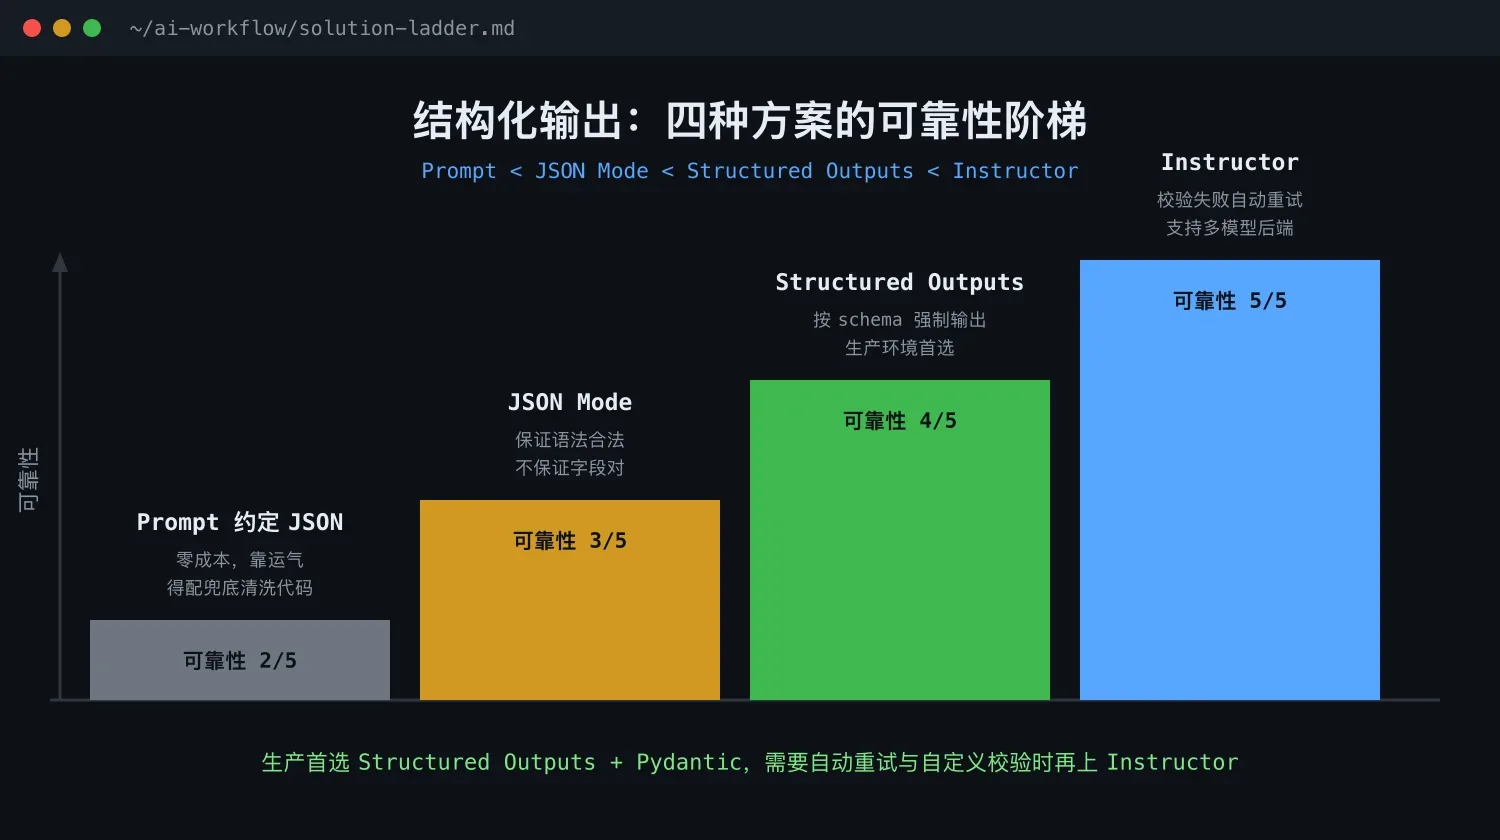
| 方案 | 可靠性 | 适用场景 |
|---|---|---|
| Prompt 约定 JSON | 低 | 一次性脚本、demo |
| JSON Mode | 中 | schema 简单、容错高 |
| Structured Outputs + Pydantic | 高 | 生产环境首选 |
| Instructor / LangChain | 最高 | 需要自动重试与自定义校验 |
工程铁律:永远不要百分之百信任模型。失败类型无非三类:JSON 解析失败、字段缺失、类型不对。前两类靠 schema 里的默认值和重试解决,第三类 Pydantic 会自动报错。真正专业的做法是:失败时记日志、把样本送进人工处理队列、降级兜底,而不是把异常直接抛给用户。
七、批量提取与成本控制
单篇跑通之后就是批量。1000 份简历串行跑,每篇 2 秒要 33 分钟,必须并发;并发太高又会撞 429 限流。标准做法是 asyncio 加 Semaphore 控制并发数,再配上缓存和降级:
SEM = asyncio.Semaphore(5)  # 同时最多 5 个请求,按 RPM 额度调

async def extract_one(text: str):
    async with SEM:
        return await aclient.chat.completions.create(
            model="gpt-4o-mini",
            response_model=ResumeInfo,
            messages=[{"role": "user", "content": text}],
            max_retries=2,
        )
省钱的三个习惯:批量任务用小模型,gpt-4o-mini、deepseek-chat 这类单价比旗舰低一个数量级,提取任务的质量差距通常很小;相同输入按 hash 走缓存,重复简历、重复工单直接返回,不重复花钱;超长文本先摘要再提取,能省一半 token。
八、小结
结构化输出填平的,是大模型自然语言和下游程序之间的格式鸿沟。可靠性阶梯从低到高:Prompt 约定、JSON Mode、Structured Outputs 加 Pydantic、Instructor。schema 用 Pydantic 定义,字段、类型、必填、嵌套、枚举、自定义校验一把抓;永远别全信模型,失败进人工队列;批量场景记住三件套:异步并发、缓存、小模型。给机器吃的数据用 JSON,给人看的报告用 Markdown 表格,导 Excel 就用 JSON 转 pandas。
延伸阅读:OpenAI Structured Outputs 指南(platform.openai.com/docs/guides/structured-outputs)、Pydantic 官方文档(docs.pydantic.dev/latest/)、Instructor 文档(python.useinstructor.com)。