字节笔记本
2026年10月9日 · 约 4 分钟读完
别再让调试作业为占卡的空转任务让路
实验室 GPU 一紧,调试任务就要排几个小时。有人先占着空转作业,等真要调试时再连上去;优先级面板最后也会被刷成全员 HIGH。Allen Institute for AI 基础设施组在 2026-10-09 的博客 Impactful scheduling for GPU clusters 写,他们把按优先级排队换成了 GPU 时间预算、分层公平份额,外加一份时间切片合同。争论从“今晚谁能插队”变成“这个项目该拿多少 GPU 时间”。
集群规模写成数千张 NVIDIA H100、B200、B300,单集群 88 到 1024 卡,服务大约 150 名内部研究员,覆盖大模型与视觉语言模型训练、机器人强化学习仿真,以及科学 agent 的后训练。提交队列里常有 2 到 3 倍于在线容量的 GPU 请求。这篇没有单独开源调度器仓库,事实以这篇博文为准。
先发预算,再谈插队
旧调度允许作业选择不被抢占。每个组有并发 GPU 上限,受保护作业吃满上限,可抢占作业只能吃空闲卡。结果有两头:有人把空转作业停在卡上,因为调试作业排队太久,来不及现场排错;优先级通胀到 100% 的已调度作业都标 HIGH,低优先级再也吃不到时间。值班大量工单花在劝说不可抢占作业从待修机器上挪走。
他们先试过把卡垄断给重点项目,空窗期卡会闲着,另一组还在等。新做法是发 GPU 时间,而不是发固定卡。领导像投资人一样,在作业出现之前按项目影响决定预算。示意图里,项目 A1 对总容量有 35% 的主张,不管别处排了多长队。没有预算资助的请求,就不受抢占保护。HIGH 不再免费。空转作业会烧掉本组预算,占着不如去争更大份额。
公平份额算法本身不新,博文把它接到 2009 年 Hadoop Fair Scheduler,以及今天的 SLURM Fair Tree 和 YARN Fair Scheduler。新的是输入:树按研究项目长,权重是经理定的预算,不是静态配额。调度器看默认 7 天的滑动占用窗口,欠额的组排到超额的组前面。引用里有人写成“像多了 30% 算力”:以前额度没用完就浪费,现在可以在额度之上短时爆发,作业仍能很快排上且不被抢。
占用分两种。计入预算的占用,受最小运行窗口保护;未计入预算的占用从一开始就可抢,用来填满没人对上需求的空档。博文写,上线后 18% 的已交付 GPU 时间属于未计入预算,用来在资助用例还没准备好时保持高占用。
合同、仿真和上线后的数
训练作业可能跑几小时、几天甚至几周。一旦占卡,别人的预算就轮不到。合同要求作业申报最小运行时间:这段时间不被抢,过了就可以重平衡,可恢复作业自动重入队。最小运行时间填 0,表示不计入预算、随时可抢,也不扣配额。上线前他们用仿真试回看窗口和最小运行时间上限,选了 8 小时。仿真里,调试作业 p90 等待从大约 6 小时降到 5 分钟。
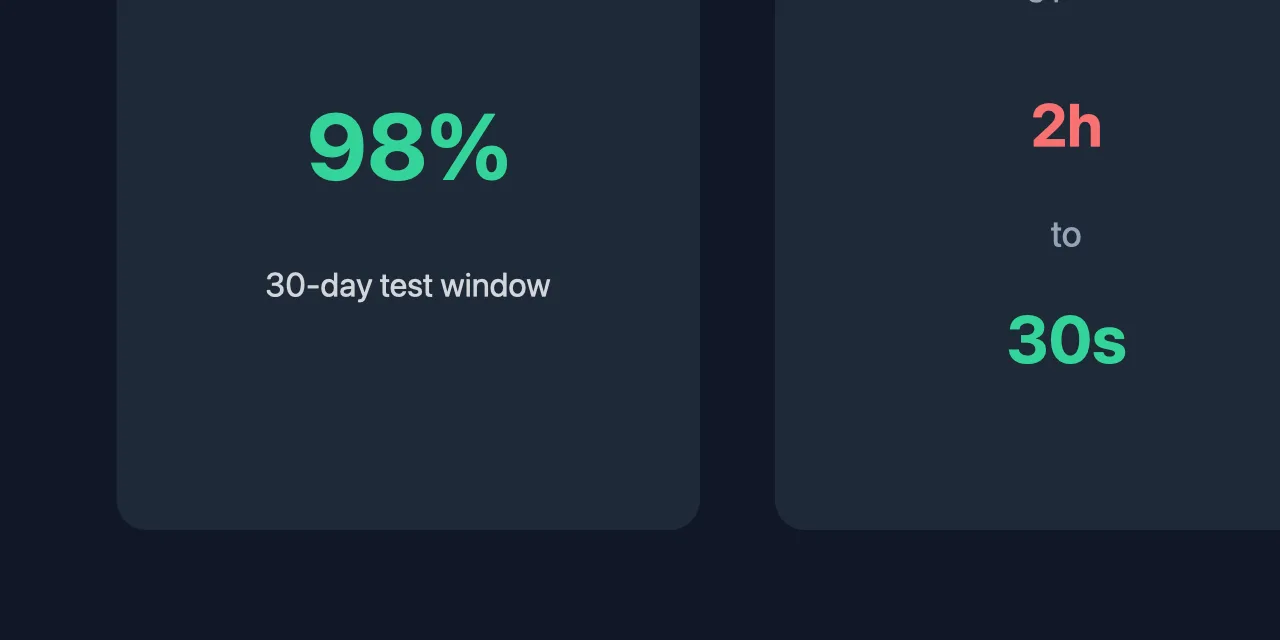
7 月底按集群滚动上线。30 天测试里,按“额度被当小时需求封顶后的应得时间”计,各组拿到应得 GPU 小时的 98%;15 个组里 13 个拿到 95% 以上,最差 90%。占用率在改前改后都是 98%,两端需求都是容量的 2 到 3 倍。真实调试作业 p90 从 2 小时降到 30 秒,比仿真更猛。最大的 H100 集群上,排队中位从 5 分钟降到 24 秒,p90 从 2.8 小时降到 1.8 小时。待修机器会在作业走到最小运行时间后自动排空,需要人介入的维修少了 74%。这些是官方口径,不是本轮复现。
博文也写学习成本比预想高:滚动上线时不同集群行为不一样,旧词“优先级”含义变了,文档不够,要靠现场讲解。读这篇记住三组数:应得小时交付 98%,占用仍 98%;调试 p90 从 2 小时到 30 秒;人肉维修少 74%。没有公开调度器仓库,就谈不上安装步骤。