字节笔记本
2026年10月10日 · 约 3 分钟读完
权重冻住,规则本凭什么还能自己变强
冻结权重的模型还能不能自己变强?Memento 3 的答案是:权重不动,把世界写成一本还能改的规则本,再编译成可执行代码。论文号 2610.11794,2026-10-08 挂到 arXiv,许可写成知识共享署名 4.0。本轮仓库页搜不到公开代码,数字以论文页为准,不是本轮复现。HF 10-09 日榜大约 23 票。
权重冻住,假设还能改
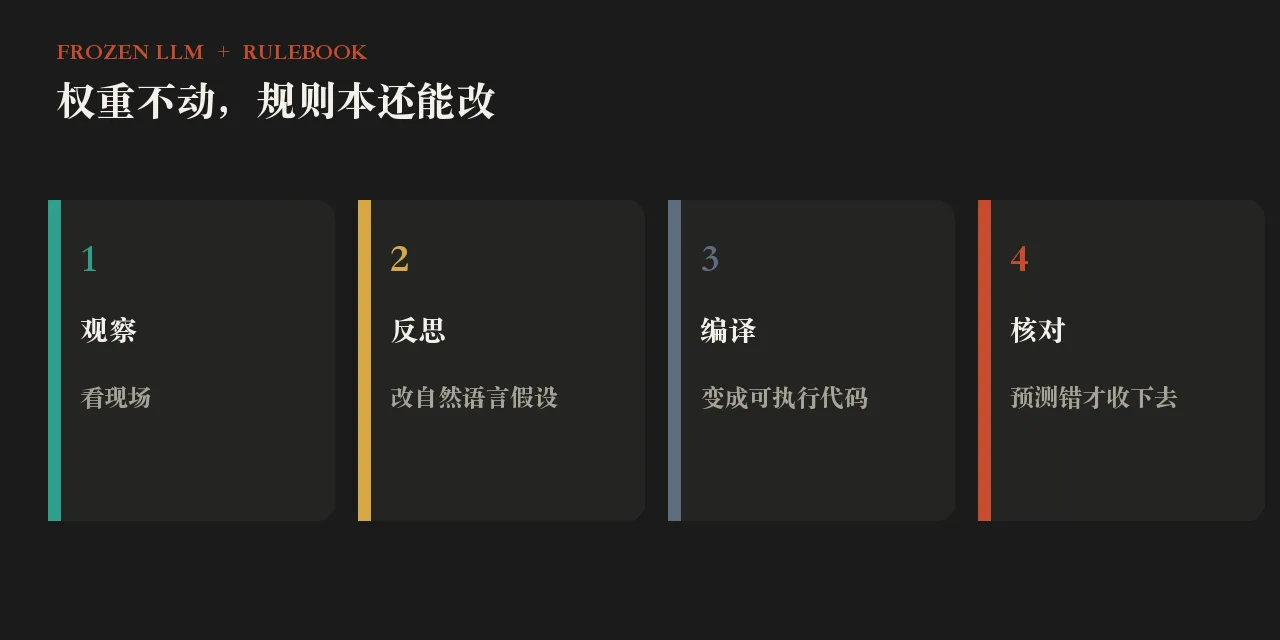
作者把智能体放在观察、反思、改写、编译、核对这一圈里。自然语言规则本当作外部记忆,未知处先写含糊,再编译成预测和规划代码。只有被判定忠实、回放也对得上的改动才会留下。多模型并行时,彼此分享证据,用来决定下一步探哪。论文里的单模型实验写成冻结的 Claude Opus 5,跑在 Claude Code 的更高推理档。
它要解决的不是再微一次参。现场数据少、解释还能互相打架时,靠一本可改的规则本收假设,而不是把新经验焊进权重。编译失败或预测对不上,这一轮就不收。论文把这种写法叫做基于模型的递归自改进:模型本体冻结,改进发生在规则本和它编译出来的代码上。
公开游戏清完了,动作比人少
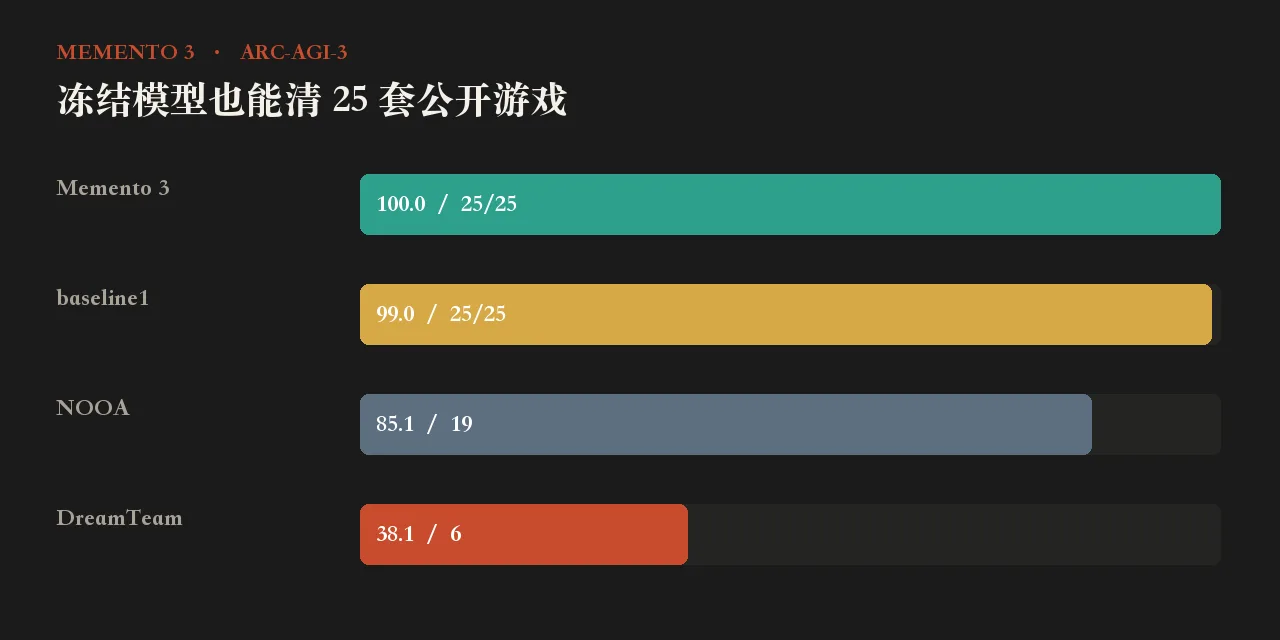
ARC-AGI-3 的 25 套公开游戏、183 关,论文写单模型智能体全部通关,平均 RHAE 100.0,动作数是人类的 44%:7518 对 17135。对照同一底座的标准套件,平均 RHAE 高 59.3。榜上的对照写成 baseline1 99.0 也是 25 套;NOOA 85.1 过 19 套;OPINE-World 78.4 过 20 套;DreamTeam 38.1 过 6 套;Continual Harness 20.5 过 3 套。baseline1 动作 8347,大约是人类的 0.49 倍。三套游戏的规则本消融里,动作 617 对 677,回合 678 对 830。两模型并行在 wa30 上动作 597 对 899,RHAE 都是 100。
乒乓球写成三个开局都是 21 比 0,测试时不再调用大模型。学习用了约 9504 帧。同一套语言接口、没有规则本时写成负 19,随机大约负 20.7。对照里的强化学习方法要到两亿帧量级才摸到 21 分附近,EfficientZero 一类在四十万帧左右到 20 分出头。三个开局的评估动作数写成 3358、4014、5039。这些对照是论文表,不是本轮代训。
没有公开仓,就没法按安装步骤复现。能核对的是论文自己报的通关数、动作比和乒乓球比分。若你要的是可下载检查点,这篇还不满足;若你要看冻结模型靠外部规则本能走多远,数字都在 10-08 那一版里。本轮没有把作者花名册写进正文,也没有把未展开的私有关卡抄进来。论文把二十五套公开游戏写成全部通关,私有关卡没有同期数字,简报也不补。