字节笔记本
2026年10月9日 · 约 8 分钟读完
消费级卡上的持续学习,不该再等机房配额
把持续学习说成必须上机房,这句话这半年被重复太多次。有人在消费级 8GB 显存笔记本上,从零训一个按字节读写的语言模型,权重落在磁盘上按页换进显存。volotat/mini-AGI 本轮 API 核到 1221 星、199 个 fork,许可证 MIT。仓库 2026-09-19 创建,最近推送 2026-10-08。作者自己把名字写成半玩笑,README 也写明这是玩具级模型,不要指望前沿能力。
它不是又一个指令微调小模型。语料按字节流进来,同一条 train.py read 既训练也生成。专家池可以涨、可以剪。README 把一步快照写成第 750109 步:核心大约 8.27M,路由大约 0.20M,专家大约 1242.6M(395 个、每个大约 3.15M),合计大约 1251.0M。一次前向大约激活 345M。卡上只常驻 32 个专家,大约 109M 参数,所以显存跟着常驻槽走,不跟着专家池走。权重目录本身就是模型,换页从磁盘把专家调进来。
消费级卡上,专家池为什么能涨
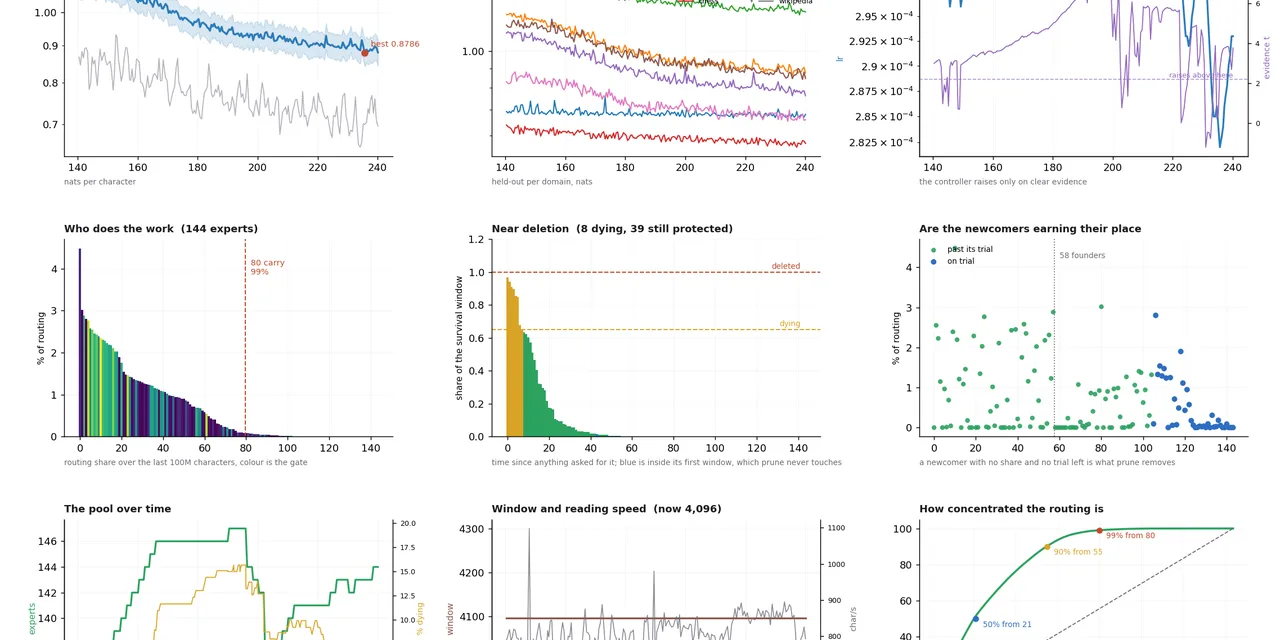
架构写在 README 里:词表 265(256 个字节加 9 个标记),上下文 4096,RMSNorm、RoPE、SwiGLU、SDPA。前面 2 个 prelude 块,后面 1 个循环块最多展开 24 次,单字节最多 26 次计算。注意力 8 头、每头 64 维。循环块每次从 32 个卡上槽里取 Top-8 专家,整池在磁盘上。深度自适应走 PonderNet,隐状态不解码,用适配器把 h 和 x 并回去。README 还写了换页、增长和剪枝三套机制:专家不够就扩池,用不上就剪,显存不够就从磁盘换。assets 目录里有仪表盘、训练进度、缩放曲线、层结构、交错探针和集中探针几张图,本轮只用前两张官方图,不把柱高再读成新数字。
硬件表按窗口 4096、读 2048、卡上 32 专家来写。RTX 3070 Laptop 8GB、bf16:读大约 2042 字符/秒,写 28.4,显存 5.1 GiB。RX 6800 XT 16GB 在 fp32 下读 1388、写 34.7、显存 10.1 GiB;同一张卡改 bf16 读掉到 301。CPU 一条是 Ryzen 9 9900X、bf16,读 186。当前大约 355 个专家时,3070 读速大约 1310 字符/秒。NVIDIA 30 系以上;AMD 走 ROCm,RDNA2 常常只能 fp32。这些是仓库表,不是本轮复现。
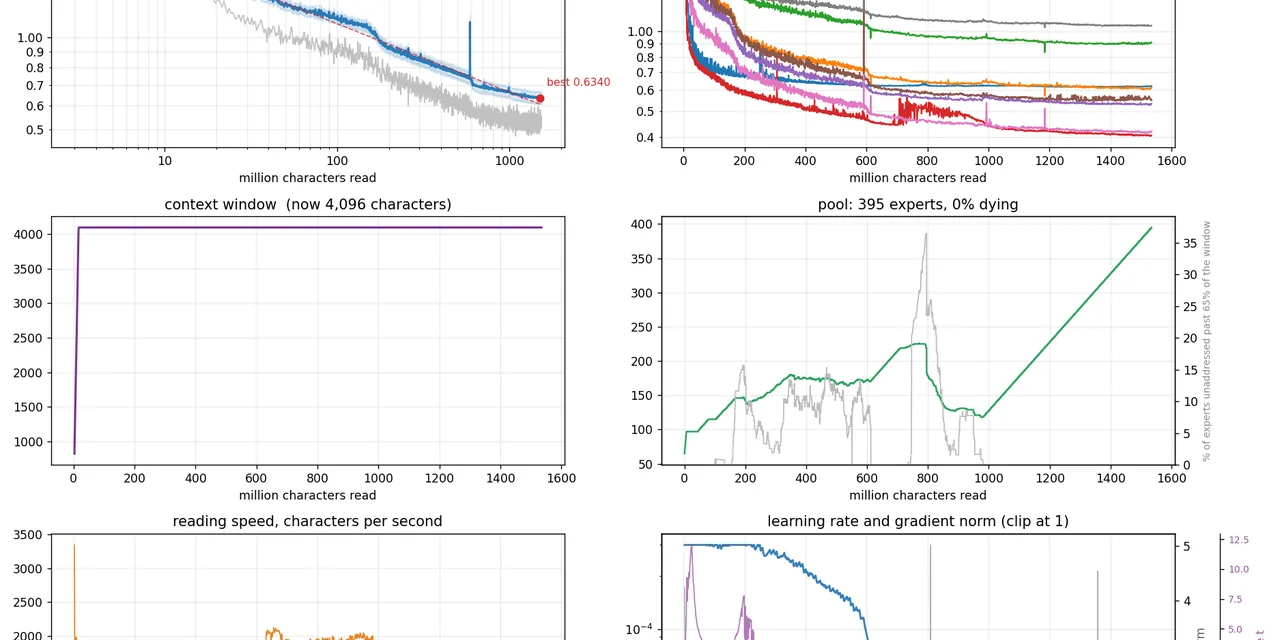
评测写在 1535.0M 字符、395 专家的快照上。八个主题的留出损失 0.6379 ± 0.0287 nats/字符,折 0.9203 bits/byte;训练损失 0.5267 nats / 0.7599 bits/byte。分主题 nats:chess 0.406、stories 0.420、code 0.534、reasoning 0.552、chat 0.617、arithmetic 0.621、chat_hermes 0.906、wikipedia 1.047。日志里最好的留出是 1505.9M 字符时的 0.6340 nats。仓库写,大约要再降 0.03 nats 才谈得上实质性差别。README 把当前训练写成还在第一遍语料上,最终权重没公开。这是最坏情况实验,不是推荐用法。
本机怎么接到这条字节流
依赖按 README 装 torch、numpy、pyyaml、matplotlib,可选再装 flask、chess、zstandard、datasets、scipy。PyTorch 自己对上 CUDA 或 ROCm。语料用 python3 -m corpora all 组。训练和读文件是同一条入口。
git clone https://github.com/volotat/mini-AGI.git
cd mini-AGI
pip install torch numpy pyyaml matplotlib
pip install flask chess zstandard datasets scipy
python3 -m corpora all
python3 train.py read data/train --save --weights-dir weights --held-out data/val --sample-every 10
python3 serve.py --port 8080
读自己的笔记或源码,把路径交给 train.py read。--save 才会落盘;默认学习率 5e-5。仓库举例是 python3 train.py read 后跟本地目录,再加 --passes 3 --save。服务入口是 serve.py,默认端口 8080。本轮没有在本机跑通训练,命令按 README 抄。仓库还写了 replication 目录和 corpora 目录,语料不是现成聊天日志,要自己组。config.yaml 大约一万字节,训练超参集中在这里,不要把默认学习率理解成已经调好的生产配置。train.py 本身超过十万字节,serve.py 大约四万字节,入口少、实现并不薄。
PG19 测试写成 2.091 BPB,明确标成分布外。缩放拟合 L ∝ D^-0.223,R² 0.98。持续学习探针把主干学习率设成专家的 0.1 倍:整段灌 PG19,旧域大约多 0.13 nats;关掉保护大约多 1.26 nats。交错灌大约保住 100.13%。探针权重另放在 Hugging Face 的 Volotat/mini-AGI-cl-replication-weights,428.2M 字符、174 专家。主快照卡片是 Volotat/mini-AGI-undertrained,标注 2026-10-01,README 写最终权重还没公开。本轮打开卡片时没有模型卡正文,下载数也没显示,不要把卡片当第二份论文。
CUDA 专家调度非确定性,仓库写相邻两次大约差 0.014。样本仍会乱码。增长、剪枝和换页都加复杂度,完整训一轮是天到周。README 明确写:小玩具级,不要指望前沿能力;名字是半玩笑,不是当前能力声明。仓库给了软件引用键,本轮不把个人姓名写进正文。LICENSE 文件是 MIT。
读这篇记住四件事。一,这是按字节的持续学习实验,不是通用助手。二,数字绑在 8GB 消费卡、常驻 32 专家和当前池规模上。三,许可证 MIT,主权重还是 undertrained 快照,探针权重另开。四,站内谈过的边缘决策模型走单次前向不吐 token,和这条字节流不是同一条路,不要并成一篇。Lobsters 今日有人贴过这仓库,标成 8GB 显存上从零、batch-1 的持续学习,和 README 对上。Burn 0.22.0 同日也在 Lobsters,那是 Rust 张量库发版,不并进这篇。OpenArm 是开源机械臂,星数更高,但和字节级语言模型不是同一条产品线。Hacker News 今日首页的 Once 缓存命令行只有几十星,也不并进来凑数。GitHub 日榜和周榜上的大仓本轮大多已写过,不拿来垫这篇。