字节笔记本
2026年10月9日 · 约 3 分钟读完
多图深研断在锚点上,这张证据图凭什么补上
多图和视频的深研,难处不在再搜一轮网页,而在局部锚点之间的依赖会断。一组作者在 2026-10-08 放出 OneSearch-VL,论文号 2610.12419。仓库 appletea233/OneSearch-VL,Apache-2.0,本轮看到 14 星、1 次提交。底座写成 Qwen3-VL-8B,先监督再强化学习,权重、数据和训练评测代码都开了。数字是官方自报,不是本轮复现。
证据先连成图,再让模型走
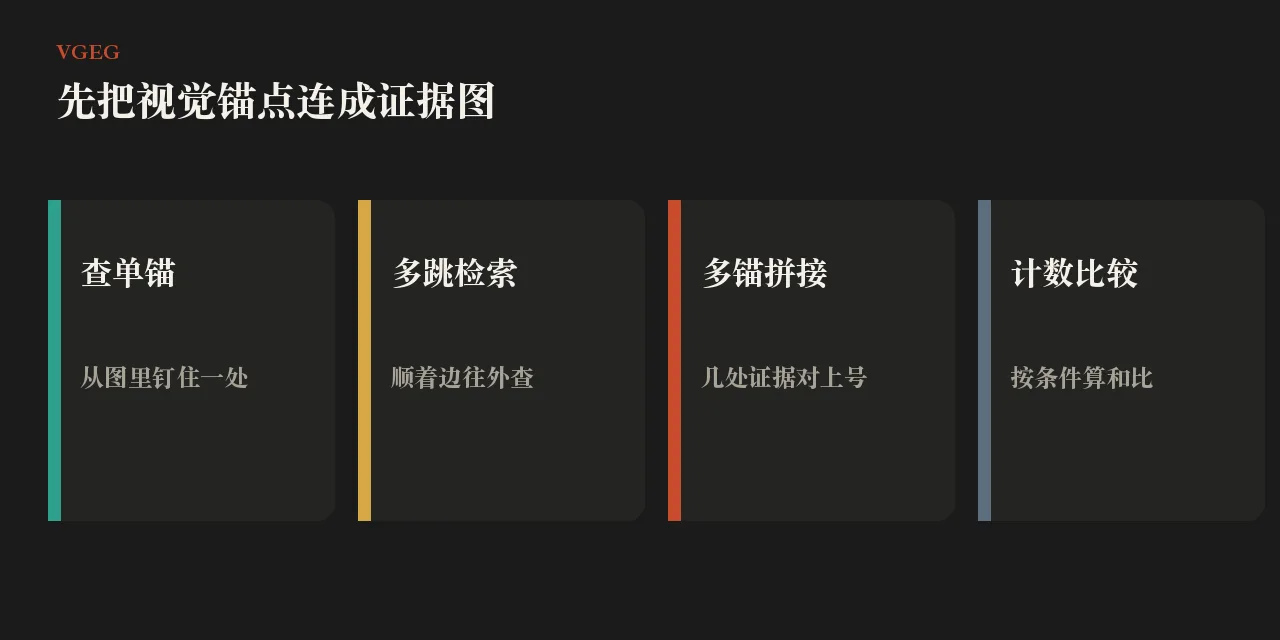
他们把视觉锚点、检索步骤和事实拼装收进一张 Visually Grounded Evidence Graph。同一套引用贯穿造数据、训练信号和打分,避免图上的点在后半段对不上号。监督集约十一万条专家轨迹,强化学习约一万题。新评测按图操作拆开:单锚查找、多跳检索、带知识的计数、多锚拼接、算术和比较。多图集 301 题,视频集 307 题。HF 论文页还写了从约 250 万条视频收到七万,评测共 608 题。
视觉塔和投影在监督阶段冻住。强化学习写成 RLOO,每个提示 8 条回复,批 256,201 步。监督学习率 1e-5,8 个周期,DeepSpeed ZeRO-2。推理要额外依赖、ffmpeg 和一块 GPU,环境变量分模型、检索和裁判三套。安装按仓库拆成三套环境:监督要 Python 3.11 以上、PyTorch、CUDA、DeepSpeed;强化学习还写了 SGLang 0.5.5 和 PyTorch 2.8.0。本轮没有代训,也没有改他们的检索后端。
增量写在新题上,旧榜只抬一点
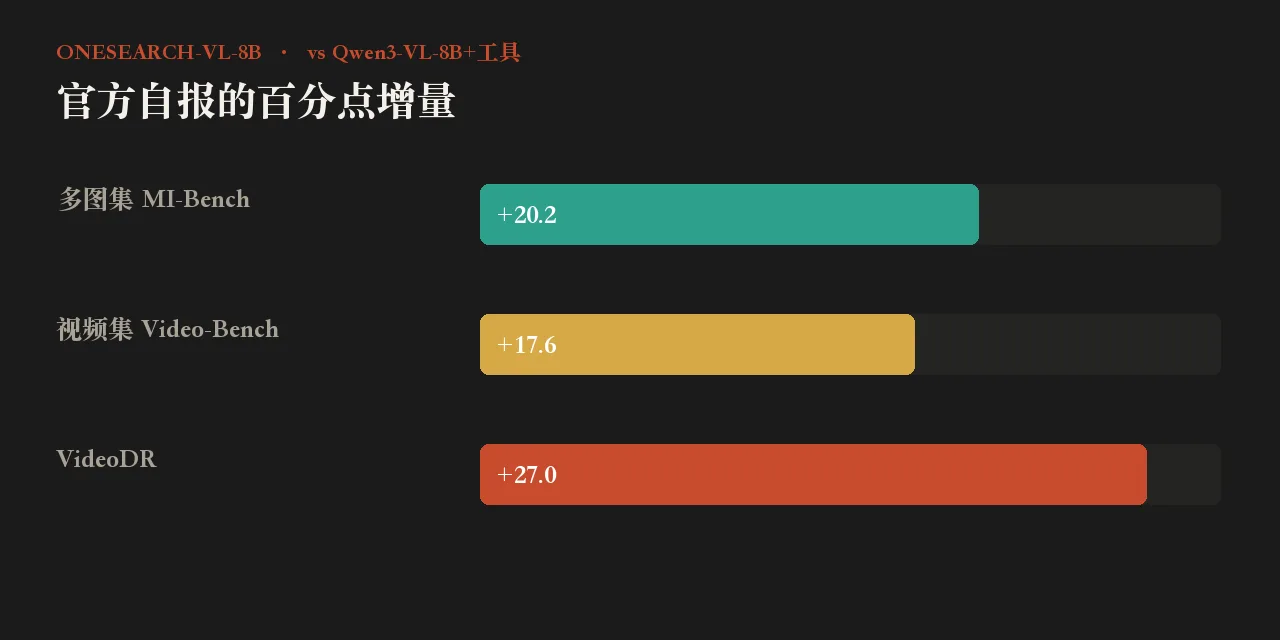
相对带工具的 Qwen3-VL-8B,官方写多图集高 20.2 个百分点,视频集高 17.6,VideoDR 高 27.0。七个单图旧榜平均 58.3,只比 OpenSearch-VL-8B 高 1.7。完整的可追踪奖励在消融里再加 3.8。监督平均从 55.8 接到完整奖励后的 61.1。这些对照都是论文口径。旧榜几乎不动、新榜跳得大,更像是题面和训练信号被图结构对齐了,而不是底座突然更会看图。
仓库只有一次提交,热度在论文页不在星数。若只是要一个会搜图的聊天模型,这套图结构用不上;若答案必须指回画面上的某一处,先把边留住,再比谁更会写结语。HF 论文卡也可以当封面看,和仓库页不是同一张图。作者名单以论文页为准,HF 卡片少写了一人,本轮不把花名册写进正文。
和站点里那些只报单图检索的稿不同,这篇把视频帧选择也写进同一套图操作。评测按操作拆开,而不是丢一个总分就结束。本轮没有代跑那 608 题,也没有核对检索接口的密钥配置。若要复现,先按仓库把三套环境分开装,再决定是只跑推理还是把监督和强化学习整条链路拉起来。本轮只核论文页和仓库页,不把未展开的排行榜格子抄进正文。