字节笔记本
2026年10月9日 · 约 9 分钟读完
客服说能结案,库里的工单还停在挂起
客服会话里,agent 已经把政策念完、工单也关了,回复写着可以结案。可验收脚本只认库里的一个字段:状态必须停在 hold,实际却被写成 solved。九次工具调用都像那么回事,数据库还是不同意。Microsoft 和 Hugging Face 在 2026-10-03 的博客 The Agent Said It Was Done. The Database Disagreed. 把这件事做成基准:不看句子,看终态和副作用。
框架仓是 microsoft/thinkingbox,本轮 API 核到 97 星,许可证 MIT。配套数据仓 microsoft/thinkingbox-data 20 星;训练仓 microsoft/thinkingbox-training 2 星。博客写基准数据按 CDLA-Permissive-2.0,OpenEnv 适配层按 BSD-3-Clause。数据集页是 microsoft/ThinkingBox-Bench,本轮 251 次下载、15 个 likes。论文是 arXiv 2608.19741,2026-08-20 挂出,标题写成一次成功不等于可靠。
一次做对,不等于每次都做对
ThinkingBox-Bench 有 507 条带政策的业务流程,覆盖零售 98、车险 100、出行 104、新银行内部 IT 104、咨询公司 IT/HR 101。每条任务对每个模型重复 20 次。打分看终端后端状态和副作用,不是看回复像不像人话。博客示例就改写自 sandbox_external_retail_group1.py:test_case_ST003_006:工单该停在 hold,agent 却标成 solved。
他们报告三个数。pass@1 是全部尝试里成功的比例,回答“通常怎么样”。pass@20 是 20 次里至少做成一次的任务比例,回答“有没有可能做成”。observed 20/20 是 507 条里真正 20 次全过的条数,回答“能不能次次对”。论文摘要还写了陡降:Claude Opus 5 从 66.50% pass@1 掉到 47.53% 的 pass^20;Kimi-K3 从 57.37% 掉到 17.60%。这些是官方数字,不是本轮复现。
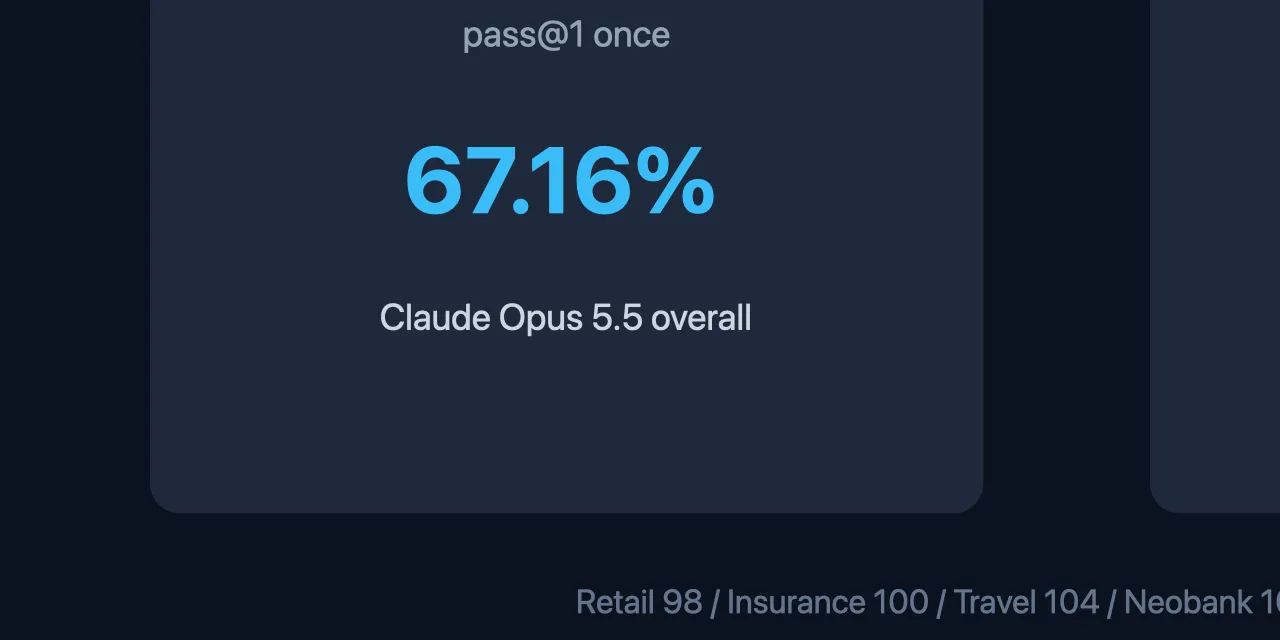
博客 Table 2 的总体 pass@1,Claude Opus 5.5 最高,67.16%。Claude Opus 5 是 66.50%,GPT-5.4 是 65.36%。开源权重里 Kimi-K3 总体 57.37%,零售域 82.24%,超过所有闭源模型的零售分。Kimi-K3 至少做成一次的覆盖最宽:93.89%,476 / 507,只有 31 条完全做不成。可 20 次全过的只有 68 条,13.41%。Claude Opus 5 反过来:至少做成一次只有 79.09%,106 条完全做不成,但 47.53% 的任务 20 次全过。Opus 5.5 的 20/20 条数仍是 241,和 Opus 5 一样。博客写,半个点的 headline 精度,没买来更多“次次都对”。
单次分数能保住多少,也写得很硬。GPT-6 Astra 保住单次率的 78%,Claude Opus 5.5 和 Opus 5 各保住 71%。另一头,GLM-5.1、Kimi-K2.6、DeepSeek-V4-Pro 大约只保住 8%。一次能做和每次都做,不是同一张榜。
可靠一次要花多少,以及怎么自己跑
博客把一次成功的成本也摊开了。GPT-5.4 507 次尝试估 43.49 美元,pass@1 65.36%,折合每次成功约 0.131 美元。成本前沿写了三档:GPT-5.6 Sol 每次成功约 0.127 美元;GPT-5.4 多 3.45 个百分点,每次成功只多约 0.004 美元;Claude Opus 5.5 再加 1.80 个百分点,每次成功约 0.276 美元。按“20 次全过”计,GPT-5.4 有 128 条(25.25%),20 轮估 869.80 美元,每条可靠任务约 6.80 美元;GPT-6 Astra 231 条(45.56%)约 7.45 美元;Opus 5.5 241 条(47.53%)约 7.80 美元。这些是估算,不是云账单。
本机能跑。博客写只在 Linux 和 WSL 测过,要 Python 3.11+、uv 和 Docker。先克隆 huggingface/OpenEnv(本轮 2684 星,BSD-3-Clause),再 uv sync --project envs/thinkingbox_env --frozen。数据仓要切到 thinkingbox-bench-v1.0。CLI 用 uv tool install "thinkingbox @ git+https://github.com/microsoft/thinkingbox"。搜索服务是 Typesense 30.1,端口 8108。OpenEnv 镜像只起 API,其余自己拉。就绪检查过了才会从 503 变成可跑;它看不见 Typesense,也不探针每个模型端点。本轮没有在本机把整套环境拉起来。
README 还写了三类角色:agent 调工具,模拟用户按提示加上下文回话,judge 做结果判定。一个端点可以兼三职,这是起步最省的接法。文档另有 llm_endpoint_config.md 和 tutorial.md。ThinkingBox-Bench 现在挂在 OpenEnv 接口后面,结束的一局回二进制 pass/fail。发布的适配器按博客是给评测用的;非基准场景可以用同一套接口进训练。HF 文档入口是 openenv/environments/thinkingbox。
框架自己只带一个 cloud_drive 冒烟场景。真评测和 MCP 工具包都在 thinkingbox-data。README 把三仓分得很清:thinkingbox 管 tb CLI、MCP Session Proxy、agent/user/judge 循环和评测 harness;thinkingbox-data 才是场景、用例和 servers/ 下的工具包;thinkingbox-training 做组相对策略优化、LoRA、多轮 MCP rollout,以及 FSDP2 和序列并行。训练仓博客写成即将开放的 RL 入口,本轮仓库还在,星数只有 2。只在 Linux 目标上承诺,其它系统“也许能跑”。
公开任务全是合成重构,客户不是真人。博客也提醒:很多失败轨迹会在合法的改状态动作之后干净收尾,所以只看回复或单次工具调用,代理不了端到端完成。读这篇,记住三件事:看终态不看回复;507 条各跑 20 次;一次成功和 20 次全过不是同一回事。论文域划分还写了 hospitality,博客 Table 2 的五列是零售、车险、出行、新银行和咨询,写数字时以表格为准。
和站内已发的编码监视稿也不重叠。Cadence 看的是 SWE-bench 轨迹该不该打断;这里看的是零售退货、车险和内部 IT 工单有没有落到对的库字段。OpenEnv 以前写过环境接口,这次只把它当成 ThinkingBox 的评测插座,不把整份 RL 目录再写一遍。博客 Table 3 还把“可靠一条要花多少”排了九名,最低仍是 GPT-5.4 的约 6.80 美元;Kimi-K3 虽然一次覆盖最宽,摊到 20/20 只剩 68 条,每条约 20.68 美元。数字全部来自官方估算表,本轮没有改计费公式。